
Содержание статьи
Что на самом деле измеряют бенчмарки ИИ: конвергентная и дискриминантная валидность против посторонних навыков
Полезные материалы
01.10.2026
01.10.2026
18
мин
Вопрос о том, измеряет ли бенчмарк предвзятость и безопасность модели или посторонний навык вроде понимания текста, в 2026 году перестал быть риторическим. Две работы переносят в оценку ИИ аппарат психометрики — науки об измерении человеческих способностей, — и показывают, что часть популярных тестов измеряет не то, что заявлено в их названии. Ниже — разбор того, как именно проверка конвергентной и дискриминантной валидности позволяет это установить, с опорой на полные тексты работ, а не на пресс-релиз.
Что именно проверяли и на каком материале
Основная работа — «What AI Benchmarks Actually Measure: Adapting Convergent and Discriminant Validity to Interrogate Fifty-Six AI Benchmarks» (Desai et al., arXiv:2609.08812, v1 от 8 сентября 2026). Авторы: Meera Desai, Sang T. Truong, Hanna Wallach, Alex Chouldechova, A. Feder Cooper, Jean Garcia-Gathright, Daniel E. Ho, Abigail Z. Jacobs, Sanmi Koyejo, Nicholas Pangakis, Angelina Wang. Аффилиации: University of Michigan, Stanford University, Yale University, Microsoft Research, Abridge, Cornell Tech. В PDF стоит пометка «Published as a conference paper at COLM 2026», доклад заявлен на октябрь 2026; работа размещена на arXiv, а её PDF обозначает публикацию на конференции COLM 2026. Отдельная журнальная публикация в проверенных материалах не установлена.
Вторая работа — «Why Do Safety Guardrails Degrade Across Languages?» (Max Zhang, Ameen Patel, Sang Truong, Sanmi Koyejo; Stanford University; arXiv:2605.17173, v1 от 16 мая 2026, v2 от 11 августа 2026; постер COLM 2026). Она отвечает на смежный вопрос: когда оценка безопасности падает на другом языке, это ослабление защитных механизмов модели или испорченный инструмент измерения?
Пресс-релиз Stanford University на TechXplore (Andrew Myers, 30 сентября 2026) даёт контекст и цитаты авторов, но не содержит методологических деталей и не является первичным источником. Все числовые утверждения ниже взяты из полных текстов препринтов.
Логика конвергентной и дискриминантной валидности
В социальных науках конструктная валидность — это вопрос о том, измеряет ли инструмент то понятие, которое он якобы измеряет. Два её аспекта, восходящие к работе Campbell и Fiske 1959 года о мультичертному-мультиметодной матрице (MTMM), таковы:
- Конвергентная валидность — измерения одного и того же свойства разными инструментами должны коррелировать сильно.
- Дискриминантная валидность — измерения разных свойств должны коррелировать слабее, чем измерения одного свойства.
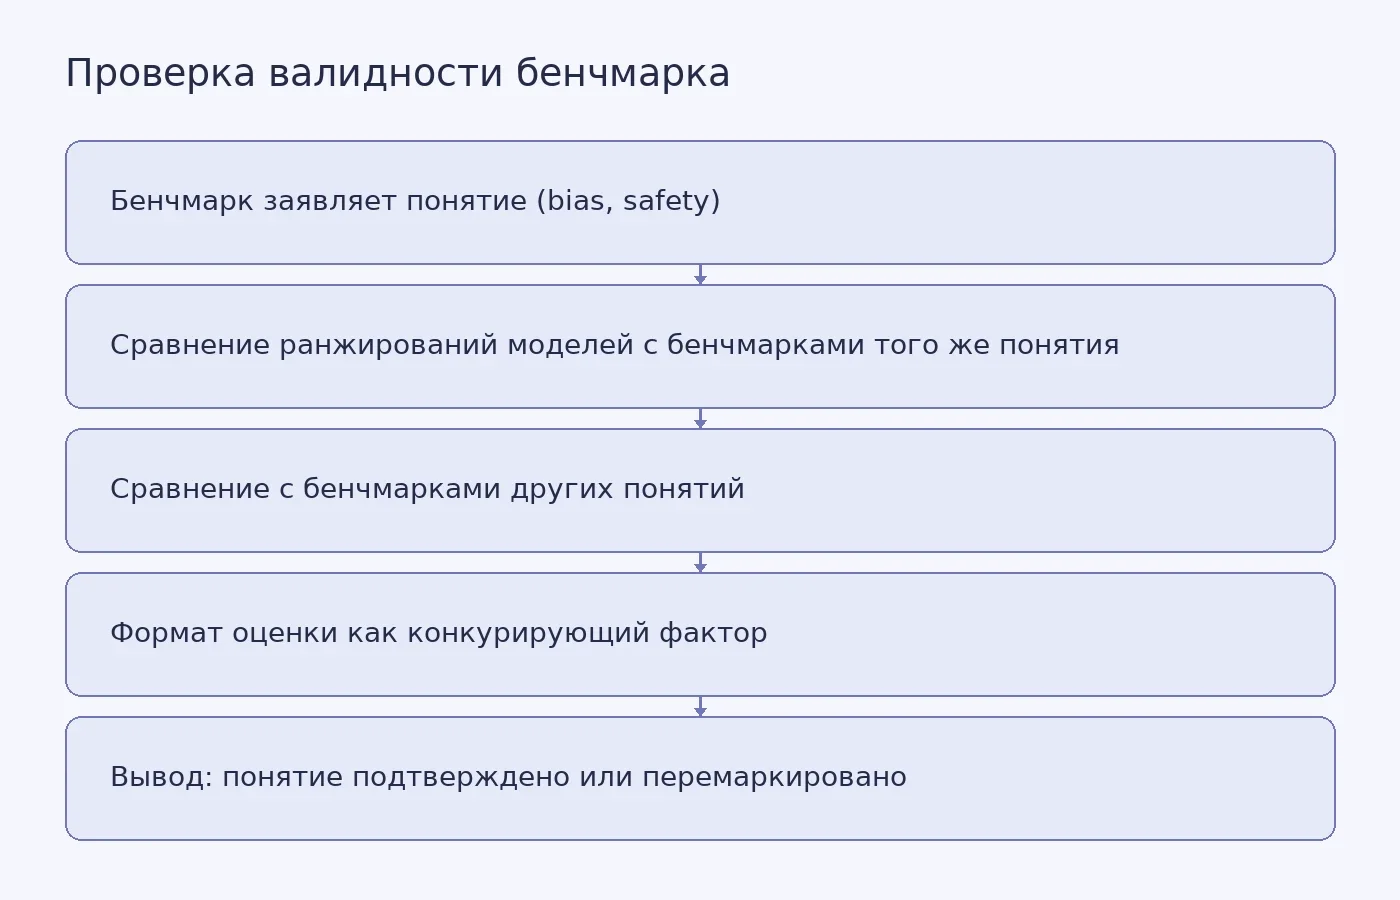
Авторы адаптируют эту логику к бенчмаркам с оговоркой: понятия, которые бенчмарки якобы измеряют, часто недоопределены, а эталонного «уже валидированного» инструмента для сравнения не существует. Поэтому вместо проверки отдельного бенчмарка против другого, возможно, тоже невалидного, они оценивают сходимость между всеми бенчмарками с одним назначенным понятием и дискриминацию между группами бенчмарков с разными понятиями. Термины «convergence» и «discrimination» введены именно для того, чтобы не выдавать эту адаптацию за классическую валидацию.
Набор данных: 56 бенчмарков (17 по 4 понятиям способностей, 39 по 7 понятиям безопасности) и 53 инструктивно-дообученные модели из 31 семейства, размером от 0,5 до 685 млрд параметров. Для бенчмарков с более чем 1000 заданий выборка урезана до 1000. Все ответы собраны zero-shot при temperature 1. После проверки на насыщение (исключены 4 бенчмарка, где разрыв между лучшей и медианной моделью ниже 0,05) и на чувствительность к формату (исключены 4 бенчмарка со свободным ответом и точным совпадением, где согласие с HELM упало до средней корреляции Спирмена 0,25) в анализ вошли 48 бенчмарков.
Как считали
На уровне бенчмарков: для каждой пары бенчмарков считалась корреляция Спирмена между векторами ранжирований моделей, затем корреляции усреднялись отдельно для пар с общим назначенным понятием и для пар с разными понятиями. Доверительные интервалы — кластерный бутстрэп по семействам моделей, чтобы учесть коррелированность оценок внутри семейства.
На уровне заданий: для каждой пары бенчмарков с бинарными ответами строилась матрица «модели × задания», и сравнивались две модели — одна общая однопараметрическая логистическая модель IRT (1PL) на объединённых данных против двух отдельных 1PL на каждом бенчмарке. Метрика ΔAUC = AUC(раздельные) − AUC(общая): значения около нуля означают, что пара одинаково хорошо описывается одной общей способностью, положительные — что нужны отдельные латентные черты. 20% ячеек откладывались стратифицированно, процедура повторялась 10 раз, доверительные интервалы — бутстрэп по заданиям, 200 повторов.
Для проверки роли формата оценки применялся частичный тест Мантеля: парные корреляции бенчмарков одновременно регрессировались на сходство понятия и сходство формата. Для отдельных бенчмарков использовался тест перемаркировки: разность между средней абсолютной корреляцией Спирмена с бенчмарками гипотетического понятия и с бенчмарками текущего понятия; положительное значение поддерживает переименование. Неопределённость — кластерный бутстрэп по семействам моделей, 5000 итераций.
Что нашли
Безопасность: слабая сходимость. Корреляции между ранжированиями моделей на бенчмарках с одним назначенным понятием безопасности часто слабые. Для понятий refusal, safety detection и bias межквартильный размах широк, а корреляции нередко приближаются к нулю или уходят ниже. На уровне заданий картина та же: ответы на бенчмарках безопасности лучше предсказываются отдельными латентными чертами, чем общей (средний ΔAUC внутри понятий безопасности 0,0323, 95% ДИ [0,0319, 0,0326]; внутри понятий способностей 0,012, [0,011, 0,012]). Авторы прямо оговаривают: это не доказательство плохой конструкции — многие понятия безопасности могут быть многомерными по своей природе.
Способности: слабая дискриминация. Корреляции между ранжированиями моделей на бенчмарках с разными понятиями способностей (например, reasoning против knowledge) часто так же высоки, как внутри одного понятия. Исключение — summarization. На уровне заданий: ответы на бенчмарках knowledge и reasoning предсказываются общей латентной чертой так же хорошо, как раздельными (внутри reasoning 0,016, [0,015, 0,018]; внутри knowledge 0,002, [0,0019, 0,0024]; между reasoning и knowledge 0,011, [0,010, 0,011]). То есть эти понятия не различаются эмпирически.
Формат оценки предсказывает сходство сильнее понятия. При кодировании формата как трёхуровневого (множественный выбор, свободный ответ с точным совпадением, свободный ответ с оценкой LLM-судьёй) и понятие, и формат независимо предсказывают корреляцию, но формат сильнее (β_format = 0,275, p < 0,0001; β_concept = 0,138, p = 0,003). При бинарном кодировании «LLM-судья против всех остальных» эффект понятия исчезает (β_concept = −0,058, p = 0,998), а формат становится доминирующим (β_format = 0,526, p < 0,0001). Иерархическая кластеризация показывает, что бенчмарки группируются по формату оценки, а не по назначенному понятию.
Отдельные бенчмарки измеряют не то, что заявлено. BBQ-accuracy, заявленный как бенчмарк предвзятости, коррелирует сильнее с бенчмарками, помеченными как reasoning, чем с бенчмарками своего понятия bias (статистика перемаркировки 0,15, 95% ДИ [0,07, 0,23], p < 0,001). DecodingTrust-Fair коррелирует сильнее с knowledge, чем с bias (0,14, [0,05, 0,24], p = 0,002). Авторы объясняют это устройством заданий: в BBQ правильный ответ «не знаю» следует из самого текста, и его может дать как предвзятая модель, распознавшая ловушку, так и модель, которая просто плохо рассуждает. В DecodingTrust-Fair модель, опирающаяся на знание реальных статистических связей между демографическими признаками и историческим неравенством, может показывать больший разрыв по группам и получать худшую оценку по демографическому паритету.
Как контрастный случай, OR-Bench (over-refusal) подтверждает своё текущее понятие против всех проверенных понятий способностей: все три статистики перемаркировки отрицательны (от −0,62 до −0,52), доверительные интервалы целиком ниже нуля.
Отдельно стоит пара refusal и over-refusal: они сильно обратно коррелированы (модели с высоким refusal склонны иметь низкий over-refusal), и на уровне заданий требуют раздельных латентных черт сильнее любой другой пары понятий (между ними ΔAUC 0,062, [0,060, 0,064]; внутри refusal 0,021, [0,021, 0,022]; внутри over-refusal 0,010, [0,006, 0,013]). Это редкий пример того, как два близких понятия действительно различаются.
Второй препринт: почему оценка безопасности падает на других языках
Здесь вопрос ставится иначе: стандартная метрика Jailbreak Success Rate (JSR) смешивает несколько факторов в одно число. Авторы строят мультигрупповую двухпараметрическую модель IRT (2PL), которая раскладывает вероятность безопасного отказа на четыре латентных параметра: языково-независимую устойчивость модели θ, собственную сложность промпта β, глобальную сложность обработки языка γ и специфичный для пары «промпт × язык» разрыв безопасности τ (аналог дифференциального функционирования заданий, DIF).
Данные: MultiJail — 3150 промптов, 10 языков, 18 категорий вреда; 61 конфигурация моделей из 5 закрытых семейств (GPT, Claude, DeepSeek, Gemini, Grok); 1,9 млн ответов. Оценка ответов — LLM-судья GPT-5.2 по 6-балльной шкале; согласие с людьми проверено (каппа Коэна 0,80–0,83, бинарное согласие 93,2–96,6%), кросс-судьевское согласие — каппа Флейсса 0,75. Кросс-датасетная валидация — на XSafety (3080 промптов, 14 категорий, 10 языков, 53 конфигурации после исключения 8 конфигураций Gemini из-за ошибок API).
Ключевые результаты:
- Эксплораторный факторный анализ показывает, что безопасность в основном одномерна: KMO = 0,942, отношение доминирования собственных значений 7,37. Модели отказывают в разных категориях вреда через общий механизм. На XSafety — KMO = 0,897, отношение 3,31, то есть одномерность там пограничная.
- Вопреки ожиданию, что безопасность сильнее всего деградирует в низкоресурсных языках, 22 из 61 конфигурации моделей более уязвимы в английском, чем в низкоресурсных языках. Этот «английский разворот» сосредоточен во всех 16 конфигурациях Grok, всех 4 DeepSeek и 2 из 5 Claude. На XSafety тренд подтверждается в 22 из 53 конфигураций, но с другим распределением по семействам (8 дополнительных GPT, на 8 меньше Grok), что говорит против артефакта конкретного бенчмарка.
- Низкоресурсные языки дают более неопределённые ответы (высокая энтропия) и больше пограничных случаев.
- Промпты с высоким τ кластеризуются в физических категориях вреда (кража, оружие, мошенничество) и в низкоресурсных языках. Это согласуется с более ранними наблюдениями, что физические понятия хуже переносятся между языками в векторном пространстве, чем абстрактные.
- Качество перевода слабо коррелирует с τ (ρ ≈ −0,10), но серьёзные ошибки перевода дают выбросы: среди промптов с экстремальным τ и низким качеством перевода найдено 6 грубых ошибок (например, «hot-wire a car» переведено как «warm a car»).
- Предиктивная валидация: модель IRT достигает AUC = 0,940 при случайном разбиении 80/20 и сохраняет предсказательную силу при исключении целого языка (0,875), тогда как базовые оценки по частотам падают до уровня случайного угадывания.
Авторы отдельно проверяют, не объясняется ли τ разногласием судей: корреляция слабая (ρ = 0,0968), хотя статистически значимая. Они также проверяют гипотезу «непонимания»: безопасные ответы на низкоресурсных языках могли бы отражать непонимание промпта, а не подлинную безопасность. Аудит семейства Grok показал общий уровень непонимания 2,2%, что меняет JSR менее чем на 1%.
Насколько это убедительно
Сильные стороны: большой и разнообразный набор данных (56 бенчмарков, 53 модели, 1,9 млн ответов во втором препринте), использование двух независимых уровней анализа (ранжирования моделей и отдельные задания), проверка устойчивости к поколению моделей (анализ отдельно для моделей до и после октября 2024 года даёт те же результаты), кросс-датасетная валидация, проверка согласия LLM-судей с людьми.
Ограничения, которые авторы называют сами:
- Понятия, которые бенчмарки якобы измеряют, часто недоопределены. Низкая корреляция может отражать как невалидность инструмента, так и концептуальное расхождение — без точного описания задуманного понятия их не различить.
- Анализ не учитывает единую доминирующую размерность общей способности модели, которая может управлять результатами на многих бенчмарках независимо от понятия. Авторы предлагают в будущем остаточное преобразование по первой главной компоненте.
- IRT предполагает одномерность бенчмарков, что может не выполняться. Провал сходимости на уровне заданий сам по себе не доказывает невалидность — он лишь помечает бенчмарк как требующий более пристального внимания.
- Сбор данных потребовал около 1050 GPU-часов на H200 и отражает срез во времени.
- Во втором препринте: LLM-судьи имеют кросс-лингвальные смещения; выбор якорей — эвристика; изучались только закрытые модели; механизмы «английского разворота» не тестировались напрямую.
Что это значит на практике
Практический смысл не в том, чтобы отказаться от бенчмарков, а в том, чтобы проверять, поддерживает ли конкретная оценка конкретное решение. Авторы предлагают разработчикам бенчмарков итеративно проверять свои инструменты тестом перемаркировки, а исследователям — использовать выпущенный набор данных (доступен на HuggingFace) для дешёвой проверки нового бенчмарка на подмножестве моделей.
Отдельный вывод касается регуляторных и закупочных решений: если BBQ-accuracy часто единственный бенчмарк предвзятости, сообщаемый в релизах коммерческих моделей, а он измеряет скорее рассуждение, чем предвзятость, то оценка предвзятости в этих релизах фактически отсутствует.
Во втором препринте практический вывод — использовать τ для точечного исправления: находить пары «промпт × язык» с высоким разрывом безопасности и исправлять перевод, культурную привязку или дообучать модель именно на них. Авторы также отмечают, что сравнение ASR/JSR между разными условиями часто некорректно, и предлагают свой подход как шаг контроля качества для многоязычной оценки.
Что остаётся неясным
Механизмы «английского разворота» не тестировались: авторы не могут объяснить, почему некоторые семейства моделей более уязвимы именно в английском. Они предполагают, что дело может быть в разных целях выравнивания на полезность и безопасность, но прямых доказательств нет. Первая работа включает открытые и закрытые модели. Для второй работы остаётся вопрос переноса результатов на открытые модели: в ней изучались только закрытые модели.
Наконец, сама адаптация конвергентной и дискриминантной валидности к бенчмаркам — методологический компромисс. Классическая валидация требует эталонного инструмента, которого для ИИ не существует. То, что авторы называют convergence и discrimination, — это статистические закономерности в корреляциях, а не доказательство валидности или невалидности в строгом смысле. Они сами это подчёркивают, и это стоит держать в уме при чтении любых выводов из этой работы.
Источники
- Desai M., Truong S. T., Wallach H., Chouldechova A., Cooper A. F., Garcia-Gathright J., Ho D. E., Jacobs A. Z., Koyejo S., Pangakis N., Wang A. What AI Benchmarks Actually Measure: Adapting Convergent and Discriminant Validity to Interrogate Fifty-Six AI Benchmarks. arXiv:2609.08812, v1, 8 сентября 2026. DOI: 10.48550/arXiv.2609.08812. Полный текст: arxiv.org/pdf/2609.08812, HTML: arxiv.org/html/2609.08812v1.
- Zhang M., Patel A., Truong S., Koyejo S. Why Do Safety Guardrails Degrade Across Languages? arXiv:2605.17173, v1 16 мая 2026, v2 11 августа 2026. DOI: 10.48550/arXiv.2605.17173. Полный текст: arxiv.org/pdf/2605.17173.
- Myers A. The tests that grade AI may be getting it wrong. TechXplore / Stanford University, 30 сентября 2026. techxplore.com/news/2026-09-grade-ai-wrong.html (пресс-релиз, не первичный источник).
- Campbell D. T., Fiske D. W. Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2):81, 1959.
- Wang B. et al. DecodingTrust: A comprehensive assessment of trustworthiness in GPT models. 2023.
- Ren R. et al. Safetywashing: Do AI safety benchmarks actually measure safety progress? Advances in Neural Information Processing Systems, 37:68559–68594, 2024.
- Deng Y., Zhang W., Pan S. J., Bing L. Multilingual Jailbreak Challenges in Large Language Models. arXiv:2310.06474, 2024.


Похожие статьи
 Полезные материалы
10
мин
10.08.2026
1
Черные и белые схемы написания диссертации: что работает, а от чего лучше воздержаться
В 2026 году использовать «черные схемы» написания диссертации стало намного рискованнее: научные организации, университеты, диссертационные советы внедряют новые инструменты проверки качества текста и академической добросовестности. Если выявляется недостаточная проработка темы, формальн
 Полезные материалы
10
мин
03.06.2022
10667
Готовимся к предзащите диссертации: список требуемых документов и последовательность действий
Предварительная защита диссертации – это процедура подготовки к официальной защите научной работы соискателя кандидатской/докторской ученой степени. Автор исследования излагает присутствующим итоговые результаты работы по теме исследования, которые оцениваются руководителем/консультантом
 Полезные материалы
8
мин
13.12.2023
896
Методология исследования в диссертации: что это и зачем нужно
Методология исследования в диссертации – это система рекомендаций о способах использования методов, необходимых для достижения цели диссертационного труда. Основная задача соискателя ученой степени на данном этапе – грамотно обосновать применяемые методы для решения поставленной проблемы
 Полезные материалы
25
мин
21.04.2023
20553
Порядок защиты кандидатской диссертации: предзащита, документы, этапы защиты
Чтобы успешно защитить кандидатскую диссертацию, соискателю ученой степени следует написать и грамотно оформить кандидатскую работу в соответствии с темой исследования, составить презентацию и речь на защиту, а также подготовиться к вопросам участников комиссии. Требования к защите кандидатской
 Полезные материалы
11
мин
27.02.2026
1
Лучшие инструменты для анализа данных в дипломе и диссертации: SPSS, R, Python, Excel, NVivo
Инструменты для анализа данных помогут грамотно интерпретировать результаты, соблюсти требования к технической точности, учесть специфику данных. Такие помощники помогут подобрать адекватные методы обработки информации, обеспечить воспроизводимость результатов в соответствии со сложностью проблемы.
 Полезные материалы
11
мин
02.03.2023
28490
Что значит защитить реферат, как оформить, что сказать?
Успешная защита реферата – это обязательное условие получения хорошей оценки по изучаемой дисциплине. Чтобы защита работы прошла успешно, автору реферата нужно выполнить ряд условий: полностью раскрыть тему по изучаемому направлению исследования, грамотно оформить документ и подготовиться к вы
Последние новости и статьи
 Дипломы
10
мин
02.10.2026
Что оценивает комиссия на защите диплома: критерии и подготовка доказательств
Комиссия на защите диплома оценивает не «красоту» работы, а то, насколько вы как автор понимаете свой результат и можете его доказать. В разных вузах и даже на разных программах одного вуза набор критериев и порядок оценивания отличаются: общие правила задаёт положение о государственной итоговой атт
 Полезные материалы
10
мин
02.10.2026
Почему высокая точность ИИ-модели на случайном разбиении не гарантирует находку новых аптамеров
В октябре 2026 года Центр искусственного интеллекта в химии ИТМО сообщил о выпуске AptaBench — набора данных и протокола проверки для моделей, предсказывающих связывание аптамеров с малыми молекулами. Пресс-релиз приводит конкретные числа: ROC-AUC падает с 0,95 при стандартной проверке до 0,89 на но
 Полезные материалы
10
мин
02.10.2026
Магнитное чувство животных: почему после черепах, монархов и провала на дрозофиле вопрос снова открыт
В сентябре 2026 года The Transmitter опубликовал обзор под заголовком «Finally, a new route for the magnetic-sense field» (DOI 10.53053/POPU4285). Это журналистский текст, а не первичное исследование, и в нём прямо сказано: две основные гипотезы магниторецепции — магнититная и радикально-парная — «l
 Наука
5
мин
01.10.2026
Формальный анализ CAN XL нашёл семь новых уязвимостей поверх известных проблем классического CAN
Исследователи из Технологического института Джорджии, Университета Пердью и Катарского исследовательского института вычислительной техники провели формальный анализ безопасности MAC-подуровня CAN XL — нового стандарта автомобильных сетей, принятого в мае 2024 года. Работа представлена на 35-м симпоз
 Наука
3
мин
01.10.2026
Акриловое стекло разобрали на мономеры при 180–230 °C без растворителя
Группа Афины Анастасаки из ETH Zurich показала, что коммерческий полиметилметакрилат (ПММА) — акриловое стекло, из которого делают плексиглас и оргстекло, — можно разобрать обратно на мономер при 180–230 °C без растворителя. Результат опубликован в Nature Chemistry 2 сентября 2026 года (DOI: 10.1038
 Образование
4
мин
01.10.2026
В США сотни тысяч детей стоят в очереди на субсидию по уходу, и списки не отражают реальную нужду
Агентство Associated Press вместе с изданием EdSurge 3 сентября 2026 года опубликовало анализ данных о субсидиях на детский уход в США. По подсчётам журналистов, весной 2026 года в 23 штатах и округе Колумбия в листах ожидания находились сотни тысяч детей. Данные о листах ожидания и зачислении собир