
Содержание статьи
Почему высокая точность ИИ-модели на случайном разбиении не гарантирует находку новых аптамеров
Полезные материалы
02.10.2026
02.10.2026
10
мин
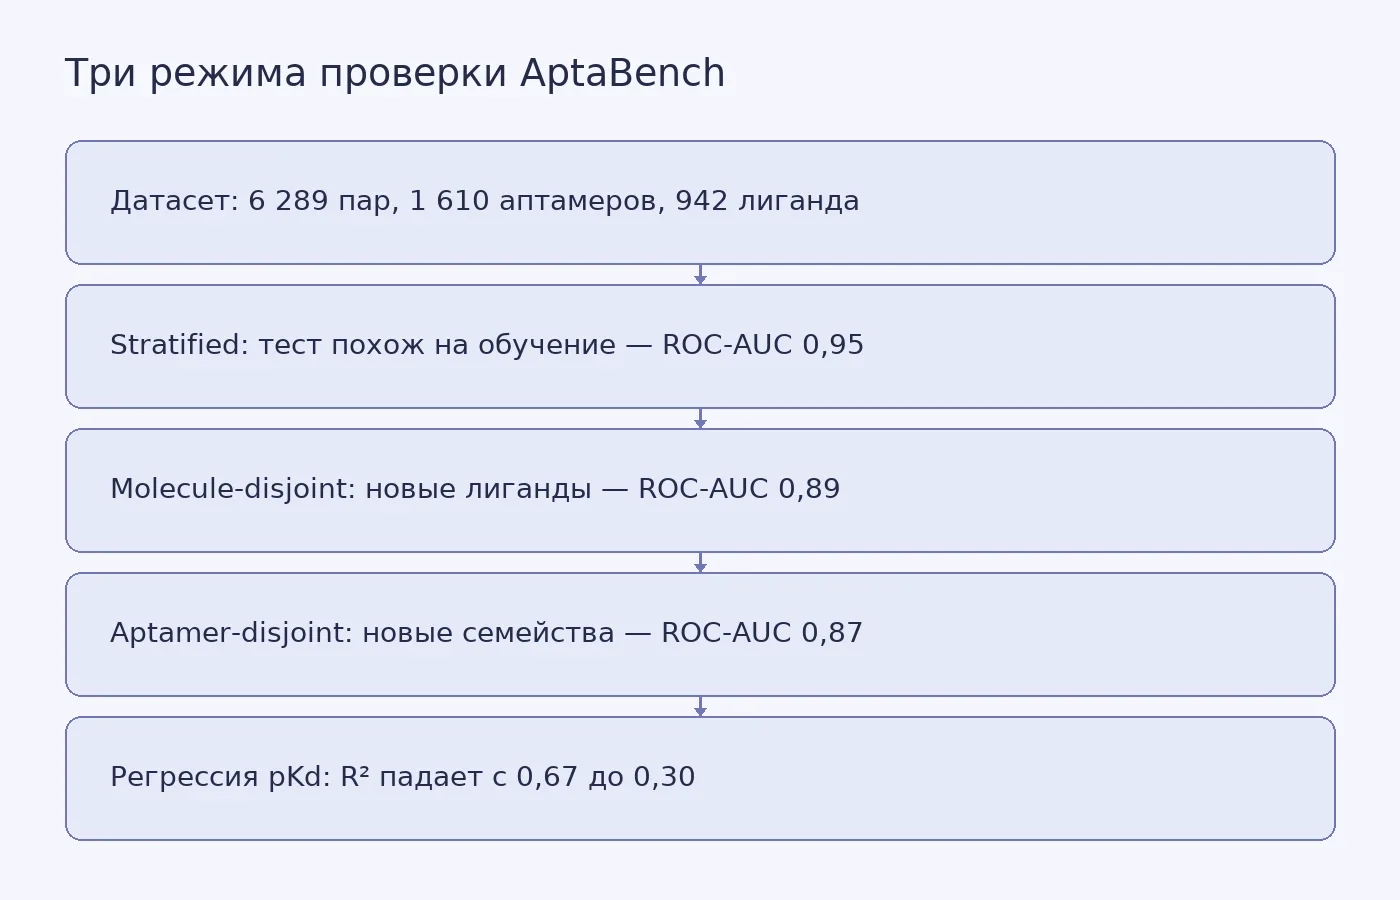
В октябре 2026 года Центр искусственного интеллекта в химии ИТМО сообщил о выпуске AptaBench — набора данных и протокола проверки для моделей, предсказывающих связывание аптамеров с малыми молекулами. Пресс-релиз приводит конкретные числа: ROC-AUC падает с 0,95 при стандартной проверке до 0,89 на новых молекулах и до 0,87 на новых семействах аптамеров, а R² при прогнозировании силы связывания — примерно с 0,67 до 0,30. Эти цифры и есть ответ на вопрос, вынесенный в заголовок: модель, которая отлично различает связывающиеся и несвязывающиеся пары на случайно перемешанных данных, может заметно хуже работать с молекулой или последовательностью, которых в обучении не было.
Разбираться в этом стоит не из любви к метрикам. Аптамеры — короткие одноцепочечные ДНК или РНК, которые избирательно связываются с мишенями; их используют в диагностике, биосенсорах и как основу лекарственных кандидатов. Подбор аптамера под конкретную мишень — это перебор: синтезировать и проверить десятки и сотни вариантов дорого. Компьютерная модель, которая заранее отсеивает заведомо слабые последовательности, экономит лабораторные ресурсы. Но если модель обучена на парах, где аптамеры и лиганды похожи друг на друга, а применяется к принципиально новому химическому классу, экономия оборачивается ложной уверенностью.
Что именно собрано в AptaBench
Карточка датасета на Hugging Face (репозиторий aptabench-anonymous/AptaBench_dataset, открыт для анонимного рецензирования) описывает состав так: 6 289 записей пар «аптамер — лиганд», 1 610 уникальных последовательностей аптамеров, 942 уникальных лиганда, восемь курированных источников. Поля таблицы: тип аптамера (ДНК или РНК), стандартизованная последовательность, канонический SMILES лиганда, значение pKd там, где оно есть, бинарная метка активности (1 — активен, 0 — неактивен или слабо связывается), буфер или условия эксперимента, источник публикации. Поддерживаются две задачи: классификация связывания и регрессия аффинности по pKd.
Ключевое отличие от многих предыдущих наборов — происхождение отрицательных примеров. В карточке прямо сказано: неактивные метки основаны на зарегистрированных наблюдениях несвязывания или низкой аффинности, а не на синтетическом случайном скрещивании последовательностей и молекул. Пресс-релиз ИТМО приводит тот же аргумент и подкрепляет его числом: PR-AUC вырос с 0,75 при искусственных отрицательных примерах до 0,95 при экспериментальных. Это не украшение — это указание на то, что модель, обученная на выдуманных «не-парах», учится отличать не химию связывания, а статистические артефакты генератора отрицательных примеров.
Три режима проверки и в чём между ними разница
Пресс-релиз описывает три способа проверки: случайное разбиение данных на обучающую и тестовую части; проверка на новых молекулах, отличающихся по химическому строению от обучающих; проверка на новых семействах аптамеров, то есть последовательностях, близких вариантов которых не было в обучении. Карточка датасета называет те же три протокола иначе и точнее: stratified (in-distribution, пятифолдовая стратифицированная разбивка), molecule-disjoint (лиганды из тестового фолда не встречаются в соответствующем обучающем) и aptamer-disjoint (последовательности аптамеров из тестового фолда не встречаются в обучающем).
Здесь есть расхождение, которое стоит зафиксировать. Пресс-релиз называет первый режим «данные случайным образом разделяются» — так обычно и говорят. Карточка датасета формулирует строже: это стратифицированное in-distribution разбиение, и отдельно предупреждает, что случайные разбиения не рекомендуются, поскольку могут завышать оценку обобщения, позволяя одним и тем же лигандам или последовательностям аптамеров встречаться и в обучении, и в отложенной части. Разница не косметическая: стратификация сохраняет пропорции классов, но всё равно оставляет в тесте объекты, похожие на обучающие. Именно поэтому метрики на таком разбиении выглядят хорошо и именно поэтому они мало говорят о переносимости.
Логика molecule-disjoint и aptamer-disjoint проста: убрать из обучения всё, что могло бы дать модели «подсказку» через узнавание знакомого лиганда или знакомой последовательности. Если модель после этого всё ещё различает связывающиеся пары — значит, она выучила что-то переносимое, а не запомнила конкретные комбинации.
Что показывают числа
По пресс-релизу, ROC-AUC составляет 0,95 при стандартной проверке, 0,89 при работе с молекулами нового химического строения и 0,87 при новых семействах аптамеров. Падение на 0,06 и 0,08 выглядит умеренным, но его нужно читать вместе с падением R²: с примерно 0,67 до 0,30. R² — метрика регрессии силы связывания; падение более чем вдвое означает, что модель, неплохо предсказывающая pKd для знакомых классов соединений, на новых молекулах объясняет лишь около трети разброса экспериментальных значений. Для практической задачи — отобрать кандидатов для лабораторной проверки — это принципиально разные уровни надёжности.
Отдельно стоит отметить, что числа приведены только в пресс-релизе. Первичная статья AptaBench на момент подготовки этого обзора недоступна: нет PDF, нет DOI, нет текста статьи NeurIPS. Карточка датасета подтверждает состав, поля, три протокола и рекомендуемые метрики (для классификации — ROC-AUC, PR-AUC, accuracy, balanced accuracy, F1, precision, recall; для регрессии — R², RMSE, MAE, корреляция Спирмена), но не содержит ни описания архитектур моделей, ни гиперпараметров, ни процедуры обучения, ни статистики сравнения. Поэтому числа ROC-AUC и R² следует воспринимать как заявленные авторами, а не как независимо воспроизведённые.
Что здесь убедительно, а что нет
Убедительна сама конструкция проверки. Идея, что случайное или стратифицированное разбиение завышает оценку, когда в данных есть повторяющиеся лиганды и близкие последовательности, — не новая в машинном обучении, но её редко применяют к задаче «аптамер — малая молекула». Датасет с фиксированными leakage-aware сплитами и явным предупреждением против случайных разбиений — это полезный инструмент, даже если конкретные числа окажутся скорректированы после рецензирования.
Менее убедительны детали. Не указано, на каких именно моделях получены метрики и как они выбраны; пресс-релиз упоминает «базовые модели для сравнения», но не описывает их. Не указано, как определялись «новые семейства аптамеров» — по какому критерию последовательности считались принадлежащими к одному семейству и как проводилась кластеризация. Не указан объём выборки для регрессии pKd: сколько записей имеют количественную аффинность, а не только бинарную метку. Без этого нельзя оценить, насколько устойчивы числа R². Наконец, карточка датасета анонимна: авторы, аффилиации и ссылки скрыты до завершения рецензирования, что нормально для двойного слепого процесса, но означает, что проверить происхождение данных по независимым публикациям пока нельзя.
Есть и расхождение в статусе работы. Русская версия пресс-релиза говорит «работа принята на конференцию NeurIPS 2026 в трек Evaluations & Datasets», английская — «accepted for the NeuroIPS conference» с опечаткой в названии. Первичного подтверждения принятия нет; это заявление университета, а не решение программного комитета, доступное для проверки.
Зачем это нужно за пределами одной задачи
Вопрос, который поднимает AptaBench, шире аптамеров. Любая модель, предсказывающая взаимодействие молекул, — будь то докинг, предсказание аффинности белок-лиганд или генерация новых соединений — сталкивается с одной и той же проблемой: тестовая выборка, собранная из тех же источников и тех же химических пространств, что и обучающая, измеряет не способность к обобщению, а способность к интерполяции. Разница между интерполяцией и экстраполяцией в химии особенно резка, потому что свойства соединений меняются нелинейно при переходе к новому скаффолду.
Практический вывод из трёх режимов AptaBench не в том, что модели плохи, а в том, что одну цифру точности нельзя переносить на все сценарии использования. Если задача — отобрать варианты среди уже изученного класса молекул, стандартная проверка может быть адекватной. Если задача — найти аптамер под новую мишень или проверить последовательность, сгенерированную другой моделью, нужен molecule-disjoint или aptamer-disjoint протокол, и ожидаемые метрики будут ниже. Авторы AptaBench планируют использовать набор при разработке алгоритмов генерации аптамеров — то есть ровно в том сценарии, где проверка на новых объектах критична.
Наша интерпретация: ценность AptaBench сейчас в первую очередь методологическая. Он задаёт планку — фиксированные сплиты, экспериментально обоснованные отрицательные примеры, явный отказ от случайных разбиений, — и заставляет сравнивать модели в условиях, которые ближе к реальному применению. Конкретные числа ROC-AUC и R² стоит перепроверить, когда появится полный текст статьи с описанием моделей, процедуры обучения и статистики. До этого корректно говорить о заявленных результатах, а не о воспроизведённых.
Ссылки: пресс-релиз ИТМО (рус.), английская версия, карточка датасета AptaBench на Hugging Face.
Источники и литература
- В ИТМО разработали тест для ИИ-моделей, которые помогают искать перспективные аптамеры — пресс-релиз; доступный текст страницы
- aptabench-anonymous/AptaBench_dataset · Datasets at Hugging Face — первичный документ; доступный текст страницы
- aptabench-anonymous/AptaBench_dataset at main — тип публикации не установлен; доступный текст страницы
- aptabench-anonymous/AptaBench_dataset · Discussions — тип публикации не установлен; доступный текст страницы
- ITMO Researchers Develop Test for Aptamer Analysis AI Models — пресс-релиз; доступный текст страницы


Похожие статьи
 Полезные материалы
10
мин
10.08.2026
1
Проблемы на защите исследования: 10 критериев качественной работы, как успешно защитить материал
При анализе академического исследования на защите члены комиссии часто сталкиваются с поверхностным анализом проблемы, непроработанной теоретической базой, несоответствием задач с поставленными результатами и целью. Слабая подготовка студента также выражается в неуверенных ответах на вопросы комисси
 Полезные материалы
10
мин
10.08.2026
1
Черные и белые схемы написания диссертации: что работает, а от чего лучше воздержаться
В 2026 году использовать «черные схемы» написания диссертации стало намного рискованнее: научные организации, университеты, диссертационные советы внедряют новые инструменты проверки качества текста и академической добросовестности. Если выявляется недостаточная проработка темы, формальн
 Полезные материалы
18
мин
01.10.2026
Что на самом деле измеряют бенчмарки ИИ: конвергентная и дискриминантная валидность против посторонних навыков
Вопрос о том, измеряет ли бенчмарк предвзятость и безопасность модели или посторонний навык вроде понимания текста, в 2026 году перестал быть риторическим. Две работы переносят в оценку ИИ аппарат психометрики — науки об измерении человеческих способностей, — и показывают, что часть популярных тесто
 Полезные материалы
11
мин
27.02.2026
1
Лучшие инструменты для анализа данных в дипломе и диссертации: SPSS, R, Python, Excel, NVivo
Инструменты для анализа данных помогут грамотно интерпретировать результаты, соблюсти требования к технической точности, учесть специфику данных. Такие помощники помогут подобрать адекватные методы обработки информации, обеспечить воспроизводимость результатов в соответствии со сложностью проблемы.
 Полезные материалы
5
мин
13.07.2022
18613
Как долго пишется докторская диссертация? Как быстро написать докторскую
Докторская диссертация – это сложный научно-квалификационный труд с большим объемом информации, расчетов и т.д., поэтому на составление и написание этого документа отводится около 3-4 лет. Как долго пишется докторская? Из-за трудоемкости этой научной работы, соискателю докторской степени
 Полезные материалы
16
мин
26.02.2026
1
Дневник исследователя: что это и зачем нужно
Дневник исследователя – это письменный проект, в котором фиксируются заметки ученого в процессе выполнения диссертации или другой научной работы. Чтобы упростить процесс работы над поиском решения проблемы, в дневник исследования можно вносить черновики промежуточных выводов, итоги наблюдений,
Последние новости и статьи
 Полезные материалы
8
мин
02.10.2026
Дополнительные условия на экзаменах: как документируют необходимость и почему СДВГ и тревога спорнее физических ограничений
Вопрос о том, кому положены дополнительные условия на стандартизированных тестах — дополнительное время, тихая аудитория, перерывы, отдельные условия для чтения, математики или письма, — упирается не в список диагнозов, а в процедуру подтверждения. Разбирать это приходится по материалу, который сам
 Полезные материалы
13
мин
02.10.2026
Сенсорная фовеа на кончиках пальцев Pipa pipa: как периферия и тектум выделяют важную поверхность
Суринамская жаба Pipa pipa — полностью водная, безъязыкая пипидная лягушка, которая ловит добычу быстрым всасыванием, координируя его передними конечностями. Кончики её пальцев несут характерные лопастные структуры, функция которых до недавнего времени была неизвестна. Работа Meredith, Fuquen, Manfr
 Дипломы
10
мин
02.10.2026
Что оценивает комиссия на защите диплома: критерии и подготовка доказательств
Комиссия на защите диплома оценивает не «красоту» работы, а то, насколько вы как автор понимаете свой результат и можете его доказать. В разных вузах и даже на разных программах одного вуза набор критериев и порядок оценивания отличаются: общие правила задаёт положение о государственной итоговой атт
 Наука
5
мин
01.10.2026
Формальный анализ CAN XL нашёл семь новых уязвимостей поверх известных проблем классического CAN
Исследователи из Технологического института Джорджии, Университета Пердью и Катарского исследовательского института вычислительной техники провели формальный анализ безопасности MAC-подуровня CAN XL — нового стандарта автомобильных сетей, принятого в мае 2024 года. Работа представлена на 35-м симпоз
 Наука
3
мин
01.10.2026
Акриловое стекло разобрали на мономеры при 180–230 °C без растворителя
Группа Афины Анастасаки из ETH Zurich показала, что коммерческий полиметилметакрилат (ПММА) — акриловое стекло, из которого делают плексиглас и оргстекло, — можно разобрать обратно на мономер при 180–230 °C без растворителя. Результат опубликован в Nature Chemistry 2 сентября 2026 года (DOI: 10.1038
 Образование
4
мин
01.10.2026
В США сотни тысяч детей стоят в очереди на субсидию по уходу, и списки не отражают реальную нужду
Агентство Associated Press вместе с изданием EdSurge 3 сентября 2026 года опубликовало анализ данных о субсидиях на детский уход в США. По подсчётам журналистов, весной 2026 года в 23 штатах и округе Колумбия в листах ожидания находились сотни тысяч детей. Данные о листах ожидания и зачислении собир