
Содержание статьи
Полезные материалы
04.10.2026
04.10.2026
10
мин
Представьте, что вы заходите в чужую квартиру и вас просят застелить постель. Вы не знаете высоту кровати, не видели это одеяло и не помните, где лежат подушки. Скорее всего, вы справитесь: подойдёте, поправите, подоткнёте. Именно эту человеческую способность — переносить знакомое действие в незнакомую обстановку — компания Figure AI попыталась проверить у своего гуманоида. И здесь начинается самое интересное, потому что за громкой формулировкой «робот работал в 30 домах» скрываются две разные метрики, которые легко перепутать.
Разбираться в этом стоит по первоисточнику. 17 сентября 2026 года Figure AI опубликовала в корпоративном блоге материал о нейросети Helix 2.5 под заголовком «Zero-Shot 30-Home Generalization» — то есть «обобщение на 30 домов без предварительного знакомства». Это пресс-релиз компании, а не рецензированная научная статья: авторы-люди не указаны, независимой репликации нет, полный протокол не раскрыт. 2 октября 2026 года читатель Naked Science Дмитрий Богданчиков пересказал это заявление в разделе «Сообщество» и, что важно, сам развёл два разных утверждения: работа в каждом доме и безошибочное выполнение каждого запуска — не одно и то же.
Чтобы понять, что именно проверяли, нужно сначала разобраться, как устроено обучение. Figure собрала Index — набор данных о том, как действуют люди. По описанию компании, это видео реальных бытовых и рабочих задач, которые добровольцы записывают через приложение: на момент публикации заявлено более 264 тысяч загрузок приложения в 108 странах и свыше 44 тысяч активных пользователей в неделю. На каждую тысячу часов собранных данных, по данным Figure, приходится 373 уникальные задачи, 1146 уникальных объектов и 116 уникальных сред. Конвейер обработки включает фильтрацию, проверку на подлог, удаление дублей, перебалансировку и разметку.
Дальше Helix 2.5 предобучили на Index, а затем из одной базовой модели получили три бытовых навыка: уборку гостиной, складывание полотенец и заправку кровати. Задачи задавались через дообучение на данных, собранных в других местах. И только после этого робота привели в 30 домов в районе залива Сан-Франциско, где, как утверждает компания, не собирали никаких данных, не дообучали модель и не адаптировали её под конкретный интерьер или объекты.
Здесь и прячется первая тонкость. Слово «zero-shot» в тексте Figure относится к средам оценки и к объектам, которыми манипулировал робот, а не к самим задачам. Задачи были заданы заранее — данными из других мест. То есть это не «робот впервые в жизни узнал, что такое складывать полотенце», а «робот умеет складывать полотенце, но видит это полотенце и эту комнату впервые». Разница принципиальная, и Figure сама её оговаривает.
Теперь про цифры, из-за которых и возник вопрос. Компания провела контролируемое сравнение: обучила две модели на одинаковых данных о задачах, которые не включали дома и объекты из оценки. Одна модель стартовала со случайных весов, вторая — из предобученной на Index модели Helix 2.5. Архитектура, оптимизация, гиперпараметры, данные и процедура оценки были зафиксированы. Единственное различие — предобучение на Index. В слепой оценке модель со случайной инициализацией полностью выполнила задачу в 9% попыток, а предобученная — в 56%. Успех засчитывался только при полном выполнении: все игрушки убраны, все полотенца сложены, кровать застелена целиком. Частичного зачёта не было.
Вот тут и стоит остановиться. 56% — это доля полностью успешных попыток, а не доля домов, где робот хоть раз справился. Утверждение «робот продемонстрировал выполнение задач во всех 30 домах» и утверждение «56% попыток завершились полным успехом» описывают разные вещи и не противоречат друг другу. Дом может попасть в список «отработанных», если хотя бы один запуск там закончился успехом, тогда как в остальных запусках в том же доме робот мог не довести дело до конца. Именно это различие читатель Naked Science и зафиксировал: работа в каждом доме не означает безошибочного выполнения каждого запуска.
Почему 56% — это не «почти готов к повседневной работе»? Потому что дома — не полигон с одной попыткой. Если робот полностью справляется чуть больше чем в половине запусков, то в остальных случаях задачу придётся доделывать человеку или перезапускать. Для демонстрации переноса навыка это серьёзный результат, для бытового применения — недостаточная надёжность. И Figure это признаёт прямым текстом: «Речь не о том, что общая гуманоидная робототехника решена».
Есть и другие оговорки, которые важны не меньше цифр. Компания не раскрывает общее число попыток, сколько их приходилось на каждый дом и на каждую задачу, как успехи распределялись между домами и задачами и каковы доверительные интервалы для 9% и 56%. Без этого нельзя сказать, насколько устойчива разница между моделями и не держится ли она на нескольких удачных домах. Не опубликованы ни полный протокол оценки, ни код, ни веса модели, ни сами данные — доступны только описания и видео. Критерии оценки, по утверждению Figure, были зафиксированы до начала испытаний, а во всех 30 домах использовался один и тот же чекпойнт без подстройки весов. Это снижает риск подгонки, но не заменяет независимой проверки.
Отдельно стоит сказать про масштаб данных. Figure заявляет, что ни одна отдельная задача из оценки не составляет более 1,90% датасета предобучения Index. Иными словами, навык складывания полотенец или заправки кровати не был «подсмотрен» в готовом виде — он собирался из широкого человеческого опыта. Компания также сообщает, что Helix 2.5 использовала вдвое меньше данных под конкретную задачу, чем типовое поведение предыдущей модели Helix 02, и при этом обобщила его на 30 незнакомых домов. Для сравнения: Helix 02, представленная в январе 2026 года, выполняла четырёхминутную автономную задачу с разгрузкой посудомоечной машины, включавшую 61 действие с перемещением и манипуляцией, но обучалась на данных из той среды, где работала.
Ещё один заявленный результат — так называемый закон масштабирования переноса от человека к гуманоиду. Figure обучила четыре модели на вложенных подмножествах Index с восьмикратным увеличением объёма данных, зафиксировав размер модели и дообучение. Потери предсказуемо снижались с каждым удвоением данных, и, по словам компании, ошибка прогноза для самого крупного запуска составила 0,54% от разброса по всему восьмикратному диапазону. Это интересное наблюдение, но оно измеряет только масштабирование данных и опирается на внутренние метрики компании, а не на внешне воспроизводимый эксперимент.
Что из этого следует для читателя? Перенос навыка — действительно важный шаг. Раньше роботов учили под конкретное место, и каждый новый дом означал новый сбор данных. Если предобучение на человеческом опыте позволяет входить в незнакомую квартиру и сразу браться за дело, это меняет экономику домашней робототехники: не нужно заново обучать машину под каждую кухню. Но между «робот справился в незнакомом доме» и «робот надёжно работает в незнакомом доме» лежит пропасть, которую как раз и показывает цифра 56%. Доля полностью успешных попыток — честная метрика, и она говорит, что почти в половине запусков робот не доводит задачу до конца.
Остаётся открытый научный вопрос: насколько устойчив этот перенос и как он поведёт себя при большем числе попыток и более разнообразных домах. Ответить на него можно только независимой репликацией с раскрытым протоколом — числом попыток, распределением успехов и статистической неопределённостью. Пока у нас есть корпоративное заявление с конкретными, но неполными цифрами и разумная оговорка самой компании о том, что общая задача не решена. Этого достаточно, чтобы отличить перспективный результат от готового продукта — и не перепутать одно с другим.
Если вам интересно, как в научной работе отделять заявленный результат от его интерпретации и фиксировать ограничения рядом с выводом, посмотрите материал о том, как оценивают результаты исследования в диссертации.
Источники:
- Figure AI. Helix 2.5: Zero-Shot 30-Home Generalization. 17 сентября 2026. https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization
- Figure AI. Introducing Index: Building The World’s Largest and Most Diverse Physical Dataset. 25 августа 2026. https://www.figure.ai/news/introducing-index
- Figure AI. Introducing Helix 02: Full-Body Autonomy. 27 января 2026. https://www.figure.ai/news/helix-02
- Дмитрий Богданчиков. Гуманоид Figure выполнил бытовые задачи в 30 незнакомых домах. Naked Science, раздел «Сообщество», 2 октября 2026. https://naked-science.ru/community/1219672
Источники и литература
- Гуманоид Figure выполнил бытовые задачи в 30 незнакомых домах — авторское мнение; доступный текст страницы
- Helix 2.5: Zero-Shot 30-Home Generalization — пресс-релиз; доступный текст страницы
- Introducing Index: Building The World’s Largest and Most Diverse Physical Dataset — пресс-релиз; доступный текст страницы
- Introducing Helix 02: Full-Body Autonomy — пресс-релиз; доступный текст страницы
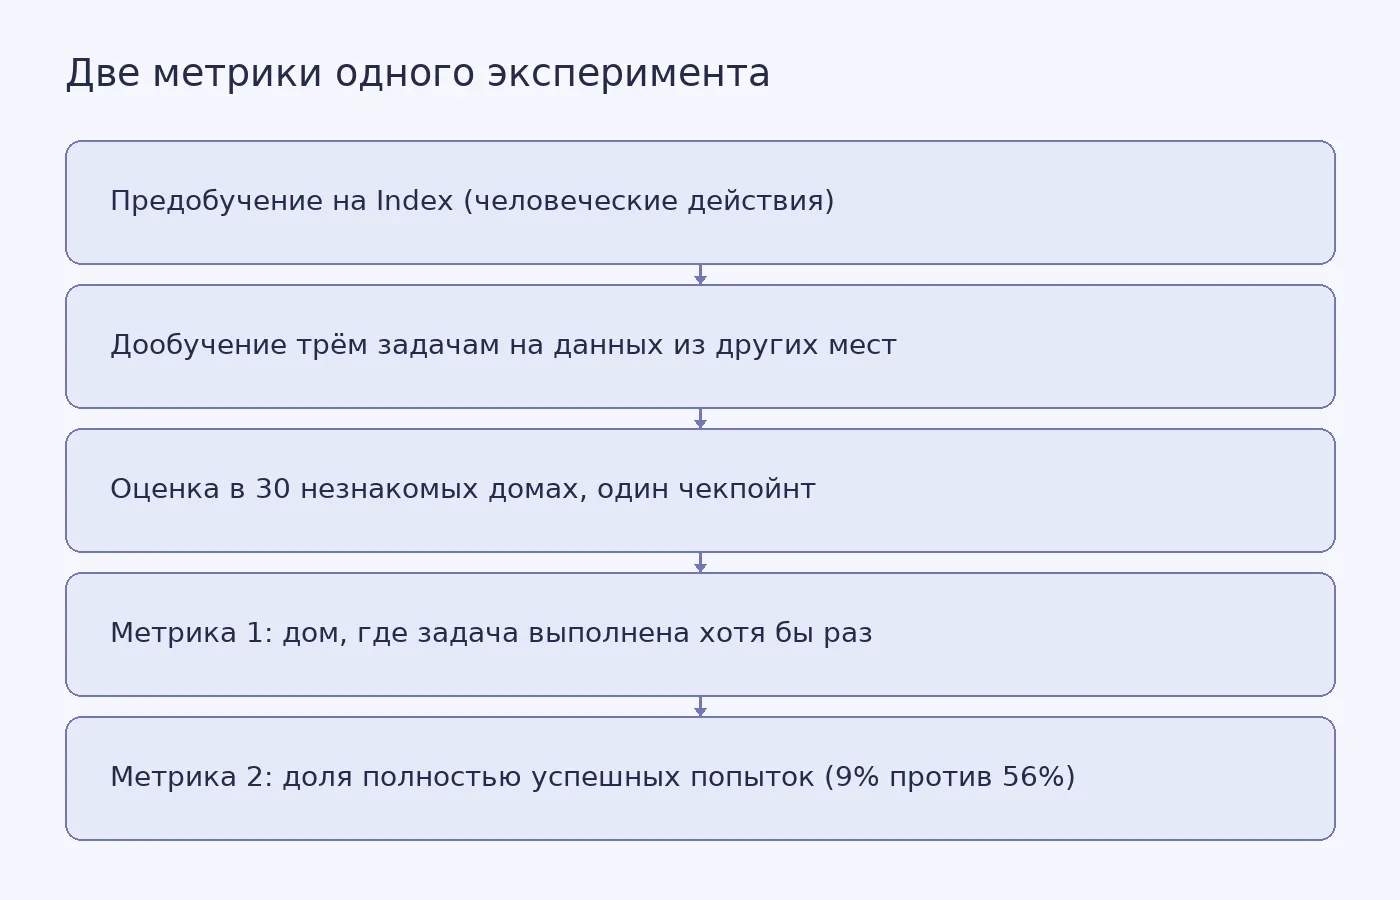
Фото: Pavel Danilyuk / Pexels


Похожие статьи
 Полезные материалы
12
мин
04.03.2026
1
Микронавыки для студентов 2026: навыки, которые можно освоить за 7–10 дней
Чтобы лучше усвоить материал по тому или иному учебному предмету, студентам рекомендуется осваивать полезные микронавыки: например, структурировать заметки, оформить таблицу, сделать простую визуализацию данных по ТЗ и т.д. Перед выбором полезного микронавыка нужно учитывать 3 критерии качества &nda
 Полезные материалы
12
мин
02.10.2026
Как ферменты разрушают PET и что показал опыт с пластиковой плёнкой
Новость о бактериях, которые «научили» разрушать пластик, обычно звучит так: в сточные воды подсадили ген фермента, и плёнка исчезла на 40% за четыре дня. В реальности ген переносили в бактерии из пробы сточных вод в лаборатории, а около 40% потери массы получили для очищенного фермента на коммерчес
 Полезные материалы
12
мин
03.10.2026
Что снимок сетчатки может рассказать о риске фибрилляции предсердий
На OCT-снимке глазного дна видны не только общие контуры сетчатки, но и ее отдельные слои. Один из них, макулярный комплекс ганглиозных клеток и внутреннего плексиформного слоя, обозначают как mGCIPL. В исследовании двух британских когорт этот слой оказался тоньше у людей с фибрилляцией предсердий,
 Полезные материалы
17
мин
04.10.2026
Что самодельный оркестратор объясняет о Kubernetes лучше готового кластера
Контейнер обращается к Service. Балансировщик выбирает другой контейнер на том же узле, запрос уходит и зависает. Стоит выбрать удалённый контейнер, и всё работает. Система не сообщает об ошибке, конфигурация выглядит правильной, а причина отказа скрывается в пути ответного пакета.С таким случаем ст
 Полезные материалы
15
мин
04.10.2026
Миллион кубитов: зачем они нужны и какие задачи квантовый компьютер действительно сможет решать
На схеме квантового процессора сотни кубитов выглядят почти как готовая машина: добавим ещё несколько рядов, и можно запускать полезные вычисления. На практике между 256 физическими кубитами и системой, способной долго считать с приемлемой надёжностью, лежит целая инженерная лестница. Кубиты ошибают
 Полезные материалы
17
мин
04.10.2026
Почему формальная проверка математических доказательств не гарантирует абсолютной защиты от ИИ-атак
Представим файл с коротким итогом: «Гипотеза доказана». Его проверяют две программы, созданные разными командами, и обе отвечают, что ошибок нет. Для математика это весомое подтверждение. Однако даже два совпавших ответа не дают абсолютной гарантии.Компьютер проверяет не математическую истину вообще
Последние новости и статьи
Полезные материалы
17
мин
04.10.2026
Почему формальная проверка математических доказательств не гарантирует абсолютной защиты от ИИ-атак
Представим файл с коротким итогом: «Гипотеза доказана». Его проверяют две программы, созданные разными командами, и обе отвечают, что ошибок нет. Для математика это весомое подтверждение. Однако даже два совпавших ответа не дают абсолютной гарантии.Компьютер проверяет не математическую истину вообще
Полезные материалы
15
мин
04.10.2026
Миллион кубитов: зачем они нужны и какие задачи квантовый компьютер действительно сможет решать
На схеме квантового процессора сотни кубитов выглядят почти как готовая машина: добавим ещё несколько рядов, и можно запускать полезные вычисления. На практике между 256 физическими кубитами и системой, способной долго считать с приемлемой надёжностью, лежит целая инженерная лестница. Кубиты ошибают
 Полезные материалы
13
мин
04.10.2026
Почему один Эль-Ниньо вызывает засухи в одних регионах и наводнения в других
У побережья Перу может становиться влажнее, тогда как в Индонезии в тот же период повышается риск сухой погоды и пожаров. Оба явления способны быть связаны с одной фазой климатической системы Эль-Ниньо, хотя между регионами тысячи километров.Здесь нет переноса одной и той же погоды через океан. Эль-
 Наука
5
мин
03.10.2026
Модель по ДНК оценила срок жизни чёрных голотурий более чем в 120 лет
Чёрные голотурии Holothuria (Microthele) whitmaei могут жить более 120 лет. К такой модельной оценке пришла команда биолога Свена Утики из Австралийского института морских наук, сопоставив образцы ДНК, взятые на Большом Барьерном рифе с разницей в 24 года. О результате 3 октября 2026 года сообщило и
 Наука
3
мин
03.10.2026
В Fe₅GeTe₂ обнаружили плоскую электронную зону с медленным коллективным движением электронов
Исследователи из Чикагского университета обнаружили в слоистом магните Fe₅GeTe₂ зарядово-упорядоченное состояние и плоскую электронную зону. Тысячи или миллионы электронов в ней двигались необычно медленно и согласованно, сохраняя квантовую когерентность. Результаты опубликованы 7 августа 2026 года
 Наука
4
мин
03.10.2026
Облачная платформа помогла находить задержки в ПО беспилотных автомобилей
Исследовательская группа Сайтамского университета во главе с профессором Такуей Адзуми вместе с Astemo проверила систему сквозной трассировки CART в облачной среде для разработки беспилотных автомобилей. О результатах Сайтамский университет сообщил 3 октября 2026 года. Облака точек из симулятора CAR