Контейнер обращается к Service. Балансировщик выбирает другой контейнер на том же узле, запрос уходит и зависает. Стоит выбрать удалённый контейнер, и всё работает. Система не сообщает об ошибке, конфигурация выглядит правильной, а причина отказа скрывается в пути ответного пакета.
С таким случаем столкнулся разработчик Kyle Kjorsvik, когда писал Smith, небольшой оркестратор контейнеров на Go. Проект воспроизводит несколько механизмов Kubernetes: управляющий контур, узловые агенты, сеть через интерфейс CNI, маршрутизацию Service с помощью iptables, цикл согласования и постепенные обновления. Kjorsvik хотел понять, почему эти механизмы устроены именно так. Для этого он собирал упрощённые реализации, наблюдал их отказы и менял архитектуру.
Это не научный эксперимент и не рецензированная статья, а авторский инженерный отчёт вместе с открытым репозиторием. Код, документацию и описанные сценарии отказов можно проверить. Однако этот материал не доказывает, что самостоятельная реализация необходима каждому, кто изучает Kubernetes. Он показывает устройство конкретного проекта и позволяет сопоставить авторские выводы с тем, что действительно реализовано в Smith.
Что именно изучал автор
Исходный вопрос Kjorsvik звучит так: что происходит между ядрами двух узлов, когда контейнер на одном из них обращается к Service, за которым находится контейнер на другом? В готовом Kubernetes этот путь складывается из работы нескольких компонентов. Пользователь видит манифест, команду kubectl и итоговое состояние, но может не замечать, где выдаётся IP-адрес, кто прокладывает маршрут, когда выполняется преобразование адресов и как контроллер восстанавливает контейнер после отказа.
Чтобы сделать эти границы видимыми, автор написал Smith. По его описанию, в проекте около 30 исходных файлов. Управляющий контур хранит желаемое состояние в SQLite, а агенты на рабочих узлах запускают контейнеры через containerd. Каждый узел получает отдельную подсеть /24 из диапазона 10.22.0.0/16. Для Service поддерживаются ClusterIP и NodePort, правила распределения трафика создаются в iptables.
Систему развернули на виртуальных машинах Proxmox: одна машина управляющего контура и пять агентских узлов. DNS-записи в Route 53 указывали на этот кластер, который, по сообщению Kjorsvik, обслуживал реальный трафик. Этим и ограничивается опубликованный масштаб проверки. Автор не приводит отдельную выборку испытаний, результаты продолжительного нагрузочного теста, количественные показатели доступности или прямое сравнение с Kubernetes.
CNI выдаёт адрес, но не создаёт связность всего кластера
Первый вариант сети выглядел законченным. Контейнер получал адрес 10.22.1.7, выходил в интернет и связывался с соседним контейнером через локальный мост. Проблема появилась, когда контейнеры оказались на разных узлах.
«Затем я разместил два контейнера на разных узлах, и ничего не заработало, причём без ошибки. CNI создаёт на каждом узле изолированный мост. Это всё, что он даёт. Между этими мостами ничего не маршрутизируется».
CNI, Container Network Interface, представляет собой интерфейс между средой выполнения контейнеров и сетевым плагином. Адрес у контейнера ещё не означает, что ядро одного узла знает маршрут к контейнерной подсети другого. В Smith этот пробел закрывает отдельный менеджер маршрутов. Он добавляет маршрут к подсети /24 каждого соседнего узла через IP-адрес этого узла, периодически сверяет таблицу с текущим составом кластера и удаляет маршруты к исчезнувшим участникам.
Самостоятельная реализация хорошо показывает границу ответственности. Сетевой слой решает по меньшей мере две разные задачи: подключает контейнер к локальному мосту и обеспечивает маршрутизацию между узловыми подсетями. Такое разделение позволяет менять модель межузловой сети, не переписывая весь жизненный цикл контейнера.
Следующий отказ вызвал параметр ipMasq. Безусловный маскарадинг заменял исходный адрес контейнера адресом узла. Связь между узлами появлялась, но принимающая сторона переставала видеть настоящий IP отправителя. Автор отключил маскарадинг в конфигурации моста и перенёс его в межсетевой экран, где преобразование можно применять только к нужным потокам.
Исправление связности в этом случае уничтожило информацию, необходимую другим частям системы. Пакет дошёл, но наблюдение за трафиком и правила, зависящие от адреса источника, стали менее точными. Поэтому одной проверки «проходит ли трафик» недостаточно. Нужно смотреть, какие адреса видят обе стороны после всех преобразований.
Почему локальный ответ теряется
Самый наглядный сетевой отказ возник в петлевом, или hairpin, сценарии. Контейнер обращался не прямо к другому контейнеру, а к виртуальному адресу Service. iptables выполнял DNAT, то есть заменял адрес назначения на адрес выбранного бэкенда. Когда клиент и бэкенд находились на разных узлах, поток проходил ожидаемым путём. Если оба оказывались на одном мосту, ответ мог вернуться напрямую.
«Бэкенд отвечает непосредственно вызывающему контейнеру, который тоже находится локально и доступен через тот же мост. Поэтому ответ не проходит обратно через conntrack узла, обратное преобразование DNAT не выполняется, и вызывающий контейнер получает пакет с адреса, которому он ничего не отправлял. Клиент отбрасывает его».
Conntrack, подсистема отслеживания соединений в ядре Linux, запоминает преобразование прямого пакета и применяет обратное преобразование к ответу. Для этого ответ должен снова пройти через соответствующую часть сетевого стека. Прямой обмен через локальный мост способен её обойти.
В Smith сервисный трафик помечается значением fwmark 0x4000, после чего к нему применяется MASQUERADE. Ответ возвращается через conntrack и получает ожидаемый адрес источника. За это приходится платить потерей части информации: бэкенд видит IP узла вместо адреса клиентского контейнера.
Автор связывает этот случай с параметром --masquerade-all в kube-proxy. В учебном проекте назначение маскарадинга стало понятным после воспроизведения конкретного отказа. Однако из этого нельзя заключить, что параметр нужен в любой конфигурации Kubernetes или что все сетевые плагины одинаково обрабатывают петлевой трафик. Кейс объясняет класс проблемы, но не заменяет документацию конкретной сетевой реализации.
Почему одноразовой команды недостаточно
Первый контроллер Smith работал по событию. Управляющий контур выбирал узел, отправлял агенту команду запуска и запоминал, что реплика размещена. Эта схема выглядит достаточной, пока после команды ничего не меняется.
В распределённой системе узел может перезагрузиться, агент остановиться, контейнер завершиться после успешного ответа API, а сеть оборваться между подтверждением и записью результата. В отчёте последствие описано точно:
«В памяти управляющего контура было записано „размещён“, тогда как в реальности контейнер отсутствовал, и система больше не сходилась к нужному состоянию».
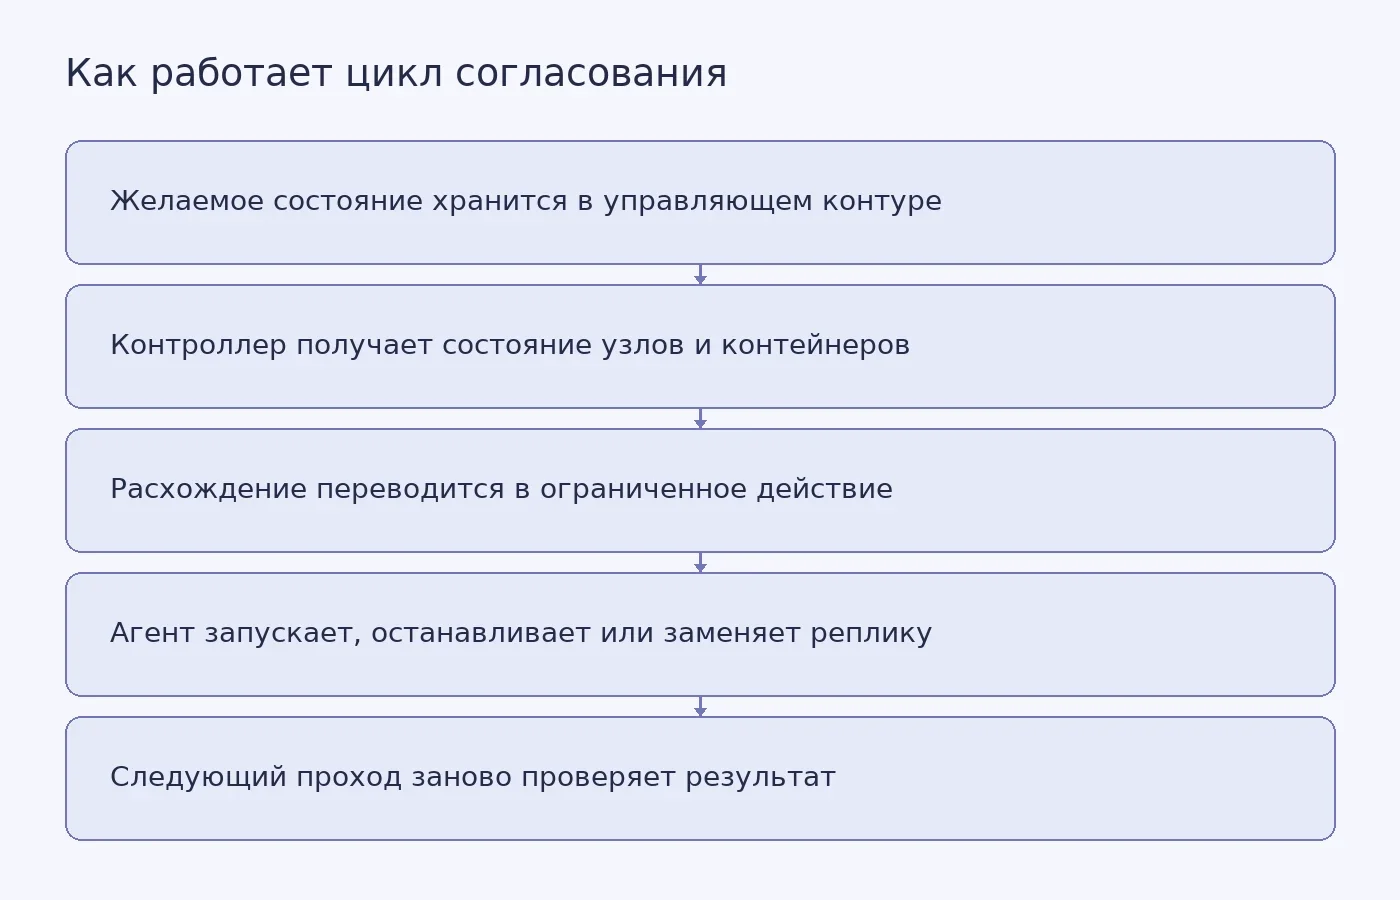
Исправленная модель основана на согласовании по текущему состоянию, или level-triggered reconciliation. Контроллер хранит желаемую конфигурацию, получает наблюдаемое состояние и действует снова, если обнаруживает расхождение. Старое подтверждение не считается окончательным доказательством того, что контейнер по-прежнему работает.
Документация репозитория уточняет алгоритм. Цикл запускается каждые 5 секунд. Новая, перемещённая или устаревшая по хешу спецификации реплика отправляется агенту. После отправки действует льготный период 10 секунд. Затем контроллер проверяет состояние контейнера. Если контейнер не работает, запись об успешной отправке очищается, поэтому на следующем проходе команда будет повторена.
В блоге эта модель описана как постоянная повторная отправка всего, что находится не там или работает неправильно. Код и README формулируют поведение точнее: актуальные работающие реплики не отправляются агентам заново на каждом проходе. Контроллер проверяет состояние и возобновляет действие, когда находит расхождение. Модель остаётся согласованием по текущему состоянию, но не сводится к бесконечному повторению одной команды.
Временные параметры Smith задают скорость отдельных этапов. Агент посылает сигнал активности каждые 10 секунд. Если управляющий контур не получает его 30 секунд, узел признаётся недоступным. Его реплики снимаются с назначений, планировщик распределяет их по оставшимся узлам, а контроллер отправляет новые назначения и проверяет запуск.
Этот сценарий показывает механизм восстановления, но не измеряет его надёжность. Из опубликованных интервалов нельзя вычислить реальное время возвращения сервиса. К 30 секундам обнаружения добавляются планирование, передача команды, загрузка образа, запуск контейнера и возможные сетевые задержки. В отчёте эти величины не измерены.
Постепенное обновление продолжает тот же цикл
При изменении спецификации нельзя одновременно остановить все старые реплики. В Smith контроллер на каждом проходе пересчитывает число недоступных реплик. Следующую реплику он переводит на новую спецификацию, только если это не нарушает ограничение max_unavailable.
«Никакого координатора, аренды или блокировки. Используется то же сравнение по текущему состоянию, применённое к доступности. Частично завершённое обновление является допустимым состоянием, которое можно обнаружить и продолжить на следующем проходе».
Управление здесь распределено по повторяющимся вычислениям. Контроллеру не нужно помнить точный шаг, на котором оборвался линейный сценарий. После перезапуска он снова получает наблюдаемое состояние, считает недоступные реплики и выбирает следующее допустимое действие.
README добавляет важные детали. Изменение образа, аргументов, переменных окружения, портов или ресурсов меняет хеш спецификации и запускает постепенную замену. Если изменилось только число реплик, хеш контейнерной спецификации остаётся прежним, поэтому система масштабирует рабочую нагрузку без постепенного обновления. Новую версию получают только те реплики, замена которых укладывается в установленный бюджет недоступности.
Связь между согласованием и обновлением здесь особенно заметна. Постепенное обновление можно представить не как отдельную процедуру с глобальной блокировкой, а как последовательность допустимых промежуточных состояний. Один и тот же контроллер шаг за шагом приближает систему к новой конфигурации.
Где рассказ расходится с текущей документацией
В блоге сказано, что Smith выполняет HTTP- и exec-проверки, учитывает пороги ошибок и передаёт результаты в цикл согласования. Это существенное утверждение: от готовности реплики должно зависеть решение о продолжении обновления.
Текущий README сообщает другое:
«Проверки состояния определены, но пока не подключены к согласованию. Рабочие нагрузки принимают параметр health_check, а в управляющем контуре есть монитор для HTTP- и exec-проверок, однако цикл согласования сейчас не запускает наблюдателей и не действует на основании их результатов».
Кроме того, exec-проверки в существующем виде запускаются относительно локального containerd управляющего контура, поэтому не найдут контейнеры на агентских узлах. Блог нельзя считать подтверждением того, что результаты проб уже управляют обновлениями. При оценке текущего состояния проекта конкретная оговорка README надёжнее общего авторского рассказа.
Такое расхождение встречается и в других технических материалах: архитектурное намерение, объявленный интерфейс и подключённый механизм могут находиться на разных стадиях готовности. Подход к этой проверке подробнее разобран в статье о том, как проводить критический анализ источника и отделять вывод от доказательства.
Что Smith пока не проверяет
Главное ограничение находится в управляющем контуре. Желаемое состояние хранится в одном файле SQLite на одном сервере. Автор прямо называет его единой точкой отказа. Поэтому Smith не проверяет работу реплицированного консенсусного хранилища, подобного etcd, и не моделирует выбор лидера между несколькими управляющими узлами.
SQLite помогает пережить перезапуск процесса, но не потерю машины или повреждение единственного хранилища. Реестр активных узлов и назначения находятся в памяти. После перезапуска сервера агенты продолжают выполнять контейнеры, а затем повторно регистрируются, когда получают ответ 404 на сигнал активности. Такой механизм обеспечивает восстановление, но не высокую доступность управляющего контура.
Более опасное ограничение проявляется при сетевом разделении. Узел может продолжать выполнять старую реплику с состоянием, пока управляющий контур после 30-секундного тайм-аута запускает новую на другом узле. Временно возникают два писателя. В Smith нет fencing или STONITH, то есть механизма, который гарантированно отключает прежний узел до запуска замены. Ограничение числа реплик до одной не обеспечивает единственного писателя при потере связи.
Точка входа также не имеет собственной высокой доступности. Smith распределяет запросы между репликами, но доставку клиента к работающему агенту должен обеспечивать внешний плавающий виртуальный IP или круговая выдача DNS. Закрытый ключ wildcard-сертификата при этом передаётся каждому агенту. Автор считает такую схему допустимой для доверенной домашней сети, но для публичной среды рекомендует отдельные сертификаты узлов или централизованное завершение TLS.
Эти ограничения показывают, сколько разных задач скрывается за выражением «надёжный кластер». Запуск контейнера, восстановление реплики, защита от двух писателей, сохранность управляющего состояния и доступность точки входа требуют разных гарантий. Работающий демонстрационный кластер не подтверждает их автоматически.
Вывод автора и наша интерпретация
Kjorsvik считает согласование по текущему состоянию основой устойчивости Kubernetes. По его формулировке, это «не стилистический выбор», а модель, способная выдерживать перезагрузки узлов и сетевые разделения. Собственная событийная реализация помогла ему увидеть, почему одного успешного вызова API недостаточно.
В пределах Smith этот вывод подкреплён устройством системы и описанными отказами. Контейнер действительно может исчезнуть после успешного назначения. Незавершённое обновление можно продолжить, если решение каждый раз вычисляется из наблюдаемого состояния. Сетевые случаи показывают, почему выдачу адреса, межузловую маршрутизацию, преобразование адресов и отслеживание соединений нужно рассматривать отдельно.
Но утверждение, что такие принципы становятся понятны только после самостоятельной реализации, остаётся личным выводом автора. В кейсе нет участников, контрольной группы, проверки знаний до и после проекта или сравнения с чтением исходного кода, лабораторными заданиями и трассировкой готового Kubernetes. Smith подтверждает существование конкретных технических проблем, но не доказывает превосходство одного способа обучения для всех инженеров.
Более осторожный итог полезнее. Декларативный оркестратор нельзя понимать как программу, которая один раз исполняет список команд. Это система обратной связи: она получает неполный и быстро устаревающий снимок кластера, сравнивает его с желаемым состоянием и выполняет следующий ограниченный шаг. Сеть, восстановление после отказа и постепенное обновление сходятся в одном требовании: прошлый успех команды не заменяет нового наблюдения за системой.
Kjorsvik K., перевод kmoseenk. Чтобы понять Kubernetes, я написал свой Kubernetes. Habr, блог компании OTUS. Русскоязычный полный перевод; календарная дата в предоставленной версии страницы не указана.