
Содержание статьи
Полезные материалы
03.10.2026
03.10.2026
13
мин
Пользователь просит ИИ-агента определить, какие устройства сейчас находятся в корпоративной сети. Роутер не находит подходящего раздела и не передаёт модели ни одного инструмента. Агент не сообщает об ограничении, а пишет: «Выполняю сканирование сети…» Затем он описывает работу, которой в действительности не было.
Этот случай разобран в инженерной публикации на Хабре. Исполнитель команд в описанной системе намеренно изолирован от корпоративной сети, поэтому провести сканирование агент всё равно не мог. Корректным поведением был бы отказ с объяснением ограничений среды. Однако предварительный роутер оставил модель без инструментов, после чего она сымитировала действие.
Такой эпизод показывает, почему сравнение двадцати и девяноста описаний в промпте ещё не доказывает эффект размера каталога. Вместе с длиной списка меняются состав кандидатов и число похожих инструментов. В результат вмешиваются качество роутера, возможности модели и правило, по которому ответ признают правильным.
Что представляет собой источник
Автор публикации использует имя vad_bel. В профиле на Хабре указаны Москва, Россия, а также специализации менеджера продукта и промпт-инженера. Точную календарную дату публикации установить по предоставленной копии страницы нельзя: на ней была только относительная отметка «9 часов назад». Месяцы отдельных прогонов автор называет, но год в тексте не указан.
Хабр пометил материал как «Мнение». Это полный авторский рассказ о собственном ИИ-оркестраторе, а не рецензируемая научная статья, препринт или независимый аудит. У публикации нет DOI. Автор не приложил исходные ответы модели, полный корпус запросов, версии промптов или репозиторий эксперимента. Поэтому перед нами инженерный кейс, из которого можно вывести проверяемую гипотезу, но не установленная закономерность.
Как работал узкий режим
Каталог оркестратора включал более девяноста инструментов для таблиц, документов, почты, задач, веб-страниц и презентаций. Для позднего этапа автор приводит точное число: 91 инструмент.
В полном режиме модель получала описания всего каталога. В узком режиме сначала срабатывал отдельный роутер:
«Перед основным вызовом модели работает роутер: по тексту запроса он выбирает раздел [...] и внутри раздела подраздел. Модель получает недевяносто описаний инструментов, а около двадцати».
Это вмешательство меняет сразу два свойства входа. Список становится короче, но одновременно из него исчезают некоторые кандидаты. Если среди удалённых вариантов есть правильный инструмент, основная модель уже не может сделать нужный вызов. Если исчезают только похожие по названию отвлекающие варианты, выбор упрощается.
Поэтому опубликованный опыт проверяет весь режим предварительного отбора, а не изолированное влияние количества инструментов.
Что измерял автор
Первый основной замер относился к локальной модели, названной в публикации Qwen3.6 27B. Она работала на RTX 3090 с 24 ГБ памяти. Автор подготовил корпус из 49 пользовательских запросов и провёл два прогона в один день. По его описанию, они различались длиной списка кандидатов.
«На узком наборе — 43 верных выбора из 44, на полном — 39. Контекст на полном в 2,7 раза больше, прогон дольше на треть».
Узкий режим дал на четыре правильных выбора больше. Ошибки полного режима возникали среди близких по смыслу инструментов: объединение датасетов путалось с управлением датасетами, построение графика и переименование колонок уходили в анализ датасета, а извлечение содержания новостных сайтов заменялось сырой загрузкой страницы.
Эти наблюдения совместимы с объяснением автора: модели могли мешать похожие «соседи». Но они не показывают, что причиной была именно длина контекста. Двадцать хорошо различимых инструментов и двадцать инструментов одного семейства создают разные задачи, хотя размер списка одинаков.
Есть и неразрешённая арифметическая проблема. Корпус состоял из 49 запросов, а результат приведён для 44 случаев. Почему пять запросов не вошли в показатель, текст не объясняет. Без покейсной таблицы нельзя установить, одинаково ли применялись правила исключения в обоих режимах.
Что показали восемь запросов
В отдельном разведочном сравнении было всего восемь запросов. Локальная модель получила 7 правильных ответов из 8 на узком наборе и 6 из 8 на полном. Для gpt-4.1 направление различия оказалось обратным: 7 из 8 на узком наборе и 8 из 8 на полном.
В проигранном случае роутер не передал gpt-4.1 инструмент, необходимый для запроса, который затрагивал два раздела. Отсюда появилась гипотеза: слабой модели сокращение числа кандидатов помогает, а более сильную модель предварительный фильтр может ограничивать. Автор не выдаёт этот результат за доказательство и пишет: «Конечно восемь запросов — это еще не доказательство, но это повод для замера».
Позднее тот же корпус прогнали на GigaChat-2-Max и gpt-oss 120B во всех четырёх режимах отбора, предусмотренных продуктом. К этому моменту каталог вырос до 91 инструмента. Автор сообщает, что узкий набор выиграл у обеих моделей по точности, размеру контекста и задержке. Полной числовой разбивки по четырём режимам в доступном тексте нет, поэтому величину и устойчивость различий проверить нельзя.
Этот этап нельзя считать прямым повторением первого опыта. Изменились модели и каталог. Автор также не указывает идентификаторы конкретных версий моделей, параметры генерации, промпты и число повторных запусков каждого запроса.
Когда ошибка становится уточнением
Три провала GigaChat в узком режиме были уточняющими вопросами, например «какой ключ проекта?» и «в каком слоте датасет?». Если признать разумное уточнение допустимым поведением, результат меняется с 41 из 44 до 44 из 44.
Это не техническая мелочь. Показатель точности имеет смысл только при заранее определённом критерии успеха. Для рабочего агента правильными могут быть разные исходы: вызов нужного инструмента с подходящими аргументами, запрос обязательного параметра, обоснованный отказ при недоступной операции или обычный текстовый ответ, когда инструмент не требуется.
В исходном корпусе уточнение засчитывалось как успех только в одном случае из 49. Альтернативная трактовка появилась после разбора ошибок. Она может быть полезна для совершенствования продукта, но первоначальную и ретроспективную оценки следует показывать раздельно.
Как проверить влияние размера каталога
Следующая схема является нашей методологической интерпретацией, а не описанием уже проведённого автором эксперимента.
Сначала нужно зафиксировать полный каталог: названия, описания, схемы аргументов, порядок инструментов и доступные функции. Версии каталога и промпта можно сохранять вместе с их контрольными суммами. Если между сериями добавить или переписать инструмент, получится уже другое условие.
Затем для каждого запроса заранее размечают допустимые действия. Разметка должна указывать правильный инструмент, обязательные аргументы, допустимость уточнения, основания для отказа и случаи, когда вызов не нужен. Спорные примеры полезно передать двум независимым разметчикам, а разногласия разрешить до запуска моделей.
После этого сравнивают как минимум четыре условия:
- Полный каталог. Модель видит все зафиксированные инструменты.
- Контролируемый узкий каталог. Правильный инструмент гарантированно присутствует, а число кандидатов задано заранее. Это позволяет проверить влияние размера и состава списка без ошибок реального роутера.
- Узкий каталог от роутера. Правильный инструмент может исчезнуть. Разница с контролируемым условием показывает, какую долю ошибок добавляет маршрутизация.
- Режим без инструментов. Он проверяет, отличает ли система отсутствие доступной операции от разрешения выдумать её выполнение.
Одного сокращённого списка мало. Если убрать из него самые похожие инструменты, эксперимент снова смешает размер каталога с трудностью выбора. Нужны вложенные наборы разного объёма и отдельное управление числом близких по смыслу кандидатов. При одинаковом размере можно сравнить список со случайными нерелевантными инструментами и список с инструментами одного семейства. Тогда станет понятнее, мешает ли модели длина каталога или конкуренция похожих описаний.
Что измерять отдельно
Для роутера нужен отдельный показатель: как часто среди переданных кандидатов сохраняется хотя бы один допустимый инструмент. Если правильного инструмента нет, записывать ошибку только на счёт основной модели нельзя.
Выбор функции и правильность аргументов тоже следует разделять. Модель может назвать нужный инструмент, но передать неверный идентификатор проекта, слот датасета или другой обязательный параметр. Это частично правильное действие, а не полностью выполненная задача.
На уровне всего агента оценивают конечное поведение. Выполнил ли он операцию? Задал ли уместный вопрос? Честно ли сообщил об ограничении среды? Фразу «Выполняю сканирование сети» при отсутствии вызовов стоит относить к отдельному классу ложных заявлений о совершённом действии.
Задержку и расход контекста также лучше не сводить к одной фразе вроде «быстрее на треть». Для каждого режима нужны число входных токенов, время роутинга, время генерации и полная задержка. Распределение по запросам покажет, является ли ускорение общим или возникает только на отдельных задачах.
Зачем нужны повторные запуски
Если модель использует недетерминированную генерацию, единичный ответ может измениться при повторном запуске. Поэтому следует фиксировать доступные параметры генерации и повторять каждый запрос несколько раз. Если поставщик API не позволяет задать seed или гарантировать воспроизводимость, это нужно прямо указать среди ограничений.
Поскольку через все режимы проходят одни и те же запросы, сравнивать следует не только итоговые суммы, но и результаты по каждой паре. Важны случаи, где полный режим оказался правильным, а узкий ошибся, и обратные переходы. При 44 оценённых примерах изменение одного ответа сдвигает долю более чем на два процентных пункта, поэтому округлённый процент без покейсных данных может выглядеть убедительнее, чем позволяет выборка.
Корпус полезно разделить на разработочную и тестовую части. На первой можно менять роутер и описания инструментов. Вторая должна оставаться закрытой до фиксации системы. Иначе последовательный разбор ошибок подгонит каталог под уже известные запросы, а новый прогон покажет качество этой доработки на знакомом наборе.
Вывод автора и наша интерпретация
Вывод автора относится к его оркестратору. Для трёх моделей, проверенных на полном корпусе, лучшим оказался узкий набор. Автор рекомендует настраивать роутинг отдельно для каждой модели, сравнивать режимы на одном корпусе и в один день, сохранять отпечаток каталога, отделять уточнения от промахов и проводить оценку по тому же пути, которым работает конечный продукт.
Наша интерпретация осторожнее. Публикация описывает правдоподобный механизм пользы короткого списка: модель реже путает похожие инструменты, получает меньший контекст и может отвечать быстрее. Тот же кейс обнаруживает цену фильтрации. Роутер способен удалить правильный инструмент или оставить модель без доступных действий.
Заявленных данных недостаточно, чтобы утверждать, что около двадцати инструментов в общем случае лучше девяноста. Состав корпуса не раскрыт, расхождение между 49 запросами и 44 оценёнными случаями не объяснено, полные логи отсутствуют. Результат gpt-4.1 на восьми запросах дополнительно показывает, что направление различия может зависеть от модели и типа задачи.
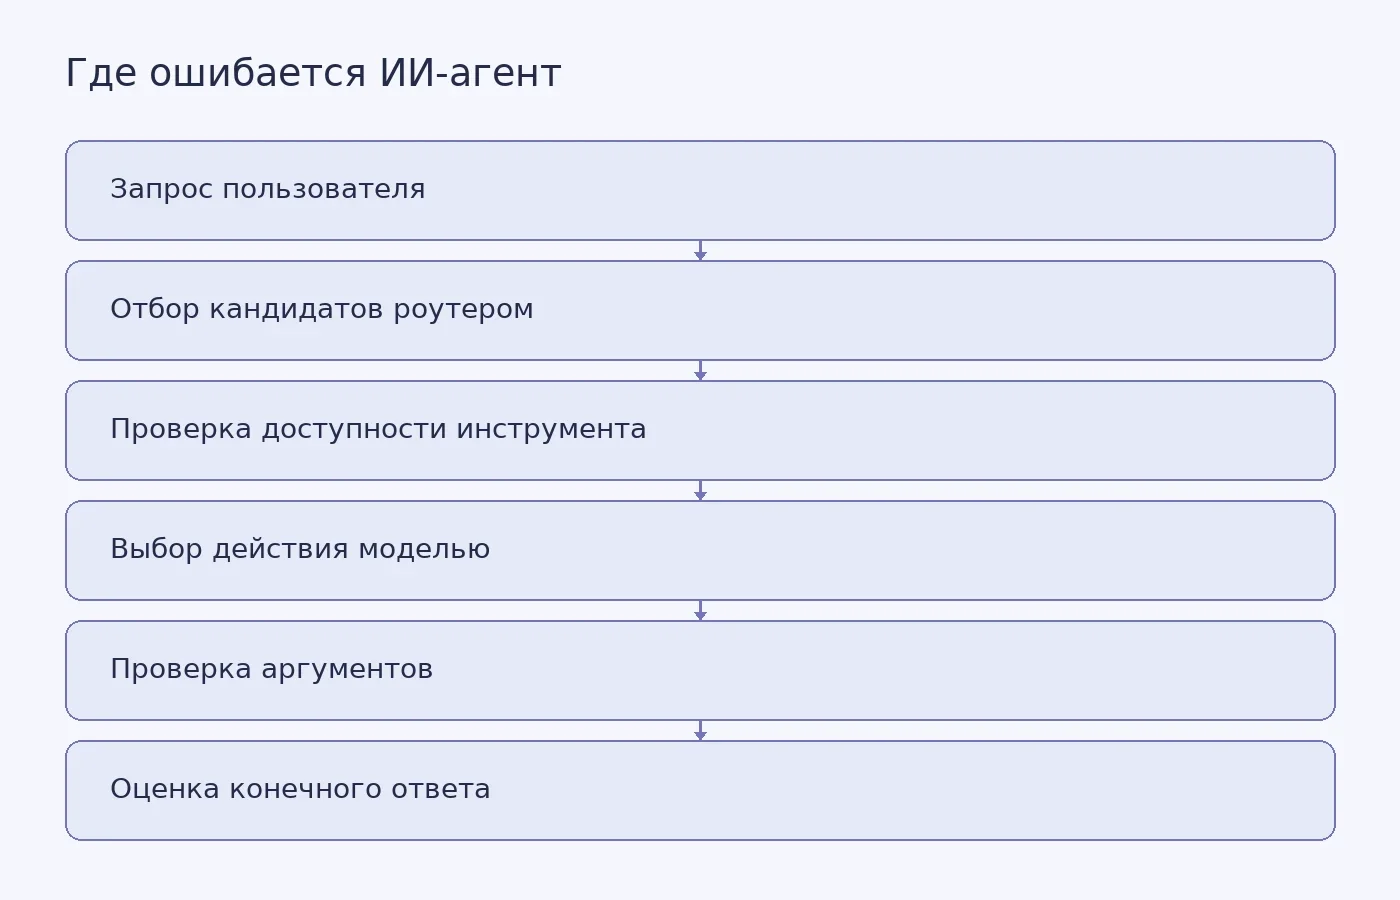
Практический смысл кейса состоит не в поиске универсального порога. Проверять нужно всю цепочку: работу роутера, наличие правильного инструмента, выбор модели, аргументы вызова и окончательный ответ. Только такое разложение покажет, помог ли короткий список самой модели или значительную часть задачи за неё выполнил фильтр.
Источники
- vad_bel. «Сколько инструментов показывать языковой модели: гипотеза, которую перечеркнул замер». Хабр. Полный авторский текст со статусом «Мнение». Точная календарная дата в доступной копии не указана.
- Профиль vad_bel на Хабре. Источник сведений о заявленных специализациях и местонахождении автора.
- Talos13. «Хорош хардкодить кривые MCP: превращаем любой скрипт в инструмент LLM за 2 секунды». Связанный инженерный материал о древовидной навигации по инструментам. Он описывает другой продукт и не подтверждает независимо результаты основного источника.


Похожие статьи
 Полезные материалы
10
мин
28.12.2022
31045
Список литературных источников в курсовой работе
Литературный обзор для курсовой – это обязательный структурный элемент работы, демонстрирующий умения автора исследования работать с информационными источниками и грамотно их систематизировать. В зависимости от темы исследования, в список используемой литературы могут входить законодательные а
 Полезные материалы
4
мин
21.12.2023
28406
Оформляем правильно список использованных источников в реферате
Многие студенты задаются вопросом о том, нужен ли список литературы в реферате? Да, ведь именно библиографический список реферата позволяет проверяющему преподавателю составить первое впечатление о качестве выполненной работы студентом вуза. Как составить список использованных источников в
 Полезные материалы
11
мин
04.03.2026
1
Анализ учебных данных с помощью смартфона: cписок процессов и инструментов
Чтобы фиксировать процесс обучения, студенту нужно учитывать расписание занятий, сроки выполнения, рассчитывать уровень концентрации, посещаемость занятий и продуктивность их проработки. Исключить предвзятую субъективную оценку о продуктивности работы помогут специальные инструменты-планировщики.
 Полезные материалы
10
мин
03.06.2022
10667
Готовимся к предзащите диссертации: список требуемых документов и последовательность действий
Предварительная защита диссертации – это процедура подготовки к официальной защите научной работы соискателя кандидатской/докторской ученой степени. Автор исследования излагает присутствующим итоговые результаты работы по теме исследования, которые оцениваются руководителем/консультантом
 Полезные материалы
13
мин
21.09.2026
1
Как выбрать тему курсовой, которую реально успеть сделать за семестр
Чтобы успеть написать курсовую работу за семестр, важно выбирать доступную тему. Так, слишком сложная проблема может требовать большего объема литературы, поиска труднодоступных данных, затратных расчетов и вычислений и т.д. Рассмотрим 7 критериев хорошей темы курсовой работы, какие категории нап
 Полезные материалы
15
мин
26.02.2026
1
Как адаптировать учебный график к региональным условиям
Как адаптировать учебный график к региональным условиям Чтобы улучшить успеваемость студентов при поступлении в иногородний вуз, преподавателям потребуется ответственно подойти к адаптации учебного графика к региональным условиям. В этом материале мы расскажем о том, в чем важность адаптации р
Последние новости и статьи
 Наука
3
мин
03.10.2026
CarboTaxol в день противораковой вакцинации усилил ответ T-клеток в доклинических моделях
Исследователи Оксфордского отделения Института исследований рака Людвига обнаружили, что противораковая вакцина сильнее действовала в нескольких доклинических моделях, если CarboTaxol вводили в тот же день. Когда химиотерапию и вакцинацию разделяли несколько дней, усиление исчезало. О результатах Ин
 Полезные материалы
11
мин
03.10.2026
Красный свет и метаболизм: что показывают исследования и где кончаются доказательства
Возьмите фонарик на телефоне, включите его и прижмите палец к источнику. Палец светится красным. Это не кровь: так рассеиваются фотоны красного света, которые ищут, где бы им поглотиться. С этого простого наблюдения начинается статья New Scientist, где астрофизик Боб Фосбери говорит: «Свет — это пит
 Наука
3
мин
03.10.2026
Графеновая мишень помогла лазеру разогнать протоны до 132 МэВ
Исследователи Университета Осаки разогнали протоны до энергии 132 МэВ с помощью длинного лазерного импульса и графеновой мишени нанометровой толщины. Это соответствует скорости, близкой к половине скорости света. Университет сообщил о результате 2 октября 2026 года, работу опубликовал журнал Progres
 Наука
5
мин
03.10.2026
Ретатрутид снизил массу тела на 25% в фазе 3, но в этом испытании его не сравнивали с аналогами
Экспериментальный препарат ретатрутид помог участникам рандомизированного исследования фазы 3 в среднем снизить массу тела на 25% за 80 недель при еженедельной дозе 12 мг. О результатах 3 октября 2026 года сообщил ScienceAlert со ссылкой на публикацию в The New England Journal of Medicine. В отдельн
 Полезные материалы
14
мин
03.10.2026
Что каталог из 11 742 глубоководных вирусных геномов говорит о хрупкости морских экосистем
На борту исследовательского судна керн тихоокеанского осадка выглядит почти непримечательно: узкая колонка грунта, разделенная на двухсантиметровые слои. Но именно из таких колонок, собранных в 2023 и 2024 годах, вырос каталог из 11 742 предполагаемых вирусных популяций.Это число нельзя понимать бук
 Полезные материалы
8
мин
03.10.2026
Почему занятие на улице начинается задолго до выхода из аудитории
В сентябре 2020 года Lisa Bonner проводила занятия по химии на скамьях для пикника под навесом во Флориде. Таблицу Менделеева закрепили на соседней стене. Когда начинался ливень, студентам приходилось тесниться под крышей, а шум воды мешал занятию. На этом проблемы не заканчивались: доски, хранившие