


Содержание статьи
Защита и размещение диссертации
12.11.2026
12.11.2026
8
мин
Представим модель, которая по видео почти безошибочно угадывает, как ответят нейроны зрительной коры мыши. Она справляется с новыми изображениями и переносится на других животных. Но объясняет ли такая модель работу мозга или лишь очень хорошо подбирает ответы?
Разница принципиальна. Точность на отложенных данных показывает, что модель умеет предсказывать ответы в проверенных условиях. Объяснение требует большего: связать наблюдение с определённым механизмом и вывести новое предсказание, которое можно проверить независимым опытом.
Сначала проверить перенос
В исследовании, опубликованном в Nature в 2025 году, Эрик Ван, Андреас Толиас и их коллеги построили модель зрительной коры мыши на записях примерно 135 000 нейронов у 14 бодрствующих животных. Общий «основной блок» модели обучили на данных восьми мышей, примерно 66 000 нейронов из шести зрительных областей. Пока животные ходили по беговой дорожке, им показывали естественные видео. Модель учитывала также положение глаза, движения и размер зрачка.
Первое строгое испытание для такой системы состоит в проверке на данных, которых она не видела во время обучения. Авторы использовали новые видеоролики и стимулы другого типа, в том числе движущиеся точки, шумовые узоры и статичные изображения. Такие тесты содержательнее обычной проверки на случайно отложенной части тех же примеров: они показывают, переносит ли модель усвоенные закономерности на другой набор зрительных сигналов.
Затем общий блок перенесли на новых мышей. Для настройки индивидуальных частей модели использовали от 4 до 76 минут записей. На естественных видео система с общим блоком достигала заданной точности с меньшим объёмом данных, чем модель, которую обучали отдельно для каждой мыши. Например, чтобы получить медианную нормированную корреляцию выше 0,65, индивидуальным моделям требовалось более 60 минут, а моделям с общим блоком было достаточно менее 30 минут. Это убедительное свидетельство переноса в пределах изученной зрительной системы, но не доказательство найденного биологического механизма.
Сопоставить модель с независимыми измерениями
Следующий уровень проверки выходит за пределы одной метрики предсказания. Если модель утверждает, что нейрон предпочитает определённую ориентацию или направление движения, эту настройку можно отдельно измерить у живого нейрона и сравнить результаты.
В работе Вана и коллег модель обучали на естественных видео, а затем проверяли её оценки настройки на специальных стимулах. Для этого использовали трёх новых мышей и около 30 000 нейронов. У нейронов с выраженной настройкой предпочтительные углы, рассчитанные моделью, в целом близко совпадали с измеренными в мозге. Например, у части нейронов с сильной избирательностью к ориентации медианное расхождение составляло 4°.
Так проверяют, соответствует ли характеристика модели отдельному наблюдаемому свойству. Но и эта проверка имеет пределы: сильная пространственная настройка была выражена лишь у меньшинства нейронов, а опыты проводили только на трёх животных. Сходство результатов поддерживает полезность модели, однако не показывает, что её внутренние вычислительные операции совпадают с вычислениями мозга.
Авторы также сопоставили параметры модели с анатомическими данными проекта MICrONS, где функции нейронов связывают с их строением. По параметрам модели удавалось предсказывать зрительную область с точностью 68% при случайном уровне 25%. Для 11 морфологических типов клеток точность составляла 32% при случайном уровне 9%. Дополнительная проверка показала, что предсказание типов клеток нельзя объяснить только глубиной, на которой записывали сигнал. Это связывает функциональное описание с анатомией, но точность классификации, особенно для типов клеток, ещё далека от безошибочной идентификации.
Решающая проверка: вмешательство и новый результат
Чтобы отличить объяснение от удачного описания данных, нужно проверить причинное предположение. Модель должна подсказать, что изменится при определённом воздействии, а эксперимент должен проверить это изменение в живой системе. Так можно выяснить, отражает ли предсказанная связь работу механизма или лишь совпадение в наблюдавшихся данных.
Пример такого исследовательского цикла связан с работой Катрины Франке, Константина Виллеке и их коллег, опубликованной в Nature в 2022 году. Исследователи изучали зрительную кору мышей с помощью регистрации активности нейронов, фармакологических воздействий и моделирования. Они обнаружили, что при расширении зрачка чувствительность зрительной коры смещалась в сторону ультрафиолетовых стимулов. Авторы связали эффект с изменением вклада фоторецепторов, палочек и колбочек. В этом случае модель дополняет измерения и вмешательство, а не заменяет их.
В статье 2025 года описаны главным образом предсказания активности и сопоставления с некоторыми функциональными и анатомическими характеристиками. Такие результаты помогают формулировать новые гипотезы и экономить время на отдельных измерениях, но сами по себе не доказывают причинный механизм. Обзор дискуссии в The Transmitter показывает, что именно здесь расходятся мнения нейробиологов: высокая предсказательная точность полезна, однако разные модели могут одинаково хорошо описывать одни и те же записи, не воспроизводя биологическую работу мозга.
Отсюда следует практическое ограничение. Если модель обучена предсказывать нейронные ответы, это ещё не значит, что она сможет надёжно предсказать последствия лекарства, поражения или изменения на молекулярном уровне. Для таких выводов нужны соответствующие биологические переменные и отдельные проверочные эксперименты. Работа 2025 года охватывает только части зрительной системы мыши в условиях пассивного просмотра. Авторы прямо называют моделирование сложного естественного поведения, других областей мозга и типов клеток задачами дальнейшей работы.
Что считать объяснением
Убедительная проверка модели складывается из нескольких ступеней. Она должна работать на данных вне обучающего набора, переноситься на новых животных, совпадать с независимыми функциональными или анатомическими измерениями и, главное, давать новое предсказание о результате воздействия, которое подтверждается опытом. Первые проверки показывают, насколько модель переносима и полезна. Последняя проверяет причинное объяснение.
Даже такой набор проверок не превращает любую точную модель в теорию мозга. Он уточняет, что уже подтверждено и какой следующий опыт способен опровергнуть предложенное объяснение. Для нейронауки полезная модель должна не только угадывать ответ, но и делать конкретное предсказание, которое можно проверить в живой системе.
Источники
- Wang, E. Y. et al. Foundation model of neural activity predicts response to new stimulus types. Nature, 2025. Рецензируемая статья, открытый доступ; на странице издателя указана авторская поправка от 8 апреля 2026 года.
- Franke, K. et al. State-dependent pupil dilation rapidly shifts visual feature selectivity. Nature, 2022. Рецензируемая статья; полный текст на странице издателя доступен по подписке.
- Mesa, N. Future of AI brain models sparks debate. The Transmitter, 11 ноября 2026 года. Журналистский обзор дискуссии, не первичное исследование.
О том, почему даже убедительный результат на животных нельзя автоматически переносить на человека, читайте в разборе исследования стареющего мозга мышей и границ такого переноса.
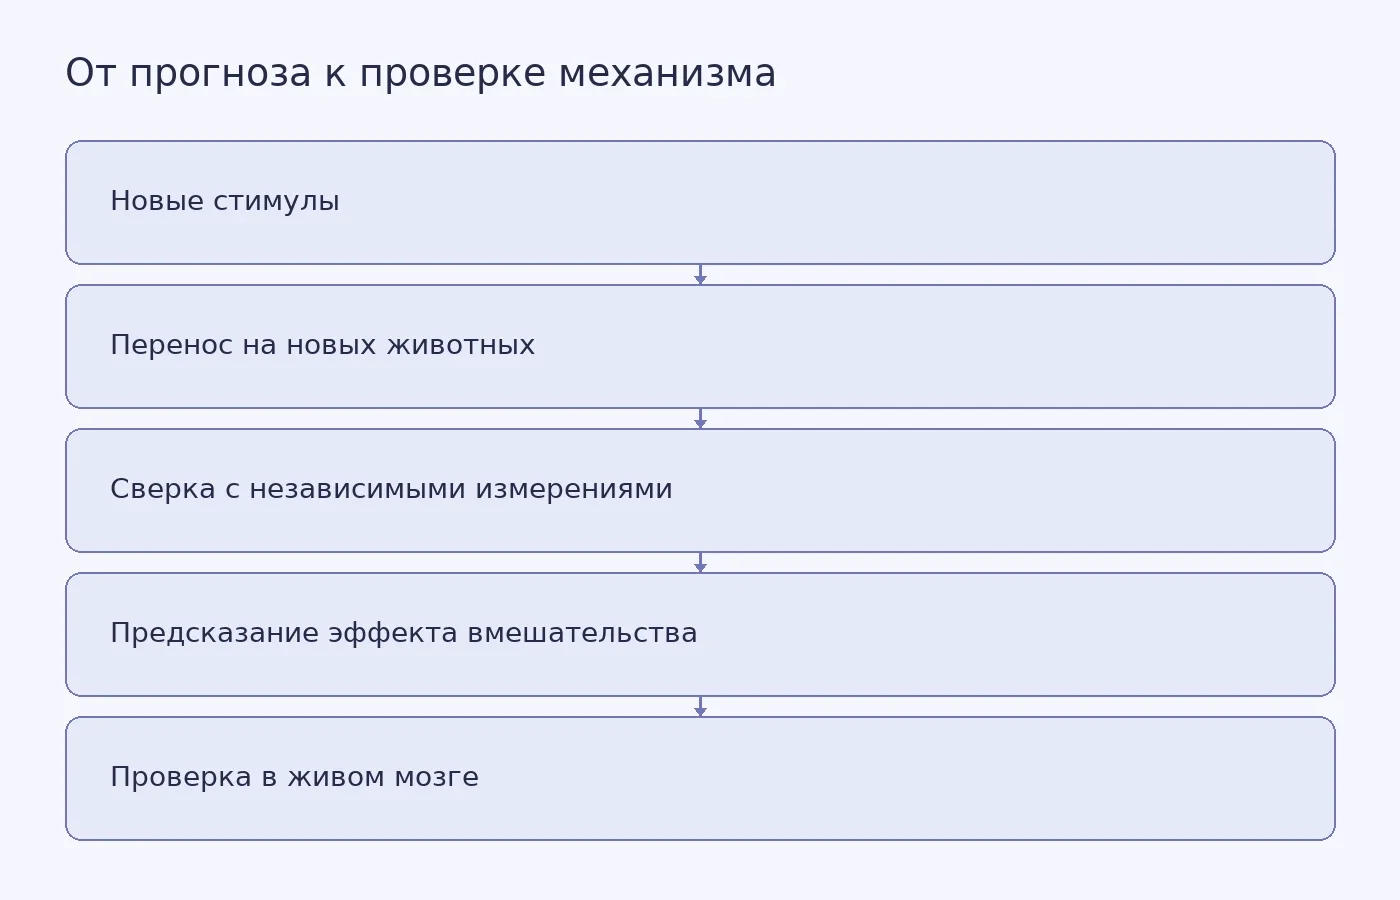
Фото: Google DeepMind / Pexels


Похожие статьи
 Защита и размещение диссертации
35
мин
04.11.2026
Как написать монографию по биологии или экологии: источники, наблюдения и представление результатов
Чтобы написать монографию по биологии или экологии, свяжите исследовательский вопрос с определённым объектом, материалом, способом наблюдения и границами вывода. Оглавление удобно строить после этой связки: тогда каждая глава объясняет, откуда взялось утверждение и как его проверить. Если вы готовит
 Защита и размещение диссертации
30
мин
07.11.2026
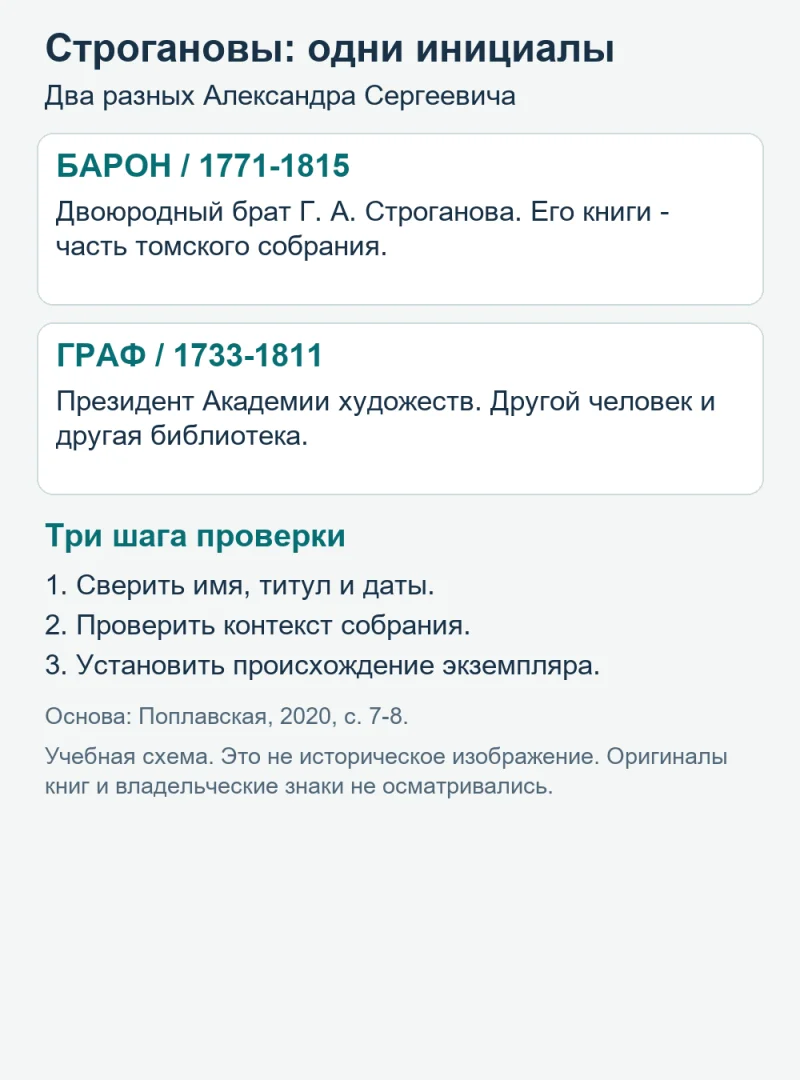
Региональные исторические монографии: Строгановы, Дальний Восток и поиск издания
Монографии о Строгановых, Дальнем Востоке или отдельном городе выбирают по исследовательскому вопросу, точному изданию и доступному тексту. Ни фамилия на обложке, ни слово «история» ещё не показывают, какая книга нужна для вашей работы. Если вы готовите собственную исследовательскую рукопись, цена н
 Защита и размещение диссертации
7
мин
12.11.2026
Гибкий графеновый электрод: что проверили и чего ещё не знаем
Графеновое покрытие на силиконовой подложке не отслаивается при растяжении. Это свойство легко принять за признак готовности материала к работе в организме. Но удержаться на месте и сохранять прежние электрические характеристики не одно и то же. Для гибкого нейроимпланта различие принципиально. Пово
Последние новости и статьи
 Наука
3
мин
12.11.2026
Электрическое поле меняет перенос тепла в нитридных материалах
Исследователи Корнеллского университета рассчитали, что направление электрического поля может менять теплопроводность нитрида алюминия. Работа вышла 11 августа 2026 года в журнале npj Computational Materials. В отдельном эксперименте с нитридом бора, опубликованном 9 ноября в Nano Letters, тепловое
 Вузы
1
мин
12.11.2026
В Курганском госуниверситете открылся российско-китайский образовательный центр
11 ноября 2026 года Курганский государственный университет открыл Российско-китайский центр образовательного и культурного сотрудничества. Он будет координировать взаимодействие с Китаем в Курганской области, содействовать приёму групп китайских студентов и помогать им адаптироваться к жизни в Росси
 Наука
2
мин
12.11.2026
Под давлением выше 222 ГПа лёд потерял кубическую симметрию
Исследователи из США сжали каплю воды между двумя алмазными наконечниками и обнаружили: при давлении выше 222(12) гигапаскалей лёд теряет кубическую симметрию. Результаты опубликовали 15 октября 2026 года в журнале Communications Chemistry. Рентгеновская дифракция показала, что кристаллическая решёт
 Кандидатские диссертации
36
мин
12.11.2026
Монографии о растениях и агротехнике: как выбрать литературу и проверить выводы опыта
Исследование яблоневого сада, работа о гречихе и обзор аминокислотных биостимуляторов требуют разных источников и разных способов проверки. Если вы планируете заказать монографию по собственным материалам о растениях, начните с вопроса исследования: какой объект изучается, что именно измерено и на к
 Помощь по написанию
32
мин
12.11.2026
Климат города, Красная Поляна и паргелии: как выбрать литературу
Монографии о климате города, исследования климатических параметров Красной Поляны и книги о паргелиях отвечают на разные вопросы: о свойствах городской среды, наблюдениях конкретной станции и атмосферной оптике. Автору собственной рукописи, который обсуждает стоимость написания монографии, полезно з
 Курсовые работы
31
мин
12.11.2026
Книги о пчёлах, широконоске и марале и источники по ветеринарной эндоскопии
Монографии о серой горной породе пчёл, утке-широконоске и марале нужно подбирать с учётом объекта исследования; литература об эндоскопических методах в ветеринарии требует ещё и проверки жанра. Порода, вид животного и диагностический метод — разные основания поиска. Ниже собрана библиографическая ка