
Содержание статьи
ИИ в образовании
02.10.2026
02.10.2026
5
мин
Исследователи Университета Фридриха Шиллера в Йене, Центра Гельмгольца в Мюнхене и Технического университета Мюнхена создали модель 2-step, которая предсказывает время выхода малых молекул из хроматографической колонки на новой измерительной системе. Статья вышла 1 октября 2026 года в Nature Methods. В отличие от многих прежних методов, нейросеть не нужно дополнительно обучать на сотнях измерений, полученных именно на целевом приборе.
При жидкостной хроматографии смесь проходит через колонку, но разные соединения задерживаются в ней на разное время. Последовательность и время их выхода помогают установить, какие молекулы находятся в образце. Проблема в том, что время удерживания зависит не только от структуры вещества. На него влияют колонка, состав растворителя, pH, температура, градиент и устройство прибора. Даже замена капиллярной трубки между колонкой и масс-спектрометром на более длинную может сдвинуть время выхода всех соединений, хотя их порядок останется прежним.
Сначала очередь, затем минуты
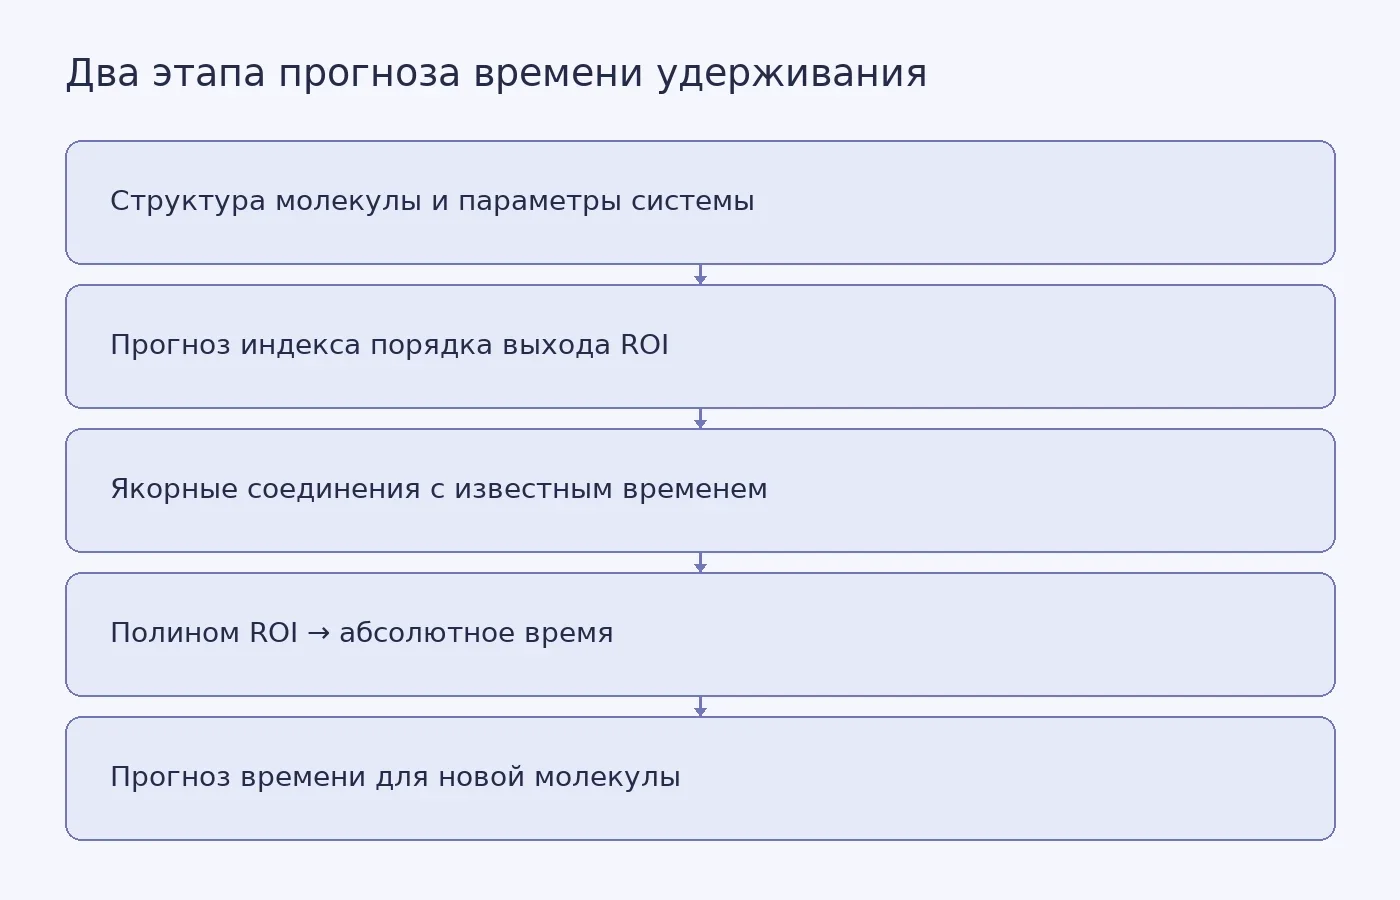
Модель решает задачу в два этапа. Сначала графовая нейросеть D-MPNN представляет молекулу в виде графа, где атомы служат узлами, а химические связи соединяют их. Одновременно модель получает сведения о хроматографической системе: pH подвижной фазы и 12 характеристик колонки из наборов HSM и Tanaka. Эти параметры описывают в том числе гидрофобность, стерическую избирательность и способность колонки образовывать водородные связи.
На первом этапе модель выдаёт не время в минутах, а ROI, индекс положения молекулы в очереди выхода. Если при заданных условиях молекула A должна покинуть колонку раньше молекулы B, её индекс должен быть меньше. Такой порядок обычно сохраняется лучше, чем абсолютное время, которое может сдвигаться или растягиваться при переходе между приборами.
На втором этапе ROI переводят в минуты. Для этого нужны якоря: соединения с надёжно установленной структурой и уже измеренным временем выхода на целевой системе. По ним строят зависимость между индексом и временем с помощью полинома второй степени. Сначала авторы применяли медианную регрессию, чтобы исключить выбросы, затем уточняли коэффициенты методом наименьших квадратов. В основном описании метода указано около 30 уверенно аннотированных соединений, однако в отдельных проверках для настройки соответствия хватало 15 якорей.
Представим анализ образца на новом приборе, где точно распознаны 15 соединений. Они становятся отметками на шкале. Для неизвестной молекулы 2-step сначала определяет предполагаемое место в очереди выхода, а затем переводит его во время по кривой, построенной на якорях. Модель не получает минуты из одних только структурных формул: ей необходимы параметры хроматографической системы и несколько надёжных опорных измерений. При этом саму нейросеть не приходится заново обучать на сотнях стандартов.
Как модель прошла проверку
Нейросеть обучили на 171 наборе данных обращённо-фазовой хроматографии из репозитория RepoRT. Во время проверки целевой набор каждый раз исключали из обучения. Ошибка модели, которая учитывала параметры хроматографической системы, составила 4,89% при обычном разбиении данных.
Отдельно авторы проверили наиболее трудные пары соединений, способные менять порядок выхода при изменении установки. При обычном разбиении учёт параметров системы повысил точность с 40,1% до 60,5%. При более жёстком разбиении она выросла с 29,7% до 44,6%.
Модель также сравнили с DeepGCN-RT и RT-Transformer. При реалистичном разбиении 2-step показала лучший результат на пяти из шести наборов данных, а на шестом работала примерно на том же уровне. При этом модель ROI не обучалась на целевых наборах.
В прикладной проверке исследователи использовали данные LC-MS/MS для образцов человеческого кала. Для этого набора были известны времена удерживания только 19 аутентичных стандартов. Из-за малого числа измерений и высокой структурной схожести стандартов обычное дообучение сравниваемых моделей применить было нельзя.
Где метод пока не работает
Результаты относятся только к обращённо-фазовой хроматографии. Для HILIC механизмы разделения и свойства колонок разнообразнее, а общепринятого набора параметров для описания их избирательности пока нет. Перенос прогноза также требует HSM- или Tanaka-характеристик колонки, которые доступны не для всех моделей.
Есть и ограничения у самой оценки. Точность на самых сложных парах соединений лишь немного превышала случайный выбор. Кроме того, даже названное авторами «реалистичным» разбиение может давать более благоприятную картину, чем работа с биомолекулами, сильно отличающимися по структуре от обучающих данных.
Воспроизводимость такого метода зависит не только от кода, но и от точного описания условий, данных и результатов, которое входит в оформление научной статьи. Смысл 2-step при этом довольно узок: модель не устраняет различия между хроматографическими системами. Она отделяет сравнительно устойчивую очередь выхода молекул от изменчивой шкалы времени, а затем восстанавливает эту шкалу по нескольким якорям.
Похожие статьи
 ИИ в образовании
2
мин
30.09.2026
Google DeepMind разработала скрытую метку для спроектированных ИИ белков
Исследователи Google DeepMind 30 сентября 2026 года описали в Nature систему SynthIDBio для маркировки белков, спроектированных искусственным интеллектом. Скрытый статистический сигнал встраивается одновременно в аминокислотную последовательность и трёхмерную структуру молекулы. Как SynthIDBio фикс
 ИИ в образовании
2
мин
28.09.2026
Магистранты ИТМО создали для Авито ИИ-помощника для проверки заданий
Магистранты программы AI Talent Hub Университета ИТМО разработали для образовательных проектов Авито прототип Avito AI Reviewer. Во внутреннем тесте система выполняла предварительный разбор одной домашней работы в среднем за 82,9 секунды, а стоимость одного запуска составляла около 0,41 рубля. Как
 ИИ в образовании
2
мин
28.09.2026
Языковые модели оценили общий ИИ оптимистичнее участников опросов
Авторы исследования, опубликованного 23 апреля 2026 года в журнале Humanities and Social Sciences Communications, сравнили отношение семи больших языковых моделей и трёх независимых выборок людей к общему искусственному интеллекту. По пятибалльной шкале модели получили от 3,32 до 4,12 балла, тогда к
 ИИ в образовании
3
мин
02.10.2026
Google представила Gemini 4 Argon: заявлены поиск уязвимостей и доступ по программе Fairwind
Google представила модель Gemini 4 Argon, ориентированную на программирование, сложные профессиональные задачи и кибербезопасность. Об этом 2 октября 2026 года сообщил Kazinform со ссылкой на CNBC; первичный пресс-релиз Google в переданных материалах не приводится, поэтому детали ниже — это заявленн
 ИИ в образовании
3
мин
02.10.2026
Google ограничила доступ к Gemini 4 Argon: модель отдали только проверенным специалистам по кибербезопасности
Google 1 октября 2026 года объявила, что не выпускает свою самую мощную модель Gemini 4 Argon для широкой публики. Доступ к ней получит только проверенная группа специалистов по кибербезопасности. Об этом сообщило агентство AFP. Компания объясняет решение так: безопасно выпускать возможности такого
 ИИ в образовании
2
мин
28.09.2026
В ИТМО испытали сервис, который сверяет текст диплома с программным кодом
В Университете ИТМО разработали OSA.Edu — инструмент для проверки выпускных работ по программированию. Он сопоставляет пояснительную записку с репозиторием проекта и показывает, где заявленные в тексте функции расходятся с реализацией. Разработка прошла пилотную проверку на работах магистрантов факу
Последние новости и статьи
 Вопросы студентов
9
мин
03.10.2026
Изменения ЕГЭ-2027: что уже опубликовано ФИПИ и чем это отличается от 2026 года
К началу октября 2026 года на сайте ФИПИ лежат два набора документов, и их легко перепутать. Один описывает экзамен, который уже прошёл общественное обсуждение и утверждён, — это КИМ ЕГЭ 2026 года. Второй только предложен к обсуждению: это проекты документов, определяющих структуру и содержание КИМ
 Наука
3
мин
02.10.2026
В Салиш-Си описали два новых вида морских пауков
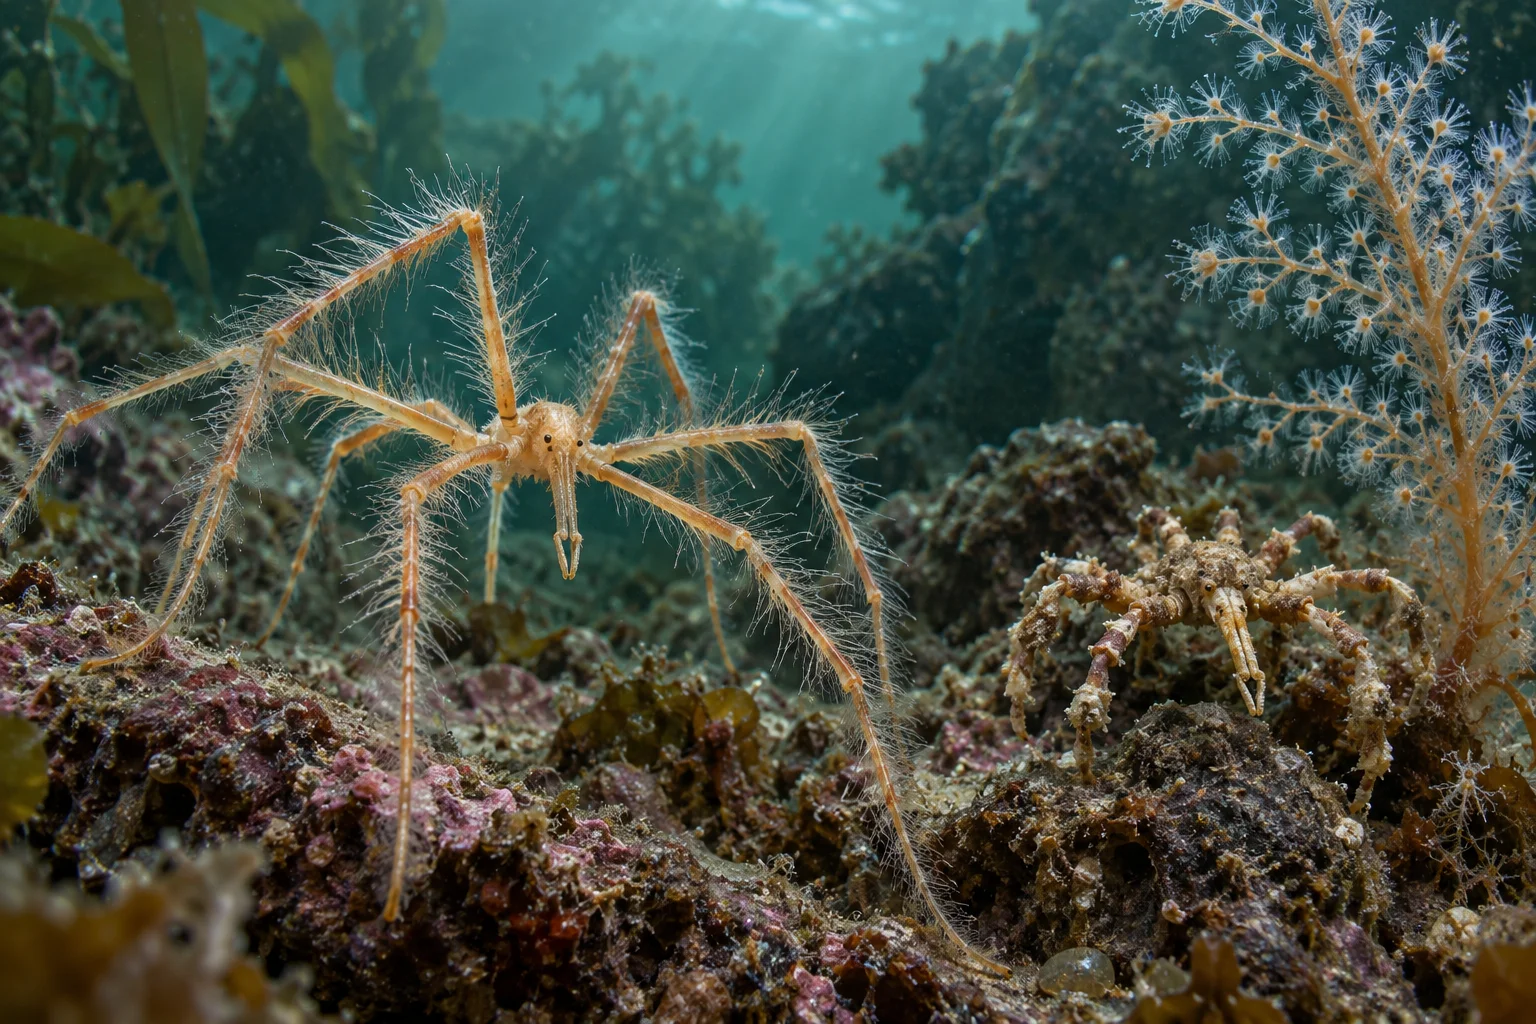
Исследователи из Университета Британской Колумбии описали два ранее неизвестных вида морских пауков, или пикногонид, в экорегионе Салиш-Си у западного побережья Канады. Статья вышла 26 августа 2026 года в журнале Organisms Diversity & Evolution. Научно-популярный журнал Nautilus назвал находку п
 Наука
3
мин
02.10.2026
Зимнее усиление грибковой инфекции изменило выпуск йосемитских жаб в природу
Исследователи Калифорнийского университета в Лос-Анджелесе и национального парка Йосемити обнаружили, что инфекция грибком Batrachochytrium dendrobatidis (Bd) сильнее всего нарастает у йосемитских жаб во время зимовки в подземных норах. О результате UCLA сообщила 1 октября 2026 года в материале, опу
 Наука
4
мин
02.10.2026
ИИ снизил ошибки моделирования аэрозолей примерно наполовину
Спутник замечает аэрозоли по отражённому свету: частицы пыли, дыма или морской соли меняют яркость, которую фиксирует прибор. Такие измерения давно питают модели, но обычно не напрямую. Сырые данные видимого и инфракрасного диапазонов слишком дорого встраивать в расчёты, поэтому их сначала перерабат
 Полезные материалы
12
мин
02.10.2026
Почему специализация опылителей зависит от климата, а не только от широты
Представим условный цветущий сад. На одном растении кормятся пчела, муха и бабочка, а соседний цветок посещает только один вид насекомых. Кажется, что одни опылители разборчивы, а другие берут любой доступный ресурс. Но в экологическом исследовании одного наблюдения недостаточно. Нужно знать, какие
 Полезные материалы
11
мин
02.10.2026
Повседневные практики безопасности в классе при продолжающемся стрессе: что предлагают источники и чего они не доказывают
Вопрос, который здесь разбирается, звучит так: какие повседневные действия учителя поддерживают у детей ощущение безопасности при продолжающемся стрессе — и где проходит граница, за которой педагог начинает подменять психологическую помощь? Короткий ответ по доступным материалам: источники предлагаю