


Содержание статьи
ИИ распознал ишемическую болезнь по фото лица и языка, но массовый скрининг не проверяли
Наука
19.10.2026
19.10.2026
3
мин
Исследователи из Китая обучили модель искусственного интеллекта распознавать ишемическую болезнь сердца по фотографиям лица и языка. В статье, опубликованной 18 сентября 2026 года в журнале Scientific Reports, сообщается о высокой точности на тестовой выборке. Но в испытании сравнивали людей с уже диагностированной болезнью и здоровых добровольцев, а не проверяли случайно отобранных людей, которым предстоял бы массовый скрининг.
Что именно проверили исследователи
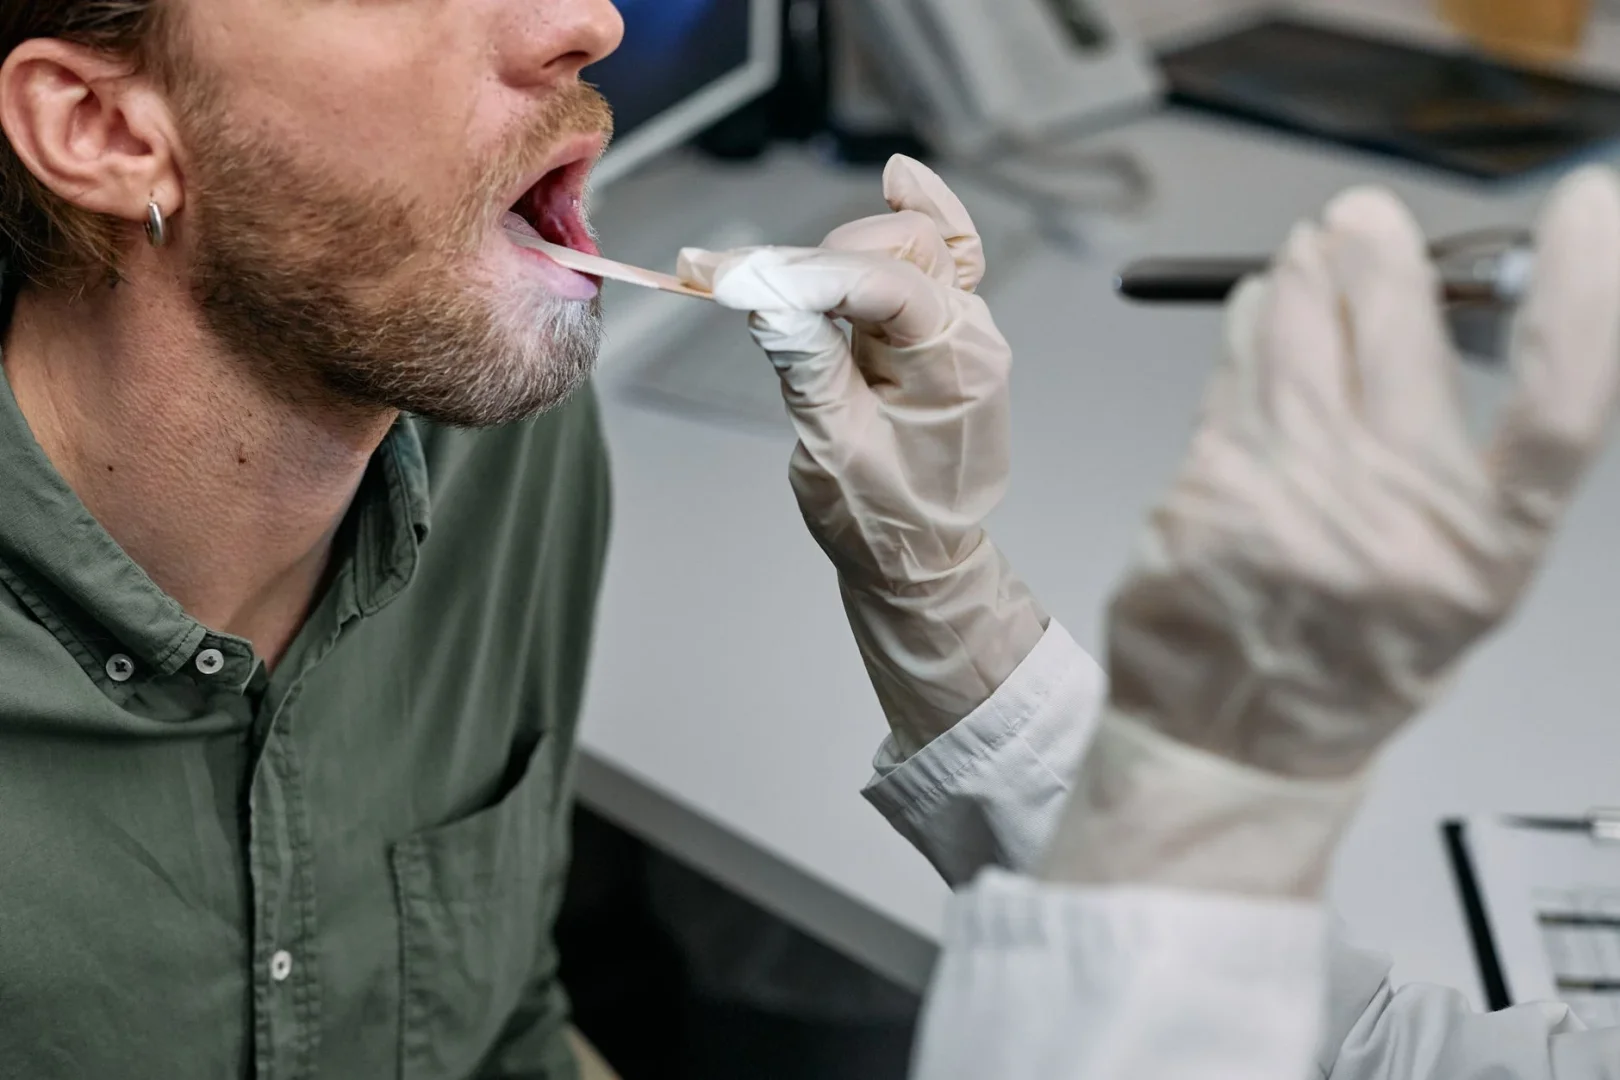
Команда включила в исследование 200 пациентов с ишемической болезнью сердца и 318 здоровых участников. Их фотографировали на специальном оборудовании при контролируемом освещении. Модель анализировала снимки лица и языка отдельно, а также вместе. По данным Medical Xpress, в независимой тестовой выборке она распознала всех 40 пациентов с болезнью, но ошибочно отнесла к больным двух здоровых людей. Для модели, объединявшей оба типа изображений, в статье указаны площадь под кривой ошибок (AUC) 0,9992 и показатель F1 0,9756.
Эти показатели описывают работу алгоритма на конкретной выборке. Они не говорят, как он поведёт себя при проверке населения. Если болезнь встречается редко, даже небольшая доля ложных тревог может привести к тому, что на дополнительные обследования направят многих здоровых людей. Представим условную проверку десяти тысяч человек, среди которых болезнь есть лишь у небольшой части. Даже редко ошибающийся тест может ошибочно указать на болезнь у заметного числа людей по сравнению с теми, у кого её действительно обнаружили.
Модель не проверяли в других больницах и при иных условиях съёмки. Кроме того, коронарную визуализацию, которая позволяет оценить артерии сердца, провели не всем участникам здоровой группы. Поэтому нельзя исключить, что у кого-то из них болезнь осталась незамеченной. Наконец, алгоритм мог опираться на возраст или сопутствующие заболевания, связанные с составом выборки, а не на признаки самой болезни.
Чтобы понять, подходит ли метод для скрининга, нужны более крупные исследования: с наблюдением за людьми во времени, проверкой на невыявленную болезнь и сравнением с действующими способами оценки риска. Сейчас врачи учитывают возраст, курение, давление, холестерин и диабет. Результаты китайской команды показывают, что в её тесте совместный анализ снимков лица и языка сработал лучше, чем анализ каждого типа изображений по отдельности. Но исследование не подтверждает, что этот подход готов заменить обследование или стать инструментом массовой диагностики.
Для работы с научными публикациями можно обратиться к услуге подготовки научных статей.
Фото: cottonbro studio / Pexels
Похожие статьи
 Наука
3
мин
09.10.2026
ИИ-модели меняли лица по стереотипам об ориентации и криминальном прошлом
Исследователи во главе с Ашиком ХудаБукхушем проверили, как две модели для работы с изображениями меняют лица по запросам о сексуальной ориентации, расе и криминальном прошлом. В опытах использовали 1002 созданных ИИ лица. О результатах ХудаБукхуш рассказал в статье для The Conversation, опубликован
 Наука
1
мин
28.09.2026
Учёные ТПУ повысили эффективность фотолюминесценции керамики с 20% до 24%
Исследователи Томского политехнического университета повысили эффективность фотолюминесценции керамического композита с церием с 20% до 24%. Для этого поверхность материала обработали карбид-кремниевой наждачной бумагой, изменив её шероховатость без корректировки химического состава. Эффект обработ
 Наука
3
мин
16.10.2026
Почему рак у молодых взрослых в Англии растёт быстрее: исследование не нашло полного объяснения
Исследователи из Великобритании изучили заболеваемость раком в Англии с 2001 по 2019 год. У людей младше 50 лет некоторые виды рака встречались всё чаще, причём быстрее, чем у старших. Избыточная масса тела была связана с большинством изученных видов, но не объясняла всей динамики. Результаты опубли
 Наука
2
мин
11.10.2026
Берёзовый дёготь подавил рост одной бактерии в лабораторном опыте
Исследователи из университетов Кёльна, Оксфорда, Льежа и Кейп-Бретона проверили, как берёзовый дёготь действует на бактерии. В лабораторном тесте пять из шести образцов в разной степени подавляли золотистый стафилококк, но ни один не подействовал на кишечную палочку. Результаты опубликованы 18 марта
 Наука
2
мин
18.10.2026
В музейной коллекции нашли крупнейшего североамериканского рака
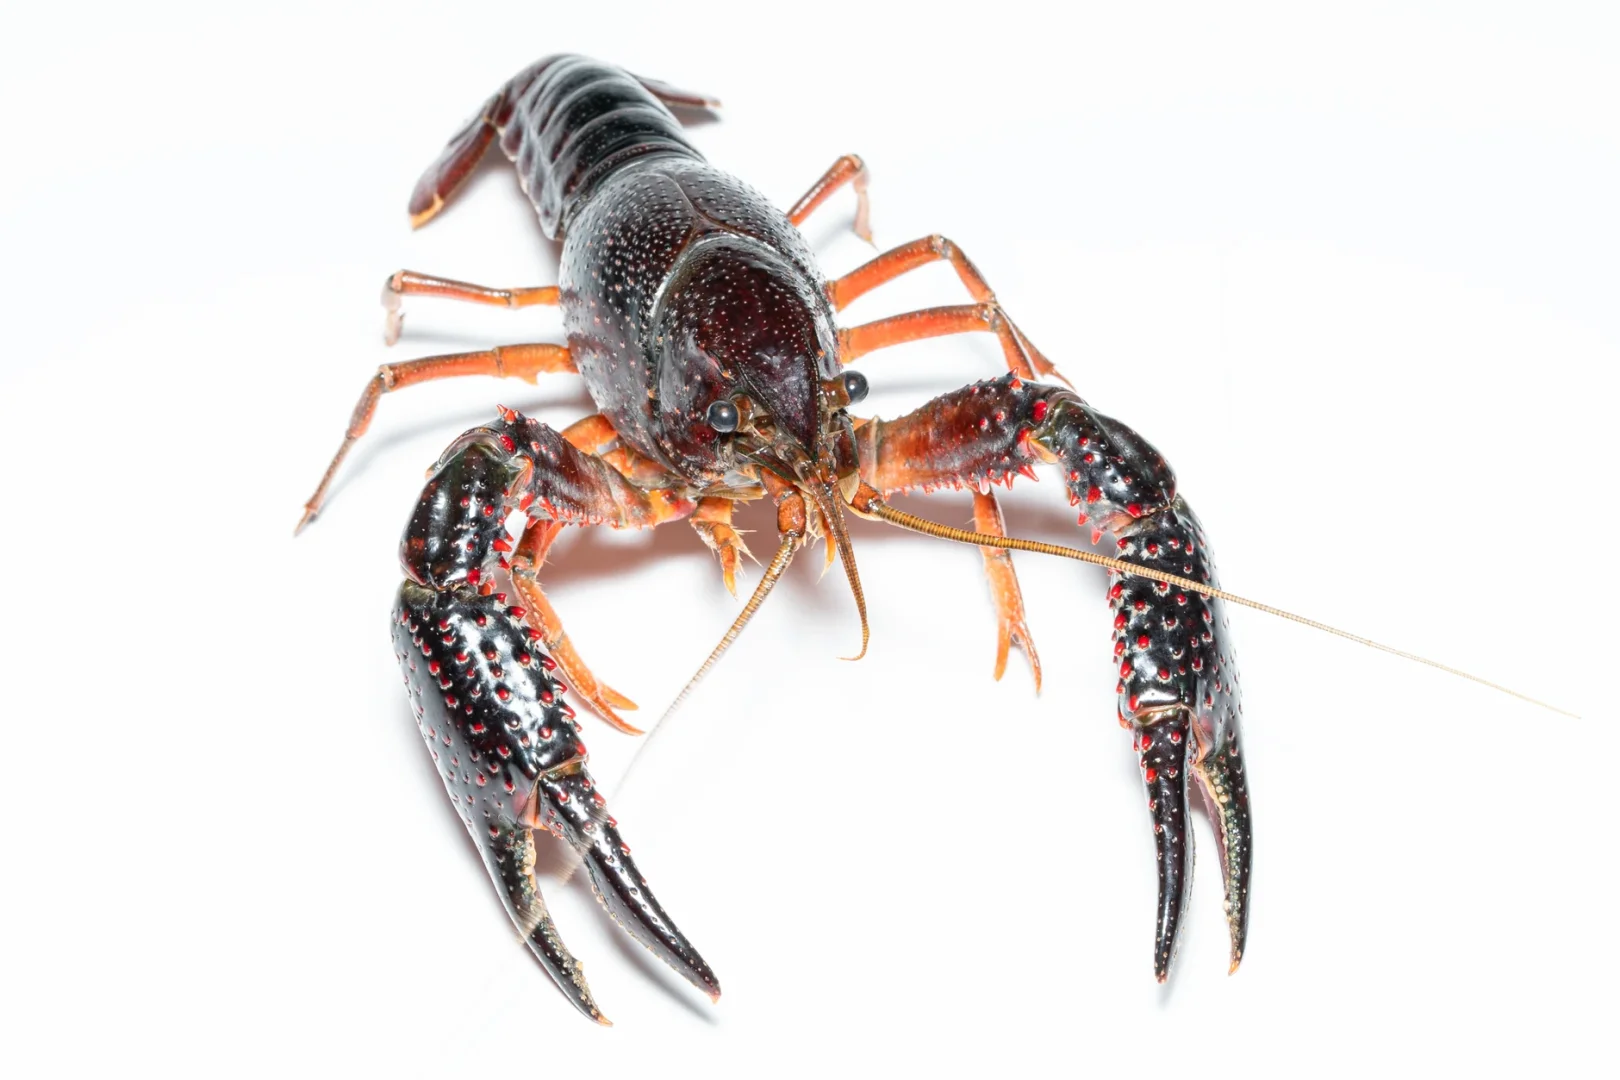
15 октября 2026 года Колледж сельскохозяйственных, потребительских и экологических наук Иллинойсского университета сообщил о крупнейшем из найденных североамериканских раков. Экземпляр теннессийского щеточного рака хранится в коллекции Университета Западной Свободы в Западной Виргинии. Его собрали в
 Наука
3
мин
17.10.2026
ВИЧ находил обход VRC01: исследователи проследили мутации ускользания
Исследователи из ЮАР и других стран проследили, как ВИЧ менялся после заражения у участников испытаний профилактического антитела VRC01. Новые мутации, позволявшие вирусу ускользать от антитела, обнаружили у 8 из 26 получавших VRC01 и ни у одного из 21 участника группы плацебо. Статья вышла онлайн 2
Последние новости и статьи
 Наука
3
мин
19.10.2026
Людей точнее оценивали, когда их предпочтения отличались от собственных
Участники двух поведенческих экспериментов точнее оценивали предпочтения незнакомца, если считали его вкусы непохожими на собственные. Работу с участием 118 человек описал Phys.org 16 октября 2026 года. Исследователи проверяли, как личные предпочтения влияют на суждения о других людях и группах.Как
 Наука
2
мин
19.10.2026
Карликовые тростниковые змеи спасаются от опасности кувырками
Карликовые тростниковые змеи рода Pseudorabdion спасаются от опасности кувырками. В статье Nautilus от 19 октября 2026 года говорится, что исследователи изучили это движение по видеозаписям с нескольких ракурсов и выяснили, как змеи удерживают голову по направлению движения, пока туловище вращается.
 Поступление
2
мин
19.10.2026
Россотрудничество намерено изменить отбор иностранных абитуриентов
19 октября 2026 года глава Россотрудничества Игорь Чайка заявил, что ведомство намерено перейти к целевому набору иностранных абитуриентов, претендующих на обучение в российских вузах по правительственной квоте. Чайка объяснил идею тем, что выпускники должны иметь возможность вернуться домой и строи
 Полезные материалы
7
мин
19.10.2026
Позитивный настрой и простуда: что проверяли в опытах с риновирусом
В лабораторных опытах добровольцам закапывали в нос риновирус, а затем наблюдали за ними в карантине. Такой подход помогал отделить два вопроса: заразился ли человек и насколько выраженными оказались симптомы. В двух исследованиях более частые положительные эмоции были связаны с меньшим риском прост
 Вопросы студентов
6
мин
19.10.2026
Приложения для студентов-юристов: сравнение КонсультантПлюс и ГАРАНТ
На семинаре нужно быстро найти норму о защите прав потребителей, а при подготовке курсовой важно понять, где искать документ и как проверить его редакцию. В таких ситуациях могут пригодиться правовые приложения. По описаниям разработчиков и карточкам магазинов сравним два варианта: «КонсультантПлюс:
 Вопросы студентов
8
мин
19.10.2026
Приложения для совместной работы над учебным проектом: Notion и Trello
В учебном проекте быстро накапливаются разные задачи: нужно собирать материалы, следить за сроками и вместе редактировать текст. Одно приложение может закрыть часть этих потребностей, но выбирать его лучше по рабочему процессу, а не по длинному списку популярных функций. Ниже Notion и Trello сопоста