


Содержание статьи
Наука
05.11.2026
4
мин
Физик Пулин Гонг и его аспирант Эндрю Лай из Университета Сиднея разобрались, почему две одинаковые нейросети, обученные на одних и тех же данных, нередко приходят к разным решениям. Ответ оказался геометрическим: пространство стартовых настроек сетей устроено как фрактал. Работа вышла 5 ноября 2026 года в Nature Machine Intelligence. Доводы подкреплены масштабом: авторы обучили около 500 тысяч сетей разных архитектур, от VGGNet и ResNet до BERT, на наборах данных MNIST, CIFAR-10 и IMDB, варьируя оптимизаторы, регуляризацию и функции активации.
Карта, где каждое пятно пронизано чужим цветом
Карту стоит нарисовать так: каждая точка на ней соответствует стартовой настройке сети, а цвет точки показывает, к какому итоговому решению придёт обучение. Области одного цвета математики называют бассейнами притяжения. На привычной карте граница между цветами извилиста, но твёрдая: шагнул в сторону от края, и вы уже надёжно внутри одной области.
У нейросетей исследователи обнаружили другое. Бассейны здесь «изъеденные» (riddled basins), фракталы особого рода: внутри любой, даже исчезающе малой окрестности точки одного бассейна лежат точки другого. Чем сильнее увеличиваешь карту, тем больше видишь нового переплетения цветов, и так без предела. В минимальной двухслойной модели это заметно прямо на глазах: карта стартовых точек складывается в узор, напоминающий бабочку, а каждое увеличение открывает всё более мелкое сплетение синего и оранжевого.
Представим упрощённый условный пример. Две сети распознают рукописные цифры, учатся на одних и тех же данных, и их стартовые веса различаются только в последнем знаке после запятой. В обычной системе обе сошлись бы почти на одинаковом решении. Здесь же внутреннее устройство одной может заметно отличаться от устройства другой, и заранее сказать, какая из них чем закончит, невозможно.
Что показали числа
Числа это подтверждают. Сдвиг стартовой настройки на один бит, минимальное различие, которое вообще способен зафиксировать компьютер, отправлял обучение к другой внутренней конфигурации примерно в 48% случаев. Когда стартовые настройки делали точнее в десять миллиардов раз, воспроизводимость не выросла измеримо. Доля несовпадающих предсказаний у сетей из почти одинаковых стартов (churn) держалась около 2,9% и не падала.
Математически это описывает показатель неопределённости, близкий к нулю: в минимальной модели он равен 0,0126 ± 0,0002, в глубокой сети 0,000 ± 0,002, причём одинаково и на детерминированном CPU, и на обычном GPU. Чем ближе показатель к нулю, тем меньше проку от уточнения стартовых условий.
Эффект сохранялся даже в полностью детерминированной среде, где повторный прогон без изменения стартовых значений дал бы в точности тот же результат. Значит, причина не в случайности железа или порядка подачи данных, а в самой геометрии пространства параметров.
Компромисс, который сложно обойти
Исследование выявило и неудобный размен. Настройки, при которых сеть учится лучше всего, делают исход менее воспроизводимым. Снижение скорости обучения (learning rate) возвращало воспроизводимость, но сеть училась хуже. Авторы советуют не пытаться полностью «выключить» непредсказуемость инженерными средствами, а измерять её и по возможности менять архитектуру, убирая математические условия, которые порождают нестабильность.
Есть важная оговорка о масштабе. Детальный анализ выполнен на намеренно упрощённых конфигурациях, например на 12-слойной сети VGG-12 примерно с 12 тысячами параметров, а не на современных больших моделях. Связь фрактальной геометрии с практическими сбоями воспроизводимости авторы называют кандидатом в объединяющий принцип, а не доказанным для всех систем ИИ фактом. Однако характерные признаки они наблюдали во всех проверенных конфигурациях.
Для русскоязычного читателя, пишущего о машинном обучении, тема воспроизводимости актуальна при подготовке собственной публикации: помощь в написании научных статей часто включает как раз методологическую выверку результатов.
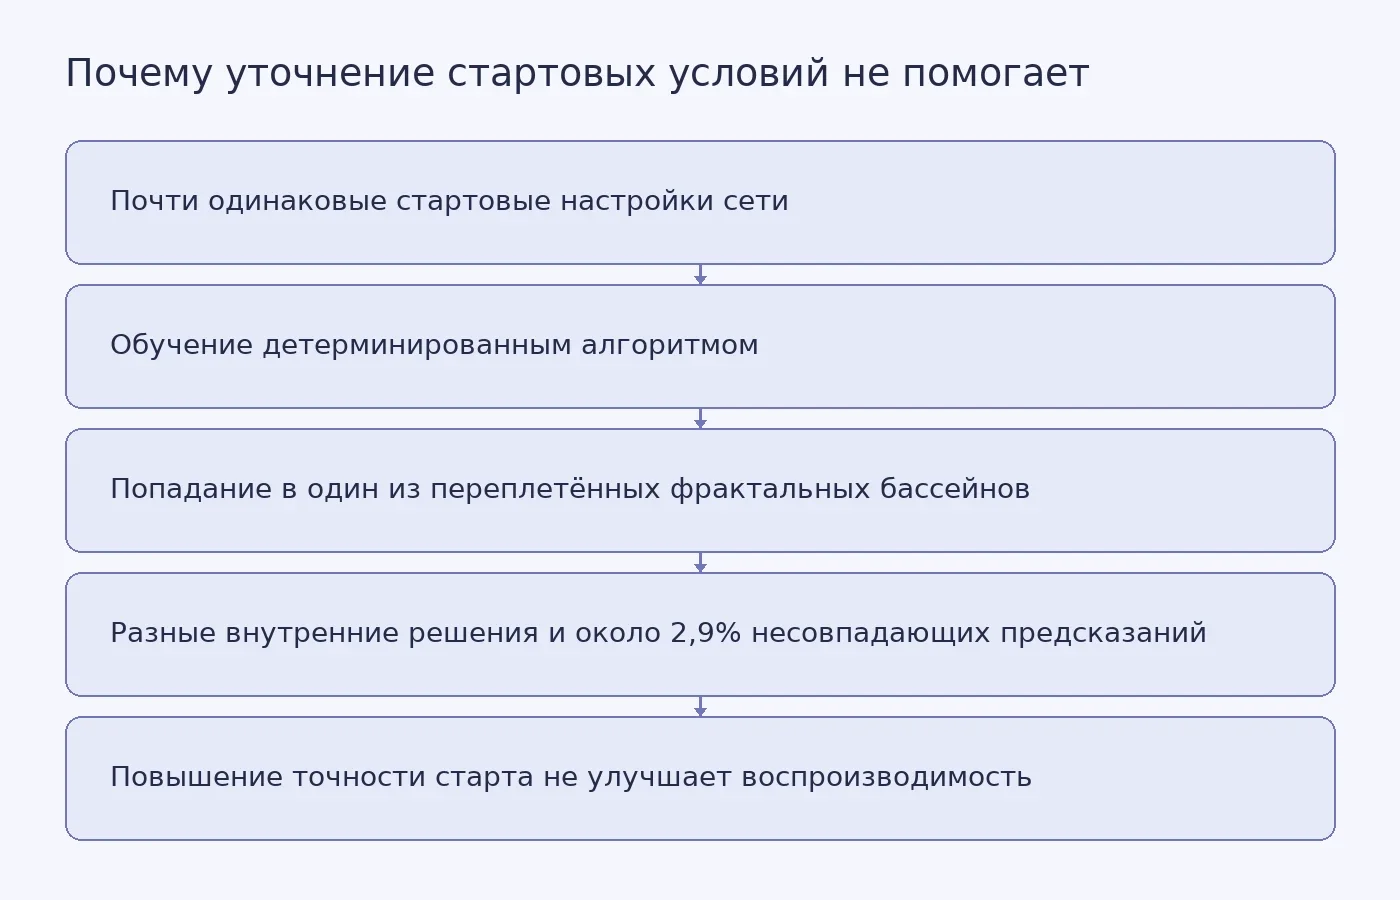
Фото: Merlin Lightpainting / Pexels
Похожие статьи
 Наука
2
мин
07.10.2026
В шести частицах из Чернобыля сохранилась структура ядерного топлива
Исследователи из Лейбницского университета Ганновера и Центра имени Гельмгольца в Дрездене-Россендорфе изучили шесть радиоактивных частиц из украинской почвы. Рентгеновский анализ показал, что кристаллическая структура ядерного топлива в них в основном сохранилась, а сами фрагменты удерживают продук
 Наука
2
мин
21.10.2026
Модель машинного обучения нашла сигнал перед ослаблением полярного вихря
Команда Boscu обнаружила в компьютерной модели атмосферы сигнал, который возникает перед ослаблением полярного вихря. О результатах сообщил журнал Eos 20 октября 2026 года. Исследователи получили их на симуляции, а не при прогнозировании реальных внезапных стратосферных потеплений.Четыре группы сост
 Наука
2
мин
14.10.2026
Нейросеть MIT сама собрала механизм обучения из простых правил
Исследователи Массачусетского технологического института показали, что искусственная нейросеть со случайными связями может сама выстроить контуры для обработки информации. Модель распознавала закономерности и классифицировала изображения. В этих задачах она справилась на уровне, сопоставимом с сетям
 Наука
4
мин
05.11.2026
Ультрафиолетовый «листодув» объясняет яркость галактик ранней Вселенной
Телескоп «Джеймс Уэбб» снова поставил астрономов перед неудобным вопросом. В первые сотни миллионов лет после Большого взрыва ярких галактик оказалось больше, чем предсказывали модели. 4 ноября 2026 года в The Astrophysical Journal вышла работа Шьяма Менона из Института Флэтайрона и Аарона Смита из
 Наука
3
мин
17.10.2026
Мозг заранее готовился к изображению или давлению на палец
До того как участники увидели изображение или почувствовали давление на палец, активность верхнего холмика уже различалась в зависимости от ожидаемого сигнала. К такому выводу пришли авторы исследования, изучив данные МРТ 80 взрослых. Статья Danlei Chen и коллег вышла 7 октября 2026 года в журнале N
 Наука
4
мин
04.11.2026
Роботизированная кисть стала реже ронять предметы благодаря отдельному фильтру безопасности
Роботизированная рука умела подолгу перекладывать предмет между пальцами, но периодически его роняла. Инженеры из Калифорнийского университета в Беркли и Дейвисе добавили отдельный программный фильтр безопасности, который следит только за удержанием предмета. За 1200 попыток с внешними камерами слеж
Последние новости и статьи
 Наука
4
мин
05.11.2026
В реках Гондураса и Сальвадора нашли моллюсков, которых не замечали десятилетиями
Три статьи в рецензируемых журналах Check List и Zootaxa подвели итог полевым работам в Гондурасе и Сальвадоре. Команда, в которую вошли исследователи из Гондурасского института биологических и экологических наук (IBIOAH), сальвадорского Министерства окружающей среды и природных ресурсов, Университе
 Наука
4
мин
05.11.2026
«Кристаллическая губка» с фенантреном разобрала 24 структуры из 30
Маленькие малополярные молекулы, которые годами ускользали от рентгеноструктурного анализа, поддались палладиевой «кристаллической губке», если в её полость запустить второго жильца — фенантрен. Об этом сообщается в материале National Institutes of Natural Sciences, размещённом на Phys.org 5 ноября
 Наука
3
мин
05.11.2026
Древний блок земной коры мог перенести растения из Австралии в Юго-Восточную Азию
Исследователи изучили более 3000 растительных ископаемых в янтаре из штата Качин на севере Мьянмы. Возраст находок около 100 миллионов лет, и в смоле сохранились цветы, листья, плоды и другие части растений. По мнению авторов, эти древние растения попали в Юго-Восточную Азию вместе с Блоком Западной
 Кандидатские диссертации
30
мин
05.11.2026
Исторические монографии на английском: как искать и выбирать литературу
Историческую монографию на английском выбирайте под конкретный исследовательский вопрос. При первом чтении ищите, на какие свидетельства опирается автор и как он строит свой довод. Выбрать подходящую книгу для обзора придется самостоятельно, поэтому речь пойдет о том, как отделить исследование от ис
 Оформление работ
33
мин
05.11.2026
Поляков «Киевская Русь как цивилизация»: метод и вече
«Киевская Русь как цивилизация» Александра Николаевича Полякова — монография о том, как устройство общества связано с землевладением, ценностями и политической властью. Ниже разбираем второе издание 2015 года: определение цивилизации, ход исследования и конкретный аргумент о вече. Если вы готовите с
 Практика
33
мин
05.11.2026
Греков «Киевская Русь»: разбор открытого фрагмента
Монография Бориса Дмитриевича Грекова «Киевская Русь» позволяет изучать не только объяснение древнерусского общества, но и способ работы историка с летописным рассказом. Ниже разобран открытый фрагмент издания «Концептуал» 2025 года: его аргументы, ограничения и пригодность для исследовательской раб