


Содержание статьи
Языковые модели сыграли роль российских первокурсников: Плехановка сравнила 11 ИИ с ответами почти тысячи студентов
Наука
03.11.2026
03.11.2026
4
мин
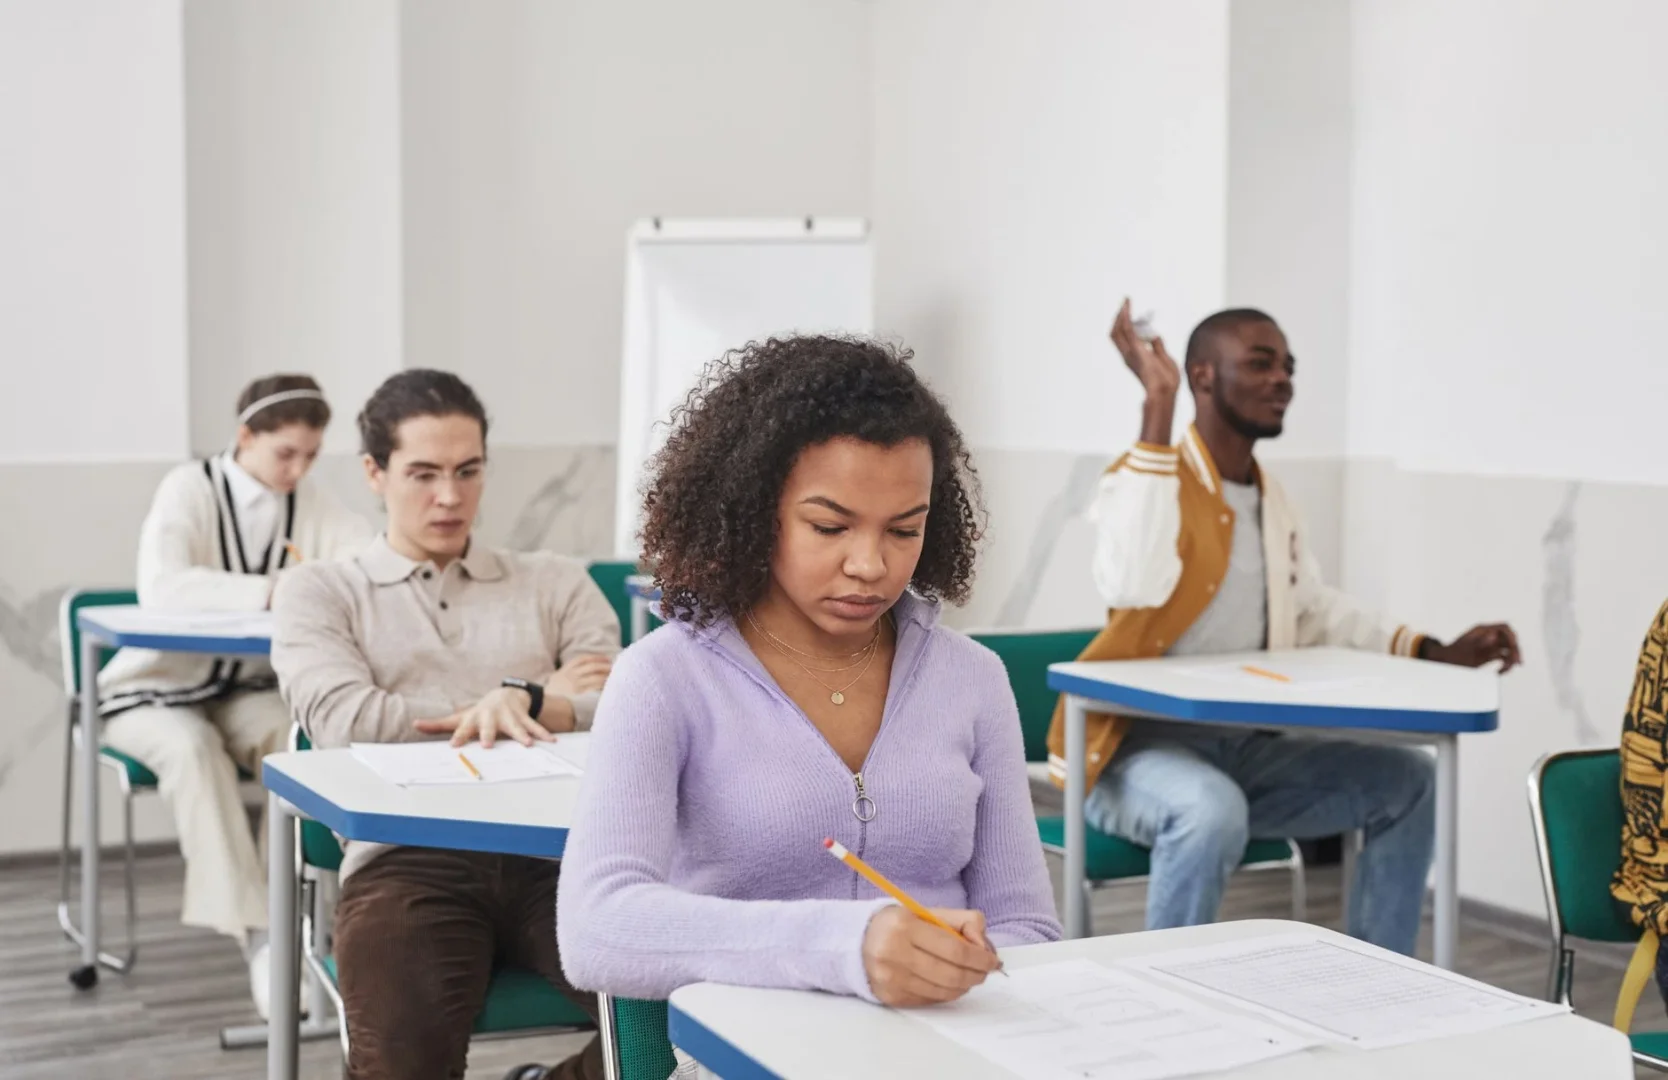
Российский экономический университет имени Г. В. Плеханова 2 ноября 2026 года сообщил о публикации в журнале «Врач и информационные технологии» (№3, 2026) статьи «Оценка локализации больших языковых моделей для задач клинической психологии: прогнозирование показателей тревоги и депрессии на выборке российских студентов». Одиннадцать российских и зарубежных языковых моделей отвечали на вопросы стандартизированного психологического опросника, а исследователи сравнили их ответы с данными почти тысячи студентов.
Что именно сравнивали и что получилось
Модель ставили в положение российского первокурсника: она должна была заполнить тот же опросник, что и живые участники, а затем программный ответ сопоставляли с реальными данными. По совокупности показателей лучший результат у российской T-pro-2.0. Второе место заняла китайская DeepSeek, третье и четвёртое — российские Vikhr-YandexGPT и YandexGPT. Три лидера из четырёх — отечественные разработки, но происхождение нейросети само по себе, как отмечают авторы, не гарантирует понимания российской аудитории. Решают качество обучения и адаптации, а компактные модели в этом сравнении не уступили более крупным. Опрос проводили в закрытом контуре, без передачи данных во внешние сервисы.
Ещё один заявленный вывод касается простоты метода: для имитации, по сообщению университета, достаточно краткого описания респондента, а результат почти не зависит от того, как сформулирован запрос. Все эти оценки приведены без конкретных цифр точности и без границ применимости.
Что это меняет на практике
Речь не о том, чтобы посадить языковую модель вместо психолога. Авторы прямо подчёркивают: ИИ не ставит диагноз и не заменяет специалиста. Речь о другом этапе — предварительной проверке самого опросника. Прежде чем тратить время и деньги на полевое исследование, вопросы можно прогнать через виртуальную аудиторию из «синтетических респондентов»: посмотреть, не сбивают ли формулировки людей с толку, не выпадает ли какая-то часть шкалы, где ответы распределяются подозрительно ровно. Такую проверку проводят до того, как в исследование придут живые студенты.
Представим, что исследователь готовит анкету о тревоге у первокурсников и хочет проверить два варианта формулировки одного вопроса: «Как часто за последний месяц вы чувствовали напряжение?» и «Насколько сильно за последний месяц вы ощущали напряжение?». Модель может заполнить обе версии, чтобы посмотреть, меняются ли ответы от смены формулировки. Если не меняются, это повод считать вопрос устойчивым; если меняются, его стоит переписать до полевого этапа. Но такой прогон показывает только поведение модели на данном опроснике. Он не доказывает, что так же ответят реальные студенты. Авторы и не утверждают обратного: синтетические ответы сокращают объём работы, но не отменяют её.
Пока известен только текст пресс-релиза. Сама статья в журнале «Врач и информационные технологии» (№3, 2026) в переданном сообщении не приведена, поэтому методология, состав и объём выборки, метрики точности и статистическая значимость различий между моделями остаются непроверенными. Пресс-релиз не равен рецензированной работе: это сообщение учреждения о своём результате.
Для тех, кто проводит собственные опросы и готовит научные тексты, существует статистический анализ данных: он помогает до публикации разобраться, что именно показали собранные ответы и какие выводы из них следуют, а какие нет.
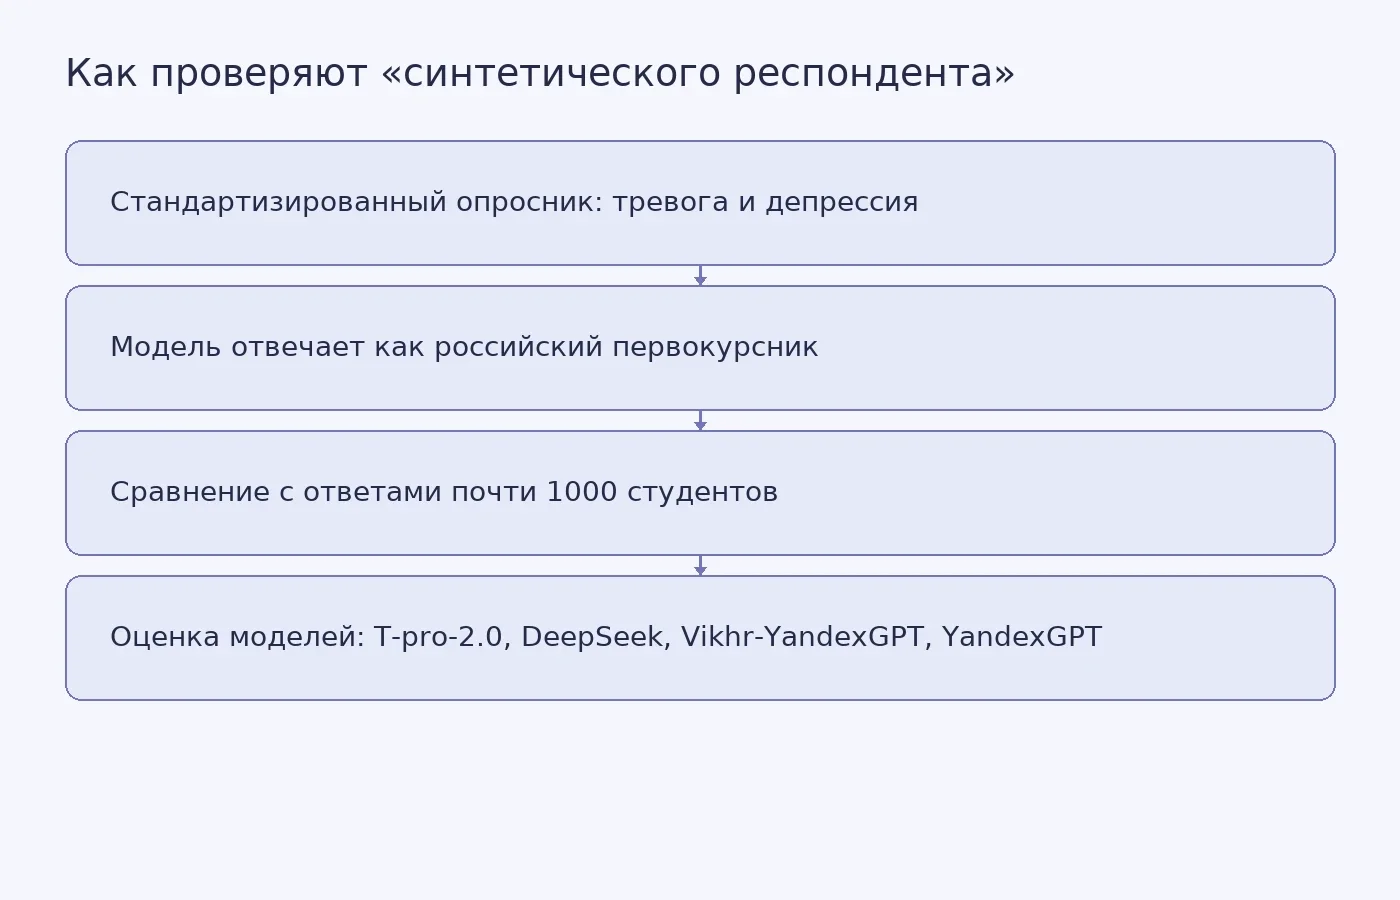
Фото: Andy Barbour / Pexels
Похожие статьи
 Наука
5
мин
12.10.2026
Гибридный квантовый процессор упростит моделирование взаимодействий света и материи
Команда Элеанор Крейн из Массачусетского технологического института предложила гибридную архитектуру квантового процессора, в которой фермионные состояния кодируются кубитами, а бозонные, включая частицы света, хранятся в микроволновых резонаторах. Исследование опубликовано 7 октября 2026 года в жур
 Наука
3
мин
09.10.2026
ИИ-модели меняли лица по стереотипам об ориентации и криминальном прошлом
Исследователи во главе с Ашиком ХудаБукхушем проверили, как две модели для работы с изображениями меняют лица по запросам о сексуальной ориентации, расе и криминальном прошлом. В опытах использовали 1002 созданных ИИ лица. О результатах ХудаБукхуш рассказал в статье для The Conversation, опубликован
 Наука
4
мин
02.10.2026
ИИ снизил ошибки моделирования аэрозолей примерно наполовину
Спутник замечает аэрозоли по отражённому свету: частицы пыли, дыма или морской соли меняют яркость, которую фиксирует прибор. Такие измерения давно питают модели, но обычно не напрямую. Сырые данные видимого и инфракрасного диапазонов слишком дорого встраивать в расчёты, поэтому их сначала перерабат
 Наука
3
мин
20.10.2026
Домашний курс стимуляции при депрессии оказался выполнимым, но не превзошёл контроль
В международном испытании DiSCoVeR 109 взрослых с большим депрессивным расстройством проходили курс стимуляции мозга, в основном дома. Участники чаще всего соблюдали расписание, но активная стимуляция вместе с когнитивной игрой не дала статистически значимого преимущества перед контрольной программо
 Наука
3
мин
16.10.2026
Какие модели точнее оценивали суточную сейсмическую активность в Калифорнии
Международная группа с участием учёных из Бристольского университета проверила 27 моделей, которые ежедневно прогнозировали землетрясения в Калифорнии. С августа 2007-го по август 2018 года модели выдали 51 625 прогнозов. Исследователи сопоставили их с 597 землетрясениями магнитудой Mw ≥ 3,95. Резул
 Наука
4
мин
03.10.2026
Модели мозга из стволовых клеток воспроизвели медленные волны общей анестезии
Исследователи Калифорнийского университета в Лос-Анджелесе создали из человеческих стволовых клеток трехмерные модели нейронных цепей и подвергли их действию пропофола. Как сообщил UCLA 2 октября, препарат снизил активность отдельных нейронов, но одновременно заставил их работать более согласованно.
Последние новости и статьи
 Наука
5
мин
03.11.2026
В Бразилии ограничения для Амазонии сработали там, где штрафовали
Исследователи из Боннского университета сравнили участки по обе стороны границы Амазонии и Серраду и пришли к выводу: дополнительные природоохранные меры снижали потери леса в первую очередь в муниципалитетах, где экологические законы исполнялись строго. Работа опубликована в журнале Global Environm
 Наука
5
мин
03.11.2026
Эволюционная перестройка IleRS ускорила синтез белка у бактерий
Бактерии, археи и эукариоты пользуются одним и тем же набором ферментов, чтобы пришивать аминокислоты к транспортным РНК. Один из них, изолейцил-тРНК-синтетаза (IleRS), узнаёт тРНК с изолейцином и цепляет к ней нужную аминокислоту. Группа исследователей из Института науки Токио (Япония), Загребского
 Поступление
4
мин
03.11.2026
НГУЭУ планирует открыть программу с двумя дипломами по психологии в 2027 году
Новосибирский государственный университет экономики и управления (НГУЭУ) планирует в 2027 году открыть четырёхлетнюю очную программу «Психолого-педагогическое сопровождение детей и взрослых». Студенты смогут параллельно учиться в НГУЭУ и дистанционно проходить модуль Восточно-Европейского института
 Научные статьи
33
мин
03.11.2026
Как написать монографию по литературе или искусству: корпус, метод анализа и структура
Монография по литературе или искусству начинается с определённого корпуса: какие тексты и версии вы читаете, какие произведения и изображения рассматриваете, какой вопрос по ним решаете. Ниже показано, как связать карточки объектов, метод анализа и главы собственной рукописи; в учебном примере полно
 Диссертации по темам
29
мин
03.11.2026
Как написать историческую монографию: исследовательский вопрос, источники, историография и главы
Историческую монографию часто представляют как длинный текст, который начинается с темы и заканчивается списком литературы. В этом руководстве начнём с главного исследовательского вопроса и соотнесём с ним источники, историографию и главы. Это предлагаемый способ организации работы; конкретная книга
 Диссертации по темам
17
мин
03.11.2026
Как издать монографию: издательство, подготовка рукописи, ISBN, РИНЦ и печать
Чтобы издать монографию, составьте план конкретного выпуска: подготовка рукописи, согласование работ, ISBN, печать и размещение. Если вам нужна помощь с собственной исследовательской рукописью по индивидуальному заданию, на странице услуги описаны её подготовка и цена на монографию. Условия выпуска