


Содержание статьи
Полезные материалы
16.10.2026
16.10.2026
7
мин
Представьте таблицу с результатами эксперимента: десятки столбцов, пропуски, значения, которые нужно привести к единому формату. ИИ может помочь написать код для обработки. Но загружать в облачный чат саму таблицу рискованно: вместе с запросом данные могут попасть в обработку и хранение, описанные политикой сервиса.
Один из способов снизить риск предлагает клиницист-исследователь Жак Корнвелл в авторской колонке Nature Careers Community. Он просит модель работать с описанием структуры таблицы и синтетическими значениями, а готовый код запускает на настоящих данных в защищённой среде. Это личный опыт автора, не рецензируемое исследование: колонка не измеряет вероятность утечки или частоту ошибок. Поэтому описанный подход полезно рассматривать как рабочую схему, а не гарантию безопасности.
Пусть каждая функция делает одну работу
Корнвелл предлагает не просить ИИ сразу написать большой скрипт, который загружает таблицу, очищает её, проводит анализ и строит график. Вместо этого код делят на небольшие функции: одна читает и форматирует данные, другая нормализует значения, третья создаёт визуализацию. Если ошибка появляется при преобразовании, искать её можно в соответствующей части программы, не перепроверяя весь конвейер целиком.
Такой подход помогает локализовать сбой, но сам по себе не подтверждает правильность расчётов. Корнвелл описывает удобство модульного кода на собственном опыте, а не на основе сравнительного эксперимента.
Разделите данные, код и результаты
В своей колонке Корнвелл описывает структуру проекта, где исходные данные хранятся отдельно от скриптов, а результаты направляются в другую папку. Документация шаблона Cookiecutter Data Science предлагает похожее разделение: в ней отдельно обозначены исходные, промежуточные и обработанные данные, исходный код и отчёты. Это документация проекта, а не испытание, доказывающее, что такая организация предотвращает потерю файлов.
Папка с названием «только для чтения» сама по себе не ограничивает запись. Права нужно настроить средствами операционной системы или хранилища. Резервные копии и контроль версий тоже важны: упорядоченные каталоги облегчают работу, но не защищают от случайного удаления или перезаписи.
Отлаживайте на синтетических значениях
Для разработки кода Корнвелл советует описать таблицу без её содержимого: указать названия столбцов, типы данных и размеры набора. Затем можно попросить ИИ написать и проверить код на синтетических данных, устроенных по той же схеме. Когда программа готова, её переносят в защищённую среду и запускают на реальных данных.
Синтетический набор позволяет проверить, как код работает с выбранными типами и структурой. Он не показывает, верно ли выбран статистический метод, и не гарантирует, что программа учтёт все особенности настоящей таблицы. Поэтому результат нужно проверять отдельно: например, сопоставлять промежуточные расчёты с контрольными значениями, если такие значения известны.
Перед отправкой запроса стоит проверить не только сами данные. Идентификаторы, фрагменты документов, метаданные и код могут раскрывать чувствительные сведения о проекте. А если правила учреждения, согласия участников или закон запрещают передавать данные внешнему поставщику, описание схемы таблицы не отменяет запрета.
Политика сервиса важна не меньше запроса
Дженнифер Кинг, Кевин Клайман, Эмили Кэпстик, Тиффани Сааде и Виктория Се изучили политики конфиденциальности шести американских разработчиков ИИ. Авторы применили качественную схему анализа, основанную главным образом на законе штата Калифорния о защите прав потребителей. По результатам анализа, в политиках всех шести компаний, по-видимому, предусмотрено использование пользовательских чатов для обучения и улучшения моделей по умолчанию; некоторые компании могут хранить данные неограниченно долго. Эта работа опубликована на arXiv как препринт, а не как рецензированная статья.
Исследователи анализировали тексты политик, а не технические журналы работы сервисов. Их выводы нельзя автоматически переносить на любой тариф, корпоративную версию или локальную модель. Но они дают повод проверить условия конкретного продукта: могут ли запросы и загруженные файлы использоваться для обучения, как долго они хранятся и кто может к ним получить доступ. Если политика не даёт ясного ответа, не следует считать данные защищёнными только потому, что сервис известен.
Рабочий порядок
- Выясните, какие файлы конфиденциальны и где правила проекта разрешают их обрабатывать.
- Разнесите исходные данные, код и результаты по разным папкам. Настройте права так, чтобы скрипты не могли перезаписать исходники.
- Попросите ИИ подготовить отдельные функции для конкретных этапов, а не один большой скрипт.
- Передавайте модели только необходимое описание структуры и отлаживайте код на синтетических значениях.
- Проверяйте каждый этап, а на реальных данных запускайте код только в разрешённой среде.
- До работы с облачным сервисом изучите его правила обработки запросов и файлов. Если требуется, используйте среду, одобренную учреждением.
Выбор программы для анализа можно начать с обзора инструментов для научной работы. Однако программное обеспечение не заменяет проверку доступа и хранения данных.
ИИ может написать черновой код, но научный смысл анализа и допустимость передачи данных остаются ответственностью исследователя. Небольшие функции и синтетические тесты делают процесс проще для проверки. Они не доказывают правильность анализа и не превращают облачный чат в безопасное хранилище.
Источники
- Cornwell J. In the AI era, coding means thinking like a systems architect. Nature Careers Community, 13 октября 2026 года. Авторская колонка, основанная на личном опыте.
- King J., Klyman K., Capstick E., Saade T., Hsieh V. User Privacy and Large Language Models: An Analysis of Frontier Developers’ Privacy Policies. arXiv:2509.05382, 5 сентября 2025 года. Препринт.
- Cookiecutter Data Science: документация шаблона структуры проекта.
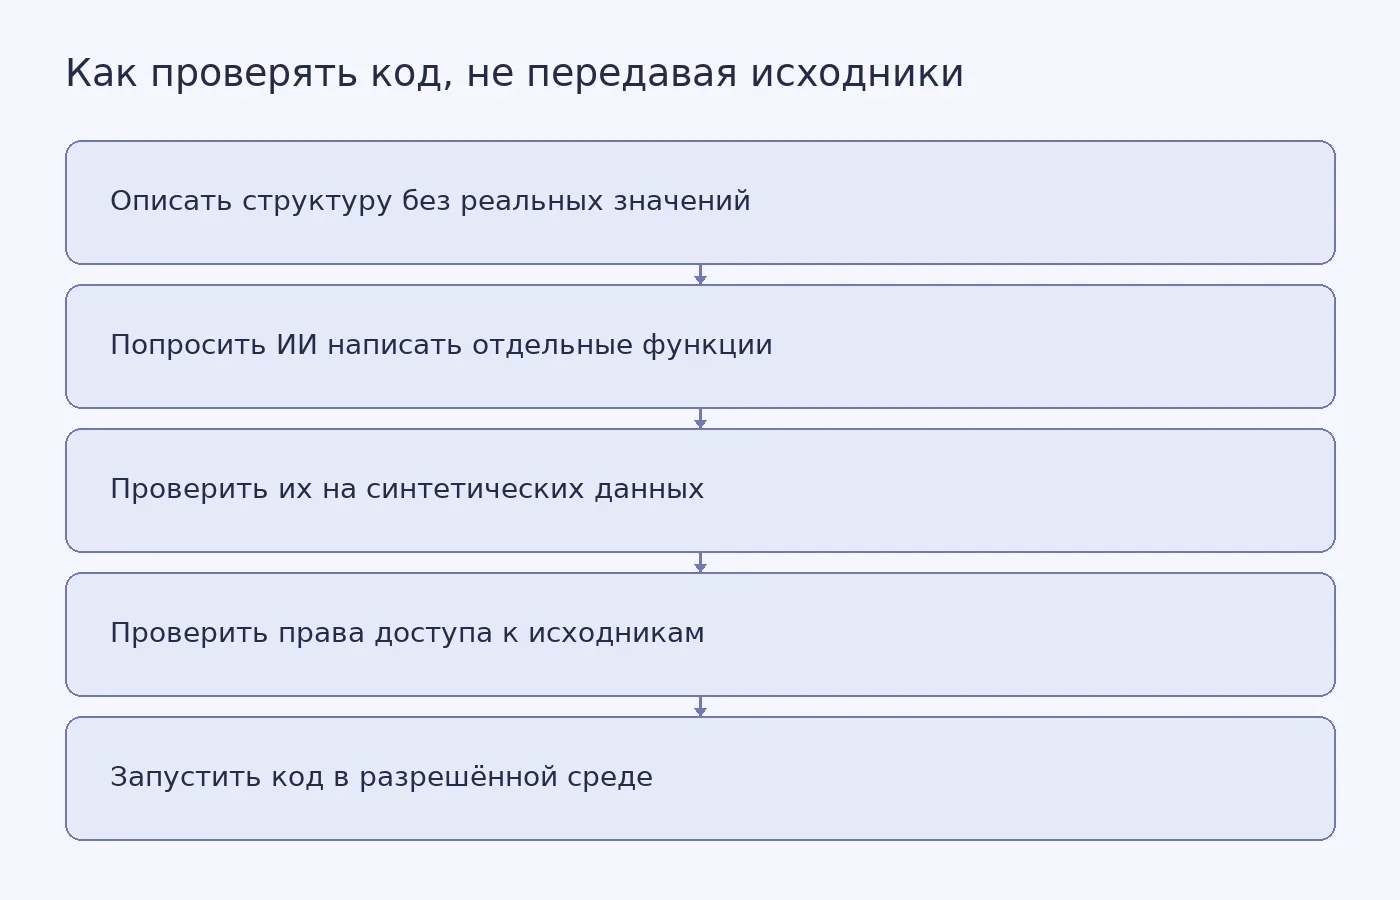
Фото: Daniil Komov / Pexels


Похожие статьи
 Полезные материалы
11
мин
27.02.2026
1
Лучшие инструменты для анализа данных в дипломе и диссертации: SPSS, R, Python, Excel, NVivo
Инструменты для анализа данных помогут грамотно интерпретировать результаты, соблюсти требования к технической точности, учесть специфику данных. Такие помощники помогут подобрать адекватные методы обработки информации, обеспечить воспроизводимость результатов в соответствии со сложностью проблемы.
 Полезные материалы
11
мин
27.02.2026
1
Методы визуализации научных данных: основные виды, критерии выбора, требования
Визуализация научных данных поможет представить сложные результаты в наглядной форме. Отображение информации в формате графиков, схем и диаграмм поможет продемонстрировать закономерности и связи, сделав данные доступными для восприятия. Кроме этого, визуализация научных данных облегчает проверку гип
 Полезные материалы
12
мин
10.10.2026
Когда антидепрессант перестаёт помогать: что известно о тахифилаксии и чего в данных нет
Человек начинает принимать антидепрессант, через несколько недель становится легче, а спустя месяцы симптомы возвращаются. Препарат тот же, доза та же. В англоязычной литературе для этого есть несколько названий: тахифилаксия, «выгорание» препарата, «прорывная депрессия». За терминами стоит конкретн
 Полезные материалы
9
мин
27.02.2026
1
Генеративные ИИ-инструменты для поиска и анализа литературы: какие бывают, как использовать
Чтобы выбрать релевантную литературу для написания научно-исследовательской работы, автору требуется проанализировать огромный массив публикаций, проверить их на достоверность и релевантность, критически сопоставить разные точки зрения. Игнорирование такого подхода к выбору референсов может привести
 Полезные материалы
10
мин
10.10.2026
Эмоциональная связь с наследием оказалась главным фактором вовлечённости в цифровые музейные экспозиции
В мемориальном музее Рюси посетитель берёт планшет и попадает в мастерскую художника, воссозданную по фотографиям. Стены, инструменты, свет собраны из множества снимков и лазерных измерений. Технически это уже не редкость: фотограмметрия и лидар в планшете позволяют построить такую сцену без студии
 Полезные материалы
10
мин
10.08.2026
2
Как сделать анти ИИ-диплом
Большинство вузов усилили контроль качества выполнения академических работ. Современные детекторы ИИ анализируют сразу несколько критериев дипломной: стиль изложения, структура аргументации, тип и характер формулировок, логику исследования, авторские выводы и т.д. В этом материале рассмотрим осно
Последние новости и статьи
 Полезные материалы
6
мин
16.10.2026
Почему озеро Джили росло во время засухи
У озера Джили на северо-западе Китая выпадает в среднем 131 миллиметр осадков в год, а потенциальное испарение достигает 1700 миллиметров. В таком месте засуха, кажется, должна уменьшать озеро. Но реконструкция показывает обратное: около 850 года уровень воды поднялся примерно на 20 метров выше совр
 Полезные материалы
8
мин
16.10.2026
Устойчивые морепродукты: важно не только, как поймали рыбу
Одна и та же мелкая пелагическая рыба может попасть на прилавок свежей, пойти на традиционную переработку или стать сырьём для рыбной муки. Вид рыбы и способ её вылова могут быть одинаковыми, но последствия для людей и рынков будут разными. Поэтому по названию рыбы или значку на упаковке не всегда м
 Полезные материалы
10
мин
16.10.2026
Усталость от сострадания: признаки и данные о самосострадании
После тяжёлой смены можно выспаться и прийти в себя. Но иногда меняется не только уровень сил: привычный эмоциональный отклик на чужую боль слабеет, разговоры начинают раздражать, а некоторые рабочие ситуации хочется обходить стороной. В профессиональной литературе такие перемены описывают, в частно
 Наука
2
мин
15.10.2026
ИИ-система отвечает на вопросы о научных данных с точностью 62–67%
Исследователи из немецкого Центра научной информации и технологий имени Лейбница (TIB) разработали инструмент, который позволяет задавать вопросы о данных научных работ обычным языком. Система превращает вопрос в запрос к базе данных, выполняет его на данных, связанных с научным результатом, и вывод
 Наука
3
мин
15.10.2026
Исследователи нашли уязвимости в приложениях переноса данных семи производителей Android
Исследователи Технического университета Граца и австрийского центра A-SIT нашли уязвимости в приложениях для переноса данных семи производителей Android: Google, Samsung, Vivo, Xiaomi, Oppo, Huawei и Honor. В проверенных версиях человек поблизости мог перехватить беспроводную передачу, а в пяти прил
 Образование
3
мин
15.10.2026
После окончания ESSER одни школы США сократили репетиторство, другие сохранили его
После завершения федеральной программы помощи ESSER школьные округа США выбрали разные пути для интенсивных занятий с репетиторами. В обзоре Национального акселератора поддержки учащихся (National Student Support Accelerator, NSSA), опубликованном 15 сентября 2026 года, рассмотрены 35 округов: в вос