


Содержание статьи
Как выявляют научно-технологические приоритеты: слабые сигналы, анализ больших данных и границы ИИ-ассистента
Полезные материалы
30.10.2026
30.10.2026
10
мин
На странице iFORA, системы интеллектуального анализа больших данных, стоит цифра: свыше 850 млн документов, ежедневный прирост около 30 тыс. Прочитать такой массив человек не может. Вопрос поэтому не в объеме, а в другом: какие именно операции с текстами дают право назвать направление приоритетным и чем эти операции проверяются.
Разговор об этом 29 октября 2026 года провела новостная служба «Вышка.Главное» с заведующей Лабораторией исследований науки и технологий (ЛИНТ) НИУ ВШЭ Лилианой Проскуряковой и директором Форсайт-центра Института статистических исследований и экономики знаний (ИСИЭЗ) НИУ ВШЭ Александром Соколовым. Материал опубликован на сайте университета. Это интервью, а не рецензируемая статья и не отчет об эксперименте: в нем названы подходы и годы работ, но нет ни дизайна, ни выборок, ни метрик, ни процедур валидации.
Лаборатория появилась в 2010 году как одна из международных лабораторий Вышки. Ее задача в интервью описана так: изучать состояние исследований и разработок, разбирать тренды и их динамику, чтобы «определять приоритеты будущих работ, формировать научную и промышленную политику». Это заявка на инструмент политики, а не отдельный научный результат. Поэтому стоит разделить, что здесь предлагают считать методом, а что пока остается обещанием.
Что названо методом
В интервью перечислены работы 2023-2025 годов. В теоретико-методологическом блоке это модели системных взаимосвязей в сложных системах с неопределенными параметрами применительно к сфере науки и технологий (2023), обзор теоретических подходов к оценке приоритетов технологического развития на национальном уровне (2024), разработка и апробация методов комплексной методологии анализа трендов и их эффектов (2025). Обзор тут важен как отдельный жанр: он собирает чужие подходы, но сам не проверяет, какой из них лучше работает на российских данных.
Второй блок авторы называют методологическими инновациями. Среди них алгоритмы, которые выявляют и оценивают важность «высокоспецифичных научно-технологических (НТ) терминов в массиве больших данных» (2023) для развития iFORA. Логика инструмента понятна: обычные слова встречаются везде, а редкие термины, названия материалов, методов и технологий служат маркерами направлений. Алгоритм должен отделить специфичный термин от общеязыкового шума и взвесить его. Но в интервью нет ни описания корпуса, ни разметки, ни точности извлечения, ни доли ложных срабатываний. Без этого нельзя судить, отражает ли список терминов научную повестку или особенности конкретной базы.
Там же назван методологический подход к использованию слабых сигналов для государственного управления (2024). Слабый сигнал обычно понимают как ранний разрозненный признак изменения, который еще не стал устойчивым трендом. Для управления он ценен именно ранностью, но платой оказывается неопределенность: часть сигналов не подтвердится. В интервью не сказано, по каким критериям сигнал относят к слабым, как отличают его от единичной публикации и как считают цену пропуска или ложной тревоги. Это не придирка к формулировке. Если метод должен предупреждать государство о будущем приоритете, вопрос о ложных срабатываниях входит в сам метод, а не прилагается к нему.
Отдельно упомянута программа для ЭВМ «для оценки уровня технологической готовности (TRL) фронтиров науки» (2023). TRL, уровень технологической готовности, это шкала зрелости технологии: от ранней идеи до работающего решения. Перенос шкалы на фронтиры науки означает попытку оценивать не только технологию, но и направление исследований на переднем крае. Для приоритизации такая оценка полезна, однако в интервью нет сведений о том, как программа определяет уровень, кто размечает эталоны и совпадают ли оценки разных экспертов.
По словам Проскуряковой, в 2023-2025 годах по результатам исследований ЛИНТ разработали и зарегистрировали четыре результата интеллектуальной деятельности (РИД). Регистрация подтверждает формальный статус объекта, но не качество метода. Различие важное: программу для ЭВМ можно зарегистрировать и при этом ни разу не проверить ее точность независимо от разработчика.
Прикладная часть интервью перечисляет оценки влияния кризисов на спрос на технологии, поиск направлений для целей устойчивого развития, рекомендации по управлению научно-технологическим развитием и комплексную оценку стран БРИКС (2025). Здесь методы ЛИНТ выступают уже не предметом исследования, а рабочим инструментом для заказчика. Но и в этом перечислении нет данных о том, какие решения приняли на основе оценок и как проверяли их эффект.
Где авторы проводят границу для ИИ
Граница обозначена в двух ответах, и акценты в них разные. Проскурякова говорит: «На данном этапе ИИ уже может выступать полноценным научным ассистентом». Для корректного использования, по ее словам, нужны навыки промпт-инжиниринга, то есть составления запросов к языковой модели. Она отмечает и тренд на объяснимый ИИ, когда человек понимает, как система устроена и почему выдает такой результат, и необходимость этических норм и правил безопасности. Конкретное ограничение сформулировано прямо: «нельзя загружать конфиденциальные материалы, полученные от заказчика».
Соколов усиливает ограничение с другой стороны: «нельзя полностью перекладывать научную деятельность на ИИ, мы сознаем риски галлюцинаций и использования неадекватных источников». Речь не о том, что ИИ бесполезен, а о том, что ответственность за источник и вывод остается за человеком.
Вместе две позиции не выглядят прямым противоречием. «Полноценный ассистент» означает помощника, а не автономного исследователя. Но акценты расходятся: один ответ подчеркивает расширение возможностей, другой предупреждает о пределах делегирования. Читателю это полезнее гладкого согласия, потому что видно, где проходит практическая граница.
Нашa интерпретация: лаборатория проводит границу не по типу задачи, а по типу ответственности. Поиск, извлечение, сортировка и предварительное описание материалов могут передаваться системе. Проверка источника, оценка надежности и окончательное суждение остаются за исследователем. Запрет на конфиденциальные материалы заказчика добавляет вторую линию: даже полезную операцию нельзя выполнять на данных, которые нельзя выносить во внешний контур. Если вы разбираете литературу с помощью языковой модели, стоит заранее решить, какие файлы ей вообще можно отдавать. Об этом есть отдельный разбор о том, как использовать ИИ для анализа данных и не отправлять ему исходники.
Что подтверждает материал, а что нет
Интервью подтверждает заявленную последовательность: лаборатория разрабатывает методы анализа текстов, трендов, слабых сигналов и технологической зрелости, а ИИ применяет как вспомогательный слой. Эффективность этих методов оно не подтверждает. Ответов на базовые вопросы нет: какой корпус использовался, как измерялась важность термина, сколько экспертов размечали TRL, совпадают ли автоматические оценки с экспертными, какова доля ложных сигналов.
Страница iFORA и новость о новых ИИ-продуктах дополняют картину, но обе написаны разработчиком. На странице iFORA сказано, что база содержит более 850 млн документов, включая более 390 млн научных публикаций и более 150 млн патентов. В новости от 17 августа 2026 года сообщается, что iFORA.LLM включена в Реестр российского программного обеспечения, а iFORA-ассистент сначала ищет релевантные фрагменты и готовит ответ на их основе. По заявлению разработчиков, это «позволяет снизить вероятность недостоверных ответов». Слово «позволяет» описывает устройство системы, а не измеренный эффект: независимых тестов в материале нет.
Поэтому корректный вывод из интервью такой: мы можем описать, какие инструменты лаборатория считает своими и как объясняет их назначение. Утверждать, что эти инструменты точнее альтернатив, что слабые сигналы надежнее экспертной оценки или что TRL-программа воспроизводит суждение специалистов, мы не можем. Для научного обзора это существенное ограничение, и держать его лучше рядом с описанием метода, а не в конце.
Остается вопрос, который интервью не закрывает: как измерять качество извлечения НТ-терминов и как оценивать ложные срабатывания слабых сигналов на реальных управленческих решениях. Пока публичного ответа нет, методы ЛИНТ стоит читать как заявленную инфраструктуру приоритизации, а не как доказанный результат.
Источники
«Как прогнозировать будущее науки и технологий», НИУ ВШЭ, 29 октября 2026 года. Интервью с Лилианой Проскуряковой и Александром Соколовым.
Страница Лаборатории исследований науки и технологий НИУ ВШЭ.
Страница системы интеллектуального анализа больших данных iFORA.
Профиль Лилианы Проскуряковой на сайте НИУ ВШЭ.
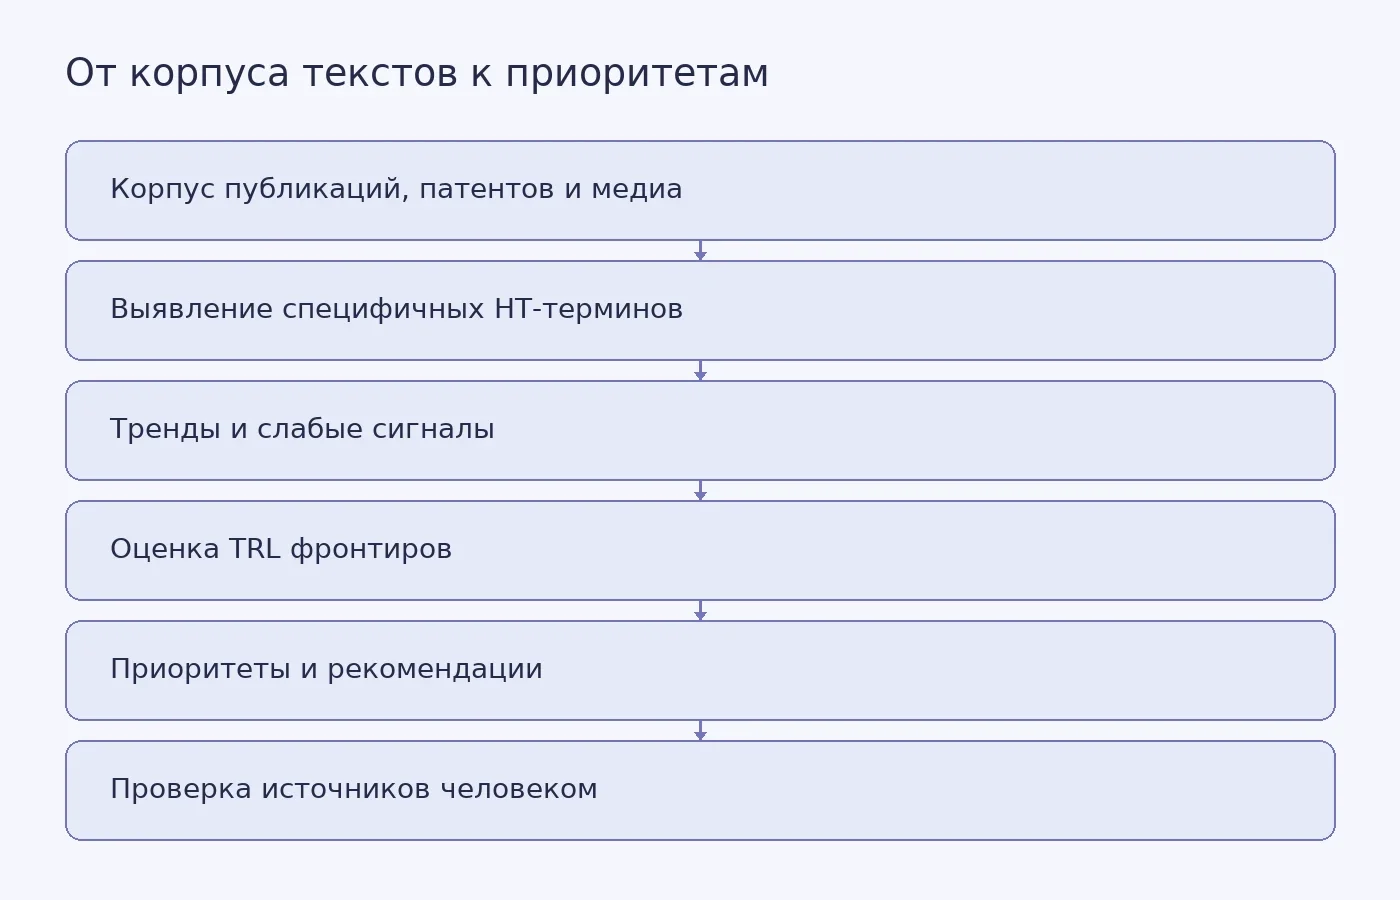
Фото: Tima Miroshnichenko / Pexels


Похожие статьи
 Полезные материалы
11
мин
27.02.2026
1
Лучшие инструменты для анализа данных в дипломе и диссертации: SPSS, R, Python, Excel, NVivo
Инструменты для анализа данных помогут грамотно интерпретировать результаты, соблюсти требования к технической точности, учесть специфику данных. Такие помощники помогут подобрать адекватные методы обработки информации, обеспечить воспроизводимость результатов в соответствии со сложностью проблемы.
 Полезные материалы
7
мин
16.10.2026
Как использовать ИИ для анализа данных и не отправлять ему исходники
Представьте таблицу с результатами эксперимента: десятки столбцов, пропуски, значения, которые нужно привести к единому формату. ИИ может помочь написать код для обработки. Но загружать в облачный чат саму таблицу рискованно: вместе с запросом данные могут попасть в обработку и хранение, описанные п
 Полезные материалы
11
мин
27.02.2026
1
Методы визуализации научных данных: основные виды, критерии выбора, требования
Визуализация научных данных поможет представить сложные результаты в наглядной форме. Отображение информации в формате графиков, схем и диаграмм поможет продемонстрировать закономерности и связи, сделав данные доступными для восприятия. Кроме этого, визуализация научных данных облегчает проверку гип
 Полезные материалы
11
мин
04.03.2026
1
Анализ учебных данных с помощью смартфона: cписок процессов и инструментов
Чтобы фиксировать процесс обучения, студенту нужно учитывать расписание занятий, сроки выполнения, рассчитывать уровень концентрации, посещаемость занятий и продуктивность их проработки. Исключить предвзятую субъективную оценку о продуктивности работы помогут специальные инструменты-планировщики.
 Полезные материалы
11
мин
10.10.2026
Сон как рабочие данные: где проходят границы мониторинга и улучшения сна
В 2016 году две нидерландские компании заинтересовались, как спят их сотрудники. Они собирали данные об активности и сне, а разбираться в этом пришлось органу защиты данных. Вывод оказался неудобным для работодателей: сведения о сне — это чувствительная медицинская информация, а согласие работника н
 Полезные материалы
12
мин
10.10.2026
Когда антидепрессант перестаёт помогать: что известно о тахифилаксии и чего в данных нет
Человек начинает принимать антидепрессант, через несколько недель становится легче, а спустя месяцы симптомы возвращаются. Препарат тот же, доза та же. В англоязычной литературе для этого есть несколько названий: тахифилаксия, «выгорание» препарата, «прорывная депрессия». За терминами стоит конкретн
Последние новости и статьи
 Вопросы студентов
15
мин
30.10.2026
Как превратить Землю в телескоп: устройство Event Horizon Telescope
Шеп Доулман, астрофизик из Гарварда и первый директор коллаборации Event Horizon Telescope, сравнивает нужное разрешение с бытовой задачей: стоя в Нью-Йорке, прочитать дату на монете, которую кто-то держит в Лос-Анджелесе. Речь о тени чёрной дыры в центре Млечного Пути. С расстояния около 27 000 све
 Помощь по написанию
10
мин
30.10.2026
Что спор о спектре аутизма говорит о границах диагностики
В интервью New Scientist исследовательница Ута Фрит предлагает пересмотреть саму идею единого спектра аутизма. По её мнению, люди с относительно мягкими проявлениями и люди с глубоким аутизмом могут иметь слишком мало общего, чтобы их объединяла одна диагностическая категория. «Между ними нет абсолю
 Помощь по написанию
7
мин
30.10.2026
Решётка убеждает, но не доказывает: что такое массовая щель Янга—Миллса
Когда суперкомпьютерный расчёт снова и снова воспроизводит массу протона, близкую к измеренной, это серьёзно поддерживает теорию. Математическая задача о массовой щели ставит иной вопрос: удастся ли вывести это свойство из самих уравнений, не опираясь на конечную сетку и численное приближение? В ква
 Наука
2
мин
29.10.2026
Четыре аминокислоты GAME8 меняют химическую защиту томата от вредителя
Международная группа исследователей связала четыре аминокислоты фермента GAME8 с формой защитных веществ в томатах. В статье, опубликованной 7 августа 2026 года в журнале Nature Communications, авторы показали, что замены этих аминокислот меняют соотношение двух вариантов гликоалкалоида. Один из них
 Наука
2
мин
29.10.2026
У белого карлика нашли два кольца обломков и возможные уцелевшие тела
У белого карлика J1328−1450 нашли два газовых кольца с промежутком между ними. Их наблюдали на Очень Большом Телескопе Европейской южной обсерватории в Чили; исследование опубликовали 26 октября 2026 года в журнале Nature Astronomy. Авторы предполагают, что кольца поддерживают два тела, переживших г
 Наука
4
мин
29.10.2026
Энергетическая граница связала фототок и потери напряжения в органических солнечных элементах
Группа под руководством профессора Хирохико Фукагавы из Центра передовой науки Университета Тиба в Японии описала термодинамическую границу, которая связывает генерацию фототока с потерями напряжения в органических солнечных элементах. Исследование опубликовали онлайн 7 октября 2026 года в журнале A