


Содержание статьи
Дипломы
29.10.2026
29.10.2026
6
мин
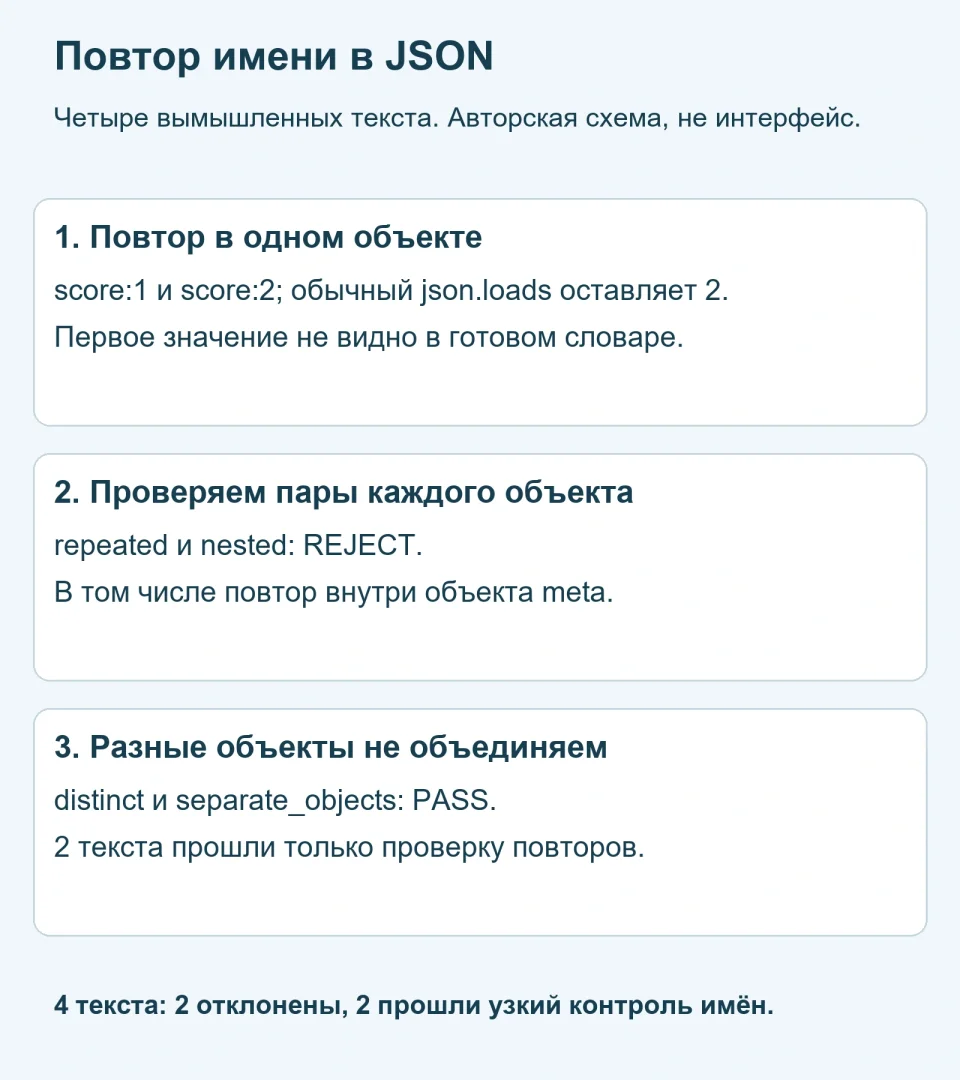
В исходном JSON поле score указано дважды: сначала со значением 1, затем со значением 2. При обычном вызове json.loads() из стандартного модуля Python в словаре останется только последнее значение. Успешный разбор не означает, что сохранились обе пары из исходного текста. Чтобы проверить имена заранее, обработайте пары объекта до того, как Python соберёт из них обычный словарь.
Ниже приведены четыре вымышленных JSON-текста. Значения 1 и 2 нужны только для примера и не относятся к реальным показателям исследования. Названия before и after автор примера присвоил сам. Нельзя по ним решать, как переименовать неизвестные повторяющиеся поля в настоящем файле.
Четыре разных случая
| Учебный текст | Что проверяется |
|---|---|
| repeated | В одном объекте два имени score со значениями 1 и 2 |
| distinct | Разные имена score_before и score_after |
| nested | Два имени score внутри вложенного объекта meta |
| separate_objects | Имя score по одному разу в двух отдельных объектах массива |
Повтор одного имени внутри объекта и одинаковые имена в разных записях требуют разной обработки. Например, поле score может закономерно встречаться в каждом объекте таблицы измерений. Поэтому нельзя проверять уникальность имён одним общим набором для всего JSON-текста.
В документации стандартного модуля json описано поведение повторных имён: по умолчанию сохраняется последняя пара с данным именем. Параметр object_pairs_hook позволяет обработать упорядоченный список пар каждого декодируемого объекта. Проверка ниже относится именно к этому модулю и режиму, а не к любому JSON-парсеру.
Полный код проверки до словаря
import json

samples = {
    "repeated": '{"id":"A01","score":1,"score":2}',
    "distinct": '{"id":"A01","score_before":1,"score_after":2}',
    "nested": '{"id":"A01","meta":{"score":1,"score":2}}',
    "separate_objects": '[{"score":1},{"score":2}]',
}

def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("duplicate key: " + key)
        result[key] = value
    return result

results = {}
for name, text in samples.items():
    try:
        data = json.loads(text, object_pairs_hook=unique_object)
    except ValueError as error:
        results[name] = "REJECT"
        print(name, "REJECT", str(error))
    else:
        results[name] = data
        print(name, "PASS", json.dumps(data, sort_keys=True))

print("default_score", json.loads(samples["repeated"])["score"])
Полученный вывод:
repeated REJECT duplicate key: score
distinct PASS {"id": "A01", "score_after": 2, "score_before": 1}
nested REJECT duplicate key: score
separate_objects PASS [{"score": 1}, {"score": 2}]
default_score 2
Два текста отклонены из-за повторения score, а два прошли эту проверку. В separate_objects одинаковое имя встречается в разных объектах, поэтому оба значения сохраняются. Проверка охватывает и вложенный объект meta: функция вызывается для каждого объекта, а не только для верхнего уровня.
Чего нельзя восстановить из готового словаря
Для repeated обычный разбор оставляет score = 2. По готовому словарю уже нельзя определить, что в исходном тексте перед этим было score = 1. Поэтому сохраняйте исходный JSON до преобразования: после обычного json.loads() проверка словаря не обнаружит потерянную пару.
Функция unique_object создаёт отдельный локальный словарь для каждого объекта. Если имя повторяется, она вызывает исключение, и вызывающий код не принимает документ целиком. В примере ValueError означает отказ для этого текста. В реальном журнале обработки полезно записывать имя файла, место ошибки и её причину. Отдельно проверьте синтаксис, типы и смысл полей.
Не назначайте смысл полям автоматически
- Не выбирайте первое или последнее значение лишь для того, чтобы продолжить загрузку.
- Сначала уточните схему и источник двух полей с одинаковым именем.
- Не переименовывайте их в «до» и «после», если описание данных этого не подтверждает.
- Отличайте повтор имени в одном объекте от одинаковых полей в разных записях.
- Сохраните исходный текст и зафиксируйте решение о дальнейшей обработке.
После проверки имён остаётся отдельная задача: различить отсутствующее поле, null, false, ноль и пустой текст. Она не заменяет контроль повторов: в готовом словаре часть пар уже могла исчезнуть. Похожая опасность есть у повторяющихся заголовков CSV перед DictReader, но там проверяют строку заголовков и позиции столбцов; здесь — пары каждого JSON-объекта, включая вложенные.
Законченный вывод по набору
| Результат | Число текстов |
|---|---|
| Отклонены repeated и nested | 2 |
| Прошли проверку distinct и separate_objects | 2 |
| Всего проверено | 4 |
Для вымышленного набора repeated и nested отклонены, а distinct и separate_objects прошли проверку уникальности имён внутри объекта. Это ещё не полная проверка исследовательских данных: отдельно нужны схема, проверка типов и допустимых значений, а также выяснение источника. Код не определяет смысл двух неизвестных полей.
Если нужна помощь с проверкой подготовки собственного исследовательского набора, можно согласовать консультацию по статистическому анализу. Передайте исходные файлы, описание полей и конкретную задачу проверки. Согласуйте объём помощи: устранение ошибки представления данных само по себе не выбирает метод анализа и не подтверждает научный вывод.


Похожие статьи
 Дипломы
14
мин
01.10.2026
Научная новизна дипломной работы: как показать собственный результат
Научная новизна дипломной работы не обязательно означает мировое открытие. В этой статье под ней понимается конкретный собственный результат, который студент показывает в сравнении с существующими работами, подходами или решениями и подтверждает материалами ВКР. Точное содержание этого пункта и необ
 Дипломы
8
мин
27.10.2026
Одинаковый ID в таблице: как отличить дубликат от повторного наблюдения
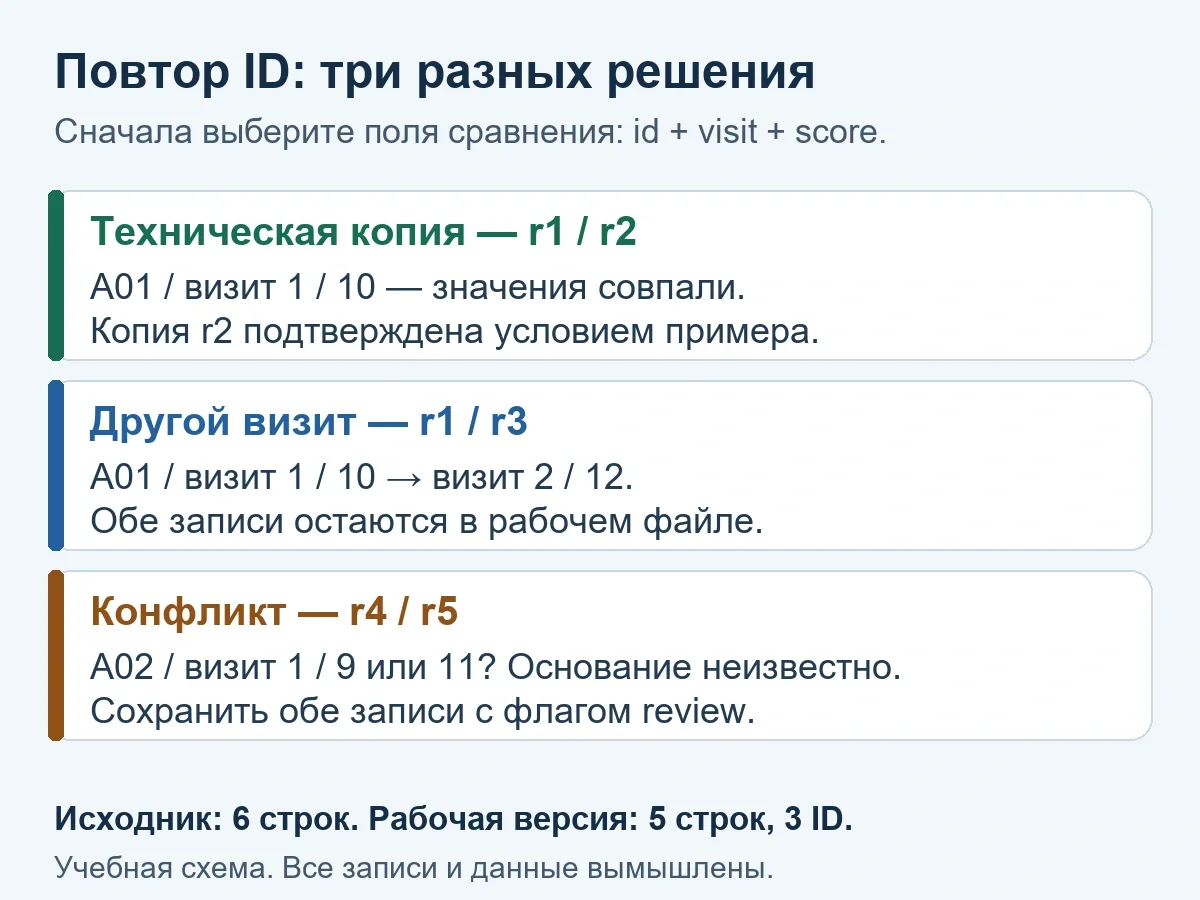
Вы открываете файл с данными и видите, что у одного и того же идентификатора несколько раз записаны баллы. Первая мысль: «Ошибка выгрузки, нужно удалить повторы». Но не все совпадения значений — это технические дубликаты. Часть может оказаться повторными визитами одного участника, а часть — конфликт
 Дипломы
19
мин
01.10.2026
Презентация к диплому: структура слайдов и пример презентации ВКР
Презентация к диплому должна быстро показать комиссии логику ВКР: какую проблему вы изучали, как работали с данными или проектом, что получили и в чем практический смысл результата. Это не сокращенная копия текста дипломной работы и не набор декоративных слайдов. Ниже приведена рабочая структура пре
 Дипломы
12
мин
02.10.2026
Как проходит проверка Антиплагиат.ВУЗ: отчет, совпадения и исправления
Проверка ВКР в «Антиплагиат.ВУЗ» — это не «экзамен на процент», а способ увидеть, какие фрагменты вашего текста совпали с уже проиндексированными источниками. Система показывает совпадения, цитирование, самоцитирование и оригинальность, но не выносит вердикт «плагиат» и не решает, допустима ли работ
 Дипломы
5
мин
23.02.2023
27910
Аннотация к диплому: требования и правила составления
Аннотация к дипломной работе – это краткое описание ВКР, в которое входит название темы, характеристика объема проекта, количества наглядных материалов и ключевых фраз по направлению исследования, числа информационных источников. В некоторых случаях, план аннотации может содержать в
 Дипломы
12
мин
01.10.2026
Какие вопросы задают на защите диплома: как готовить ответы
Единого перечня вопросов для всех защит ВКР в проверенных документах НИУ ВШЭ не установлено. Регламент этого университета предусматривает вопросы, непосредственно связанные с темой ВКР или близкие к ней. При ответе студент вправе пользоваться текстом своей работы. Это локальное правило НИУ ВШЭ, поэт
Последние новости и статьи
 Вопросы студентов
19
мин
29.10.2026
17805
Что такое автореферат к диссертации и как его написать?
Автореферат диссертации кратко представляет её основное содержание: поставленную проблему, полученные результаты, личный вклад соискателя и выводы. Читателю должно быть понятно, что именно сделано и на каких материалах основаны утверждения, даже если он ещё не прочитал всю диссертацию. Это не сокращ
 Вопросы студентов
6
мин
29.10.2026
Counter в Python: как сохранить отрицательные и нулевые разности
В двух выгрузках посчитаны категории A, B и C. Нужно сохранить разность «первое количество минус второе» для каждой категории, включая увеличение и отсутствие изменения. Для такой задачи выражение first - second у Counter может убрать важные строки: в его результате остаются только положительные счё
 Магистерские диссертации
6
мин
29.10.2026
Вложенные списки Python: как избежать общей строки при повторении
В заготовке таблицы три строки и два значения в каждой. Вы меняете одну ячейку, а новое число появляется сразу в трёх строках. Причина может быть в конструкции [[0, 0]] * 3: она повторяет ссылки на один вложенный список. Разберём, чем одинаковое содержимое строк отличается от общего изменяемого объе
 Наука
3
мин
28.10.2026
В музейных коллекциях нашли новый род динозавров из южной Англии
Палеонтологи описали новый род и вид растительноядных динозавров по окаменелостям из коллекции Музея естественной истории в Лондоне. Останки нашли в 2001 году на кирпичном заводе Ewhurst Works в графстве Суррей, после чего передали музею. О находке сообщили 27 октября 2026 года, когда исследование о
 Наука
5
мин
28.10.2026
Валуны в заливе Маргерит впервые дали даты антарктических морен
По валунам на трёх моренах в заливе Маргерит на западе Антарктического полуострова впервые напрямую датировали неогляциальные отложения. Возраст морены у ледника Шумсмит на острове Хорсшу группа под руководством Атиллы Чинера из Института наук о Земле Евразии Стамбульского технического университета
 Вузы
3
мин
28.10.2026
Совместный институт НГУ и Цзянсийского педуниверситета принял 276 первых студентов
Новосибирский институт математики и искусственного интеллекта при Цзянсийском педагогическом университете, созданный НГУ совместно с китайским вузом, в 2026 году принял первых 276 студентов. О церемонии открытия, которая прошла во время визита делегации Новосибирского государственного университета в