


Содержание статьи
Дипломы
27.10.2026
27.10.2026
8
мин
Вы открываете файл с данными и видите, что у одного и того же идентификатора несколько раз записаны баллы. Первая мысль: «Ошибка выгрузки, нужно удалить повторы». Но не все совпадения значений — это технические дубликаты. Часть может оказаться повторными визитами одного участника, а часть — конфликтом, когда в один и тот же визит записаны разные результаты. Условный учебный пример на шести строках покажет, как различить три ситуации и что с ними делать.
Все ID, баллы и обстоятельства выгрузки далее вымышлены. Сырой файл из шести строк сохраняется неизменным; исключение r2 относится только к отдельной рабочей версии.
Исходные данные: шесть строк и повторяющиеся ID
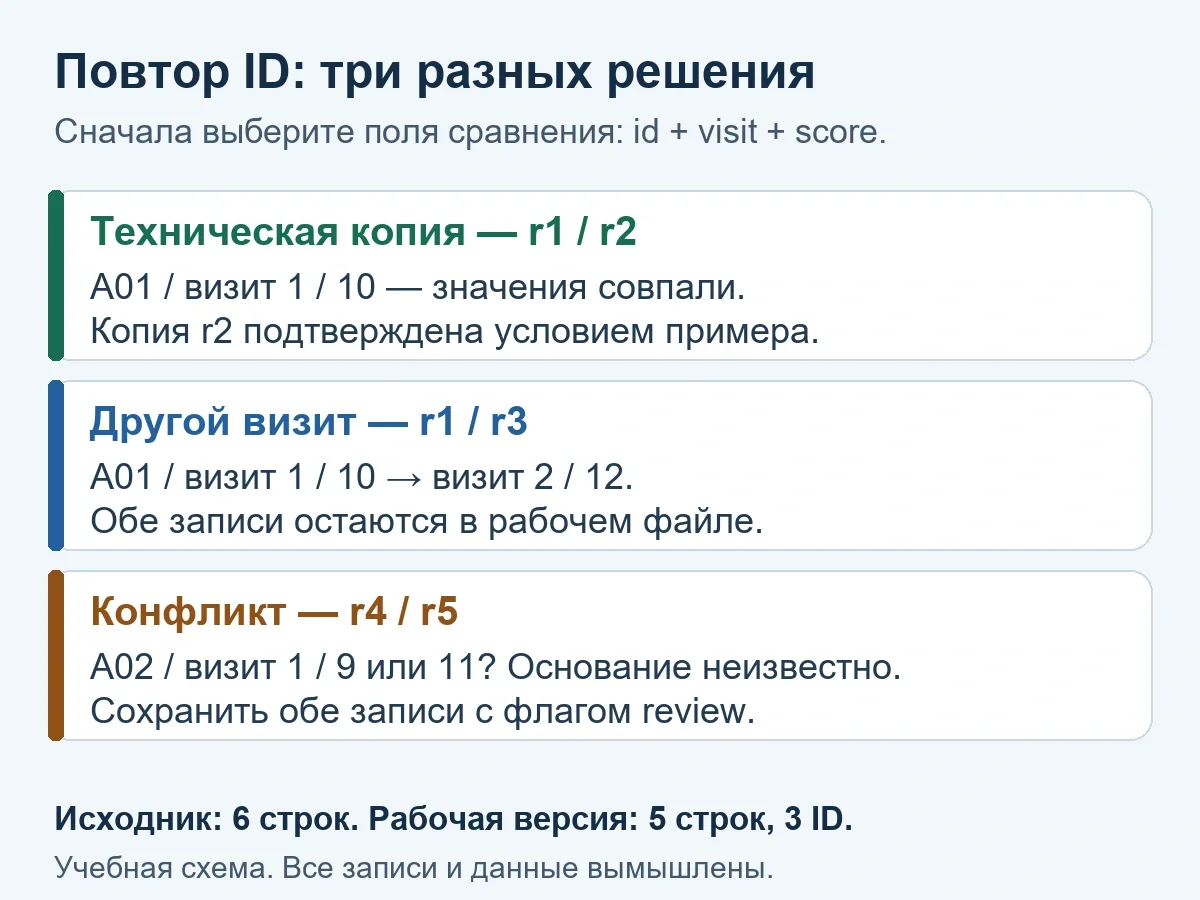
Представьте, что у вас есть таблица с результатами тестирования. У неё технический номер строки (row), идентификатор участника (id), номер визита (visit) и балл (score). Поле row — это служебный номер происхождения записи, он не участвует в бизнес-сравнении.
| Строка | Запись |
|---|---|
| r1 | A01, визит 1, балл 10 |
| r2 | A01, визит 1, балл 10 |
| r3 | A01, визит 2, балл 12 |
| r4 | A02, визит 1, балл 9 |
| r5 | A02, визит 1, балл 11 |
| r6 | A03, визит 1, балл 8 |
Первый шаг: выбираем поля для сравнения
Прежде чем искать дубликаты, решите, какие столбцы входят в бизнес-сравнение. В этом примере row не входит. Если оставить row в проверке, все шесть строк окажутся уникальными, потому что у каждой свой технический номер.
Метод pandas DataFrame.duplicated() как раз позволяет ограничить сравнение нужными полями с помощью параметра subset. По умолчанию он смотрит все столбцы, что в учебном файле дало бы False для каждой строки — бесполезно. keep=False помечает True все строки, входящие в повторяющуюся группу, а не только повтор после первого вхождения.
Три маски совпадения
Маска 1: поля id, visit, score
Сравнение по трём полям ищет полные дубликаты — строки, где совпало всё: участник, визит и балл. Результат:
| Строка | Совпадение |
|---|---|
| r1 | True |
| r2 | True |
| r3 | False |
| r4 | False |
| r5 | False |
| r6 | False |
По трём выбранным полям совпадают r1 и r2. Само совпадение ещё не объясняет происхождение записей и не даёт основания удалить одну из них.
Маска 2: поля id, visit
Если убрать из сравнения score, мы увидим пары с одинаковым участником и номером визита, независимо от балла:
| Строка | Совпадение |
|---|---|
| r1 | True |
| r2 | True |
| r3 | False |
| r4 | True |
| r5 | True |
| r6 | False |
Здесь r4 и r5 — участник A02, оба в первый визит, но с разными баллами (9 и 11). Для pandas это дубликат по выбранным полям. Но для задач исследования это не дубликат, а конфликт.
Маска 3: одно поле id
Сравнение только по id покажет всех, кто встречается более одного раза, независимо от визитов и баллов:
| Строка | Совпадение |
|---|---|
| r1 | True |
| r2 | True |
| r3 | True |
| r4 | True |
| r5 | True |
| r6 | False |
Пять строк из шести отмечены — слишком грубо для бизнес-решения. Эта маска помогает найти повторяющиеся ID, но не различает визиты, копии и конфликты. В ней A03 встречается один раз, а A01 и A02 требуют проверки по другим полям.
Журнал решений: три разных основания
| Строка | Решение |
|---|---|
| r1 | оставляем как первую запись визита |
| r2 | удаляем — это техническая копия r1 при повторной выгрузке (подтверждено документацией учебного примера) |
| r3 | оставляем — это другой визит участника A01 |
| r4 | оставляем — причина расхождения баллов не известна, помечаем флагом review |
| r5 | оставляем — та же пара id+visit, флаг review |
| r6 | оставляем — единственная запись A03 |
Итоговая рабочая версия: пять строк
После исключения технической копии r2 в рабочей таблице остаётся пять строк. В них три различных идентификатора (A01, A02, A03) и четыре различных пары id+visit (A01/1, A01/2, A02/1, A03/1). Пара A02/1 представлена двумя строками (r4, r5) с разными баллами — это неразрешённый конфликт, и обе строки сохранены с пометкой review.
| Строка | Запись |
|---|---|
| r1 | A01, visit 1, score 10 (оставлена) |
| r3 | A01, visit 2, score 12 (оставлена) |
| r4 | A02, visit 1, score 9 (оставлена, review) |
| r5 | A02, visit 1, score 11 (оставлена, review) |
| r6 | A03, visit 1, score 8 (оставлена) |
Пять строк не означают пять уникальных участников: в рабочей версии три ID. Не следует также считать каждую строку отдельным подтверждённым наблюдением: ключ A02/1 представлен двумя строками с разными баллами. Его статус остаётся неразрешённым; эти оценки не включают в анализ до уточнения источника.
Чего не делать с конфликтной парой
Когда мы не знаем, почему в одном визите два разных балла, нельзя выбирать последнее значение, максимальное, минимальное или среднее арифметическое. Любое из этих действий — не очистка данных, а подмена реальности собственным предположением. В этом учебном примере обе строки сохраняют с флагом review и уточняют источник. Для реального набора решение принимают по его протоколу и документированным основаниям.
Почему техническая копия не определяется автоматически
В учебном примере дополнительное условие гласит: r2 — техническая копия r1, возникшая при повторной выгрузке. Но pandas не знает этого — он видит только одинаковые числа. Поэтому решение об удалении принимает человек, опираясь на документацию процесса: например, на журнал выгрузок. Если бы такой пометки не было, r1 и r2 остались бы неразличимы. Учебные данные подготовлены 27.10.2026.
Главное
- Не включайте технический номер строки в бизнес-сравнение.
- Явно выбирайте поля для
subsetвduplicated(): результат зависит от того, на какой вопрос отвечает сравнение. - Три различных набора полей дают три разных ответа: полные дубликаты, пары id+visit и всех участников с повтором.
- Техническую копию от повторного визита отличает не алгоритм, а внешняя документация.
- Неразрешённый конфликт (одинаковые id+visit, разные score) не подлежит автоматическому сглаживанию — сохраняйте обе строки и ставьте пометку.
Разобраться в структуре данных поможет статья о том, как преобразовать таблицу из широкого формата в длинный. Если в вашем проекте возникла ситуация с неоднозначными записями и нужна консультация статистика, вы можете обсудить помощь со статистическим анализом. Заранее согласуйте вопрос, состав исходных файлов и объём консультации.


Похожие статьи
 Дипломы
12
мин
06.03.2023
50433
Защита дипломной работы. Сроки. Как проходит
Защита дипломной работы – это обязательная процедура, необходимая для присвоения квалификации магистра/специалиста/бакалавра. Чтобы получить допуск, студент обязан успешно завершить учебную программу по выбранному направлению и своевременно подготовить дипломный проект в соответствии со всем
 Дипломы
10
мин
26.10.2026
Как зафиксировать окружение расчёта Python и проверить контрольный запуск
Вы несколько раз запускали скрипт, получили числа, сохранили результат. Через месяц коллега или научный руководитель просит повторить расчёт. Вы запускаете файл, а он выдаёт ошибку импорта или другое среднее. Знакомая ситуация: на чужом компьютере нет библиотеки, которую вы ставили когда-то, или Pyt
 Дипломы
3
мин
27.12.2022
22424
Титульный лист для дипломной работы: правила составления и оформления
Титульный лист диплома – это первая страница документа, содержащая сведения об учебном заведении, авторе работы и научном руководителе проекта, городе и годе написания, а также иную дополнительную информацию, необходимую для поиска и обработки дипломной работы в поисковой системе соответствующ
 Дипломы
12
мин
01.10.2026
Какие вопросы задают на защите диплома: как готовить ответы
Единого перечня вопросов для всех защит ВКР в проверенных документах НИУ ВШЭ не установлено. Регламент этого университета предусматривает вопросы, непосредственно связанные с темой ВКР или близкие к ней. При ответе студент вправе пользоваться текстом своей работы. Это локальное правило НИУ ВШЭ, поэт
 Дипломы
14
мин
01.10.2026
Научная новизна дипломной работы: как показать собственный результат
Научная новизна дипломной работы не обязательно означает мировое открытие. В этой статье под ней понимается конкретный собственный результат, который студент показывает в сравнении с существующими работами, подходами или решениями и подтверждает материалами ВКР. Точное содержание этого пункта и необ
 Дипломы
17
мин
01.10.2026
Цели и задачи дипломной работы: как правильно сформулировать и связать с главами
Цель дипломной работы показывает, какой исследовательский результат студент намерен получить. Задачи объясняют, какие последовательные действия приведут к этому результату. Если между проблемой, целью, задачами, методами и главами нет связи, введение выглядит формальным, а в заключении трудно доказа
Последние новости и статьи
 Помощь по написанию
23
мин
27.10.2026
21427
Как написать научную статью - пошаговая инструкция
Научная статья связывает исследовательский вопрос, способ работы с материалом, результаты и вывод. Её можно написать единолично или в соавторстве, но в любом случае читателю должно быть понятно, что именно сделано и на чём основано утверждение автора. Смысловая завершённость не означает, что в одной
 Оформление и требования к диссертации
20
мин
27.10.2026
Лед, кольца, налоги: как учёные распутывают цепочку от извержения до кризиса
В 1816 году Байрон написал «Тьму» — стихотворение о потухшем солнце и ледяной земле, на которое, возможно, повлияли последствия извержения Тамборы. Годом ранее в Индонезии взорвался вулкан. Погибли десятки тысяч человек рядом с жерлом, а сернистый аэрозоль извержения способствовал охлаждению и экстр
 Рефераты
8
мин
27.10.2026
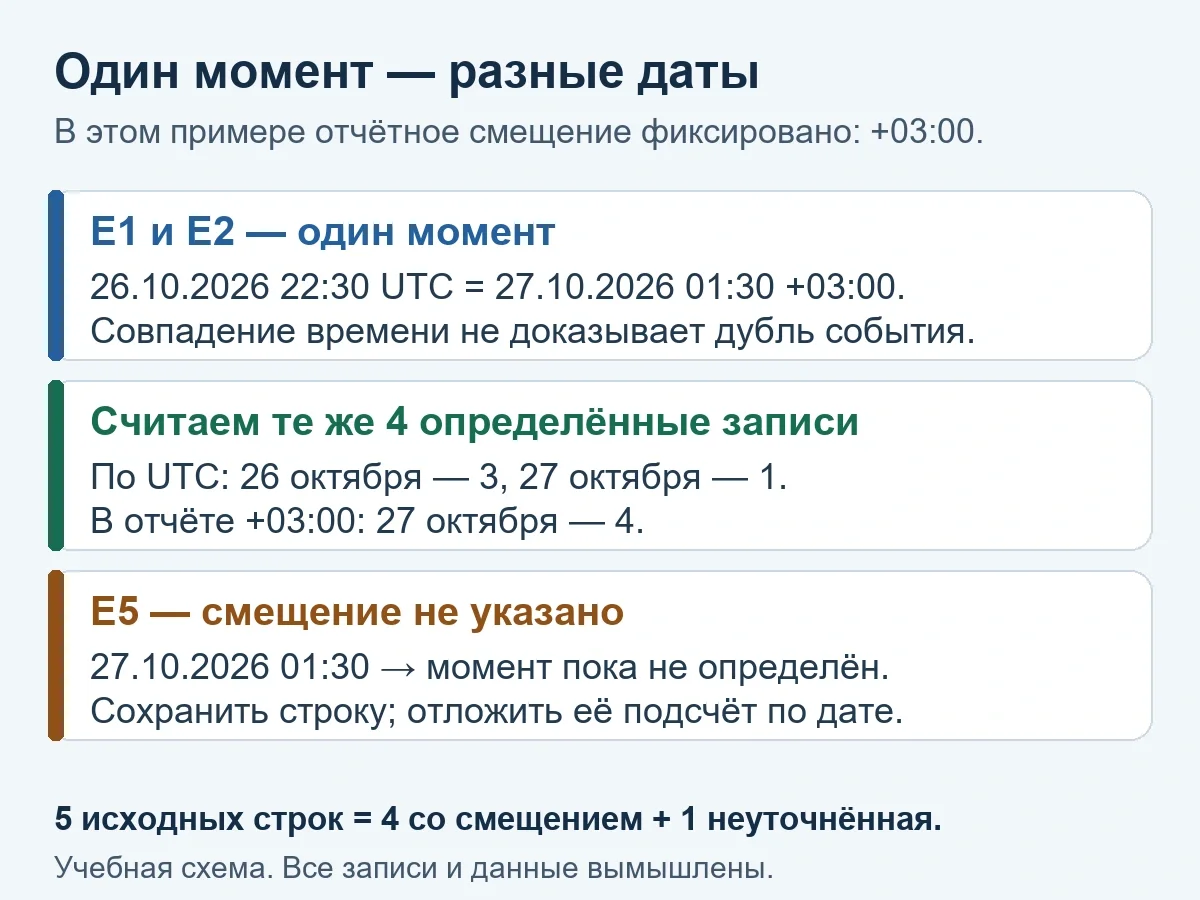
Как сверить временные метки с разными смещениями UTC перед подсчётом по дням
В файле пять временных меток: четыре со смещением UTC и одна без него. Нужно посчитать записи по дням в едином отчётном времени. Даты в исходных строках сравнивать напрямую нельзя: один момент может иметь разные календарные даты при разных смещениях. Все записи и обстоятельства этого примера вымышле
 Наука
3
мин
26.10.2026
После отмены ингибитора TNF при артрите самооценки здоровья ухудшились к 12-й неделе
У 102 взрослых с ревматоидным артритом в стойкой ремиссии или с низкой активностью болезни самооценки здоровья в среднем ухудшились вскоре после отмены ингибитора фактора некроза опухоли (TNF). К концу 48-недельного наблюдения показатели вернулись к исходным после возобновления терапии. Результаты о
 Наука
4
мин
26.10.2026
Лишний год в школе снизил риск деменции: естественный эксперимент на реформе 1972 года
Сентябрь 1957 года в Великобритании делил не только классы, но и будущее здоровье: ученики, родившиеся 1 сентября 1957 года или позже, должны были учиться до 16 лет, а те, кто появился на свет днём раньше, могли бросить школу в 15. Спустя почти полвека этот разрыв в один год привёл к измеримой разни
 Вузы
4
мин
26.10.2026
НИУ ВШЭ — Нижний Новгород принимает заявки на премию выпускников «30 в 30» до 2 ноября
Нижегородский кампус Высшей школы экономики объявил приём заявок на премию для своих выпускников «30 в 30». Проект приурочен к тридцатилетию кампуса, заявки принимают до 2 ноября 2026 года. Выдвинуть можно себя или другого человека — выпускника бакалавриата, магистратуры, аспирантуры или программы M