


Содержание статьи
Как отличить клонированный голос от живого: что показывают джиттер, шиммер и водяные знаки
Дипломы
04.11.2026
04.11.2026
9
мин
В январе 2024 года десятки тысяч избирателей в Нью-Гэмпшире получили робозвонок якобы от Джо Байдена с призывом не голосовать на праймериз. Голос синтезировал сервис ElevenLabs, где мгновенное клонирование стоит от 5 долларов в месяц. Осенью 2026 года Scientific American напомнил о деле, где человек с клонированным голосом выдал себя за юриста и убедил крупный итальянский банк перевести около 95 миллионов евро. Вопрос «настоящий ли это голос» перестал быть технической диковинкой.
Что об этом известно из проверяемых работ, а что держится на одном авторском наблюдении и осторожных оговорках?
Эксперимент с 604 слушателями
Главная доказательная база по человеческому восприятию — рецензированное исследование Sarah Barrington, Emily A. Cooper и Hany Farid из Калифорнийского университета в Беркли (Scientific Reports, 31 марта 2025, открытый доступ). Авторы взяли записи 220 носителей английского языка из набора DeepSpeak, жителей США от 18 до 75 лет. Для каждого говорящего они создали клон через ElevenLabs Instant Voice Cloning, подав на вход всего две записи. Средняя длина фрагмента — 5,37 секунды, разброс от 0,88 до 52,57 секунды.
Слушателей было 604, задачи разные. В первой 304 человека слушали пару записей и отвечали, говорит ли один и тот же человек. Две настоящие записи одного говорящего почти всегда получали ответ «тот же человек» (медиана 100%). Пару «настоящая запись плюс клон» тоже считали одним голосом в большинстве случаев: медиана 83,3%. При этом два разных, но похожих голоса редко путали (медиана 11,1%). То есть участники не соглашались со всем подряд — клон действительно звучал как оригинал.
Во второй задаче 300 человек слушали записи по одной и классифицировали каждую как настоящую или сгенерированную. Средняя точность — 67,4% на настоящих записях и 60,8% на клонах. Для 21,0% участников результат на клонах оказался на уровне случайного угадывания или хуже. Авторы пишут, что люди часто принимают клон за голос того же человека и не могут надёжно определить, когда услышанный голос создан ИИ.
Оговорка из самой статьи: в эксперименте всё внимание участника было направлено на голос. В реальном разговоре человек занят содержанием, и его, вероятно, обмануть ещё проще.
Разговор подлиннее: предварительные данные
В основных экспериментах более длинные фрагменты и фрагменты без зачитывания текста давали более точные оценки. В дополнительном исследовании с 30 новыми слушателями медианная точность составила 83,3% для комбинированных записей, 76,7% для свободного рассказа и 56,7% для чтения заранее заданного текста. Отсюда авторы предлагают возможную тактику: втянуть собеседника в долгий разговор с открытыми вопросами.
Доказательство при этом предварительное. Связь длительности с точностью слабая или умеренная (коэффициент Спирмена rs = 0,245). В объединённой регрессионной модели эффекты длительности и формата записи не достигли статистической значимости, по-видимому, из-за корреляции между ними. Авторы прямо пишут, что нужен больший набор данных. «Задавайте открытые вопросы и говорите дольше» — разумная эвристика, а не проверенный тест с порогом.
Джиттер, шиммер и миф о «слишком чистом» голосе
Раньше подделку выдавала излишняя отполированность: в синтезе не было дыхания, пауз, «ээ» и «мм». Теперь эти элементы добавляют намеренно. Взгляд сместился на микроструктуру самой волны. Если сильно увеличить масштаб записи, каждое колебание голосовых складок видно как повторяющийся пик сигнала. Джиттер — вариации длительности этих циклов, шиммер — вариации высоты пиков. Детектирующие модели могут взвешивать такие параметры вместе с множеством других.
Здесь важно не переоценить источник. Сведения о джиттере и шиммере взяты не из рецензированного эксперимента, а из авторского теста в Scientific American. Журналист Shafik Quoraishee, имеющий опыт акустического анализа, сравнил около двух десятков предложений, произнесённых им самим и его клоном. При работающем обогревателе на фоне джиттер клона статистически не отличался от его собственного, а шиммер был ровнее. В тихой комнате клон оказался заметно «чище», с меньшим шумом под тоном во всех 12 предложениях, даже после имитации телефонного разговора.
Это наблюдение на одном голосе, без независимой проверки. Превращать его в правило «проверь шиммер — и узнаешь подделку» нельзя. Само исследование Barrington и коллег показывает, почему бытовые признаки ненадёжны: участники упоминали фоновый шум 79 раз, но статистического эффекта шума на точность не нашли. Авторы советуют шум как признак игнорировать и слушать сам голос.
Почему одного показателя мало
Спектральный анализ, то есть карта изменения частот во времени, может выдать характерные особенности конкретного инструмента клонирования. Но, по словам Barrington, «не существует единой меры, которая работала бы для всех сервисов». Детекторы, обученные на сигнатурах одного провайдера, «часто плохо переносятся на других». Телефонный канал сжимает и искажает звук, стирая значительную часть криминалистических деталей. Отсюда вывод Scientific American: нужен набор инструментов, а не одна акустическая метрика.
Криминалистические методы в целом превосходят человека по отдельным характеристикам, но работают асинхронно, после записи, а не в реальном времени во время звонка. Синхронная проверка на стороне оператора связи подняла бы вопросы приватности, и ей потребовалась бы очень высокая точность, чтобы не давать ложных тревог и ложного чувства защищённости.
Экономика тоже против детектора. Farid в интервью Scientific American в 2024 году говорил, что обнаружение сложнее генерации из-за тонких признаков и растущего качества подделок, а среди общедоступных инструментов не назвал ни одного достаточно надёжного.
Водяные знаки: замок, а не сейф
Наиболее перспективный на сегодня механизм — встроенная метка происхождения. Некоторые производители, например Google, прячут в сгенерированном звуке неслышимый водяной знак: малозаметные изменения по всему сигналу, которые сохраняются в файле и считываются детектором позже. Но метка не гарантирует безопасность: запись можно изменить так, что знак исчезнет, а в части открытых программ он необязателен. Авторы Scientific Reports добавляют: если не все генераторы ставят метки, мошенники уйдут к тем, кто их не ставит. Barrington сравнивает хороший водяной знак с запертой дверью, которая «отсекает 99 процентов плохих случаев».
Механика меток в звуке родственна маркировке сгенерированных изображений, но у изображений свои слабые места: в материале о том, сохраняются ли водяные знаки ИИ-изображений при обучении новых моделей, разобрано, как метка переживает последующую обработку.
Что делать практически
Слух — плохой детектор. Признак «слишком чистый голос» устарел, фоновый шум неинформативен, а джиттер и шиммер имеют смысл только как часть комплексной акустической экспертизы, не как домашний тест. При подозрительном звонке разумно выйти за пределы канала: перезвонить по известному номеру, задать вопрос, ответ на который знает только настоящий собеседник. Долгий разговор с открытыми вопросами даёт какой-то шанс, но подтверждён он пока предварительными данными.
Системное решение лежит не в ушах слушателя, а в сочетании водяных знаков у генераторов и набора криминалистических инструментов у приёмника. Открытый научный вопрос — проверенные признаки для обнаружения клона в реальном времени по телефонному каналу: надёжного набора сегодня нет.
Источники
- Barrington S., Cooper E. A., Farid H. People are poorly equipped to detect AI-powered voice clones. Scientific Reports, 15, 11004 (2025). DOI: 10.1038/s41598-025-94170-3, полный текст, PDF.
- Аудиоданные исследования: DeepSpeak Dataset.
- Quoraishee Sh. How to tell if a voice recording is AI-generated. Scientific American, 2 ноября 2026. Текст статьи.
- Leffer L. AI Audio Deepfakes Are Quickly Outpacing Detection. Scientific American, 26 января 2024. Текст статьи.
Материал подготовлен как научно-популярный обзор иностранных публикаций; он не является собственным исследованием редакции или рецензируемой статьёй.
Фото: Vitaly Gariev / Pexels


Похожие статьи
 Дипломы
8
мин
27.10.2026
Одинаковый ID в таблице: как отличить дубликат от повторного наблюдения
Вы открываете файл с данными и видите, что у одного и того же идентификатора несколько раз записаны баллы. Первая мысль: «Ошибка выгрузки, нужно удалить повторы». Но не все совпадения значений — это технические дубликаты. Часть может оказаться повторными визитами одного участника, а часть — конфликт
 Дипломы
17
мин
01.10.2026
Цели и задачи дипломной работы: как правильно сформулировать и связать с главами
Цель дипломной работы показывает, какой исследовательский результат студент намерен получить. Задачи объясняют, какие последовательные действия приведут к этому результату. Если между проблемой, целью, задачами, методами и главами нет связи, введение выглядит формальным, а в заключении трудно доказа
 Дипломы
10
мин
26.10.2026
Как зафиксировать окружение расчёта Python и проверить контрольный запуск
Вы несколько раз запускали скрипт, получили числа, сохранили результат. Через месяц коллега или научный руководитель просит повторить расчёт. Вы запускаете файл, а он выдаёт ошибку импорта или другое среднее. Знакомая ситуация: на чужом компьютере нет библиотеки, которую вы ставили когда-то, или Pyt
 Дипломы
4
мин
27.12.2022
29865
Содержание дипломной работы: требования и правила оформления
Содержание в дипломной работе упрощает навигацию по работе, поэтому содержит в себе весь структурный план ВКР: здесь перечисляются все главы, подглавы, разделы, пункты, подпункты, параграфы с обязательным указанием номеров страниц, на которых расположено их начало. По требованию действующих госстанд
 Дипломы
15
мин
01.10.2026
Предзащита диплома: как проходит, что говорить и что взять с собой
Предзащита диплома — так студенты обычно называют предварительное представление выпускной квалификационной работы до официальной защиты. В локальных документах вуза эта процедура может называться иначе: например, промежуточной аттестацией по элементу «Подготовка ВКР», отчётом о ходе работы или предв
 Дипломы
7
мин
27.10.2026
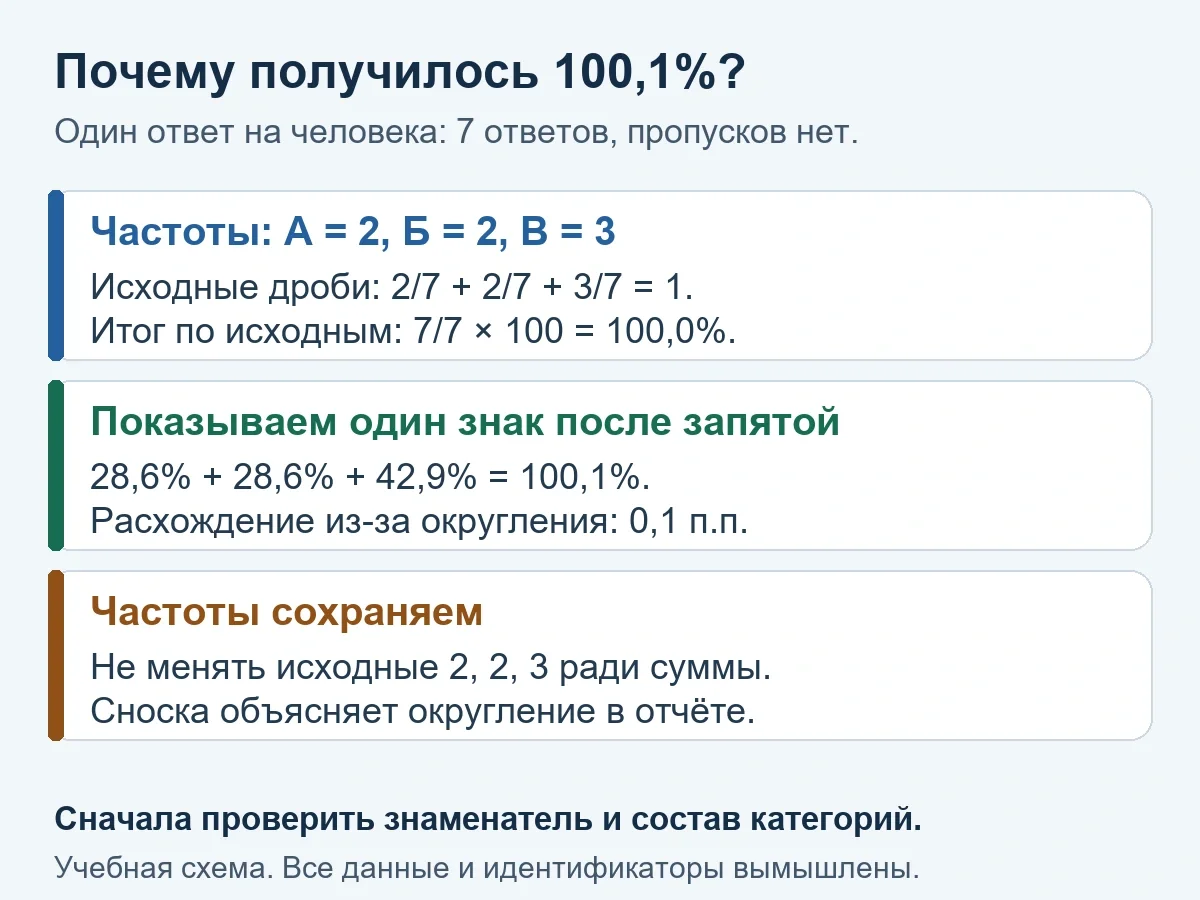
Почему сумма округлённых процентов равна 100,1%: как проверить таблицу
В таблице три показанных значения складываются так: 28,6% + 28,6% + 42,9% = 100,1%. Такое расхождение может возникнуть, если округлить долю каждой категории отдельно. Но одной этой суммы недостаточно, чтобы подтвердить правильность расчёта: сначала проверьте частоты, знаменатель и состав категорий.
Последние новости и статьи
 Дипломы
11
мин
04.11.2026
Почему аспиранты в Индонезии боятся жаловаться на научных руководителей
Во время научной стажировки в Западном Мичиганском университете математик Рулли Чаритас Прамана, преподаватель Университета Ахмада Дахлана в индонезийской Джокьякарте, увидел, как его американский коллега в выходной день катается на велосипеде вместе со своими аспирантами. Для него это оказалось кул
 Оформление и требования к диссертации
10
мин
04.11.2026
Белый трюфель в жару: что могут дать лес и полив
Первого октября 2026 года в лесах вокруг Альбы, где добывают самый известный белый трюфель, охотники-«трифолау» открыли сезон. Месяц спустя Associated Press подвёл предварительные итоги: летняя жара отозвалась и размером грибов, и ценой. Антонио Деджакоми, президент Национального центра изучения трю
 Оформление работ
14
мин
04.11.2026
Почему «reach» и «react» читаются по-разному, и при чём здесь подготовка учителя
Ребёнок останавливается на слове, пробует его прочитать и смотрит на учителя. Если произнести слово вслух, предложение поедет дальше и урок не встанет. Статья Джереми Ло и Александры Бёзе, вышедшая в The Conversation и перепечатанная phys.org 27 октября 2026 года, начинается с этой сцены. Дальше авт
 Наука
4
мин
03.11.2026
Кровь задолго до симптомов: что показал тест на ptau-217 у почти 3 000 пожилых людей
У людей без жалоб на память очень высокий уровень белка ptau-217 в крови связан с резко повышенным риском болезни Альцгеймера в следующие десять лет. К такому выводу пришла группа исследователей из Mass General Brigham во главе с нейробиологом Рэйчел Бакли: они проанализировали данные почти 3 000 по
 Наука
3
мин
03.11.2026
Плотная сейсмическая сеть выявила два магматических резервуара под Килауэа
Группа исследователей под руководством Lin et al. получила сейсмическое изображение магматической системы под вершиной Килауэа и различила два отдельных резервуара: один под кратером Халемаумау в главной кальдере, другой под южной кальдерой. Об этом сообщает Eos со ссылкой на статью в Journal of Geo
 Образование
5
мин
03.11.2026
Педагоги детского сада КФУ собрали заказ в «Тихом кафе» из карточек PECS
В специальном (коррекционном) детском саду для детей с расстройствами аутистического спектра Казанского федерального университета «Мы вместе» педагогический коллектив провёл занятие «Тихое кафе. Национальная кухня Татарстана». Пресс-служба КФУ сообщила о нём 3 ноября 2026 года. Меню было визуальным: