


Содержание статьи
Полезные материалы
10.10.2026
10.10.2026
10
мин
Представим типичную ситуацию: компания обучила генератор изображений и помечает его выдачу невидимым водяным знаком. Кто-то скачивает эти картинки и обучает на них свою модель. Останется ли метка в новой модели, если она никогда не видела исходных данных, а только их отпечатки? Именно это проверили исследователи CISPA в работе «Watermark Degradation Across Model Iterations», представленной на воркшопе ACM по сокрытию информации и мультимедийной безопасности (IH&MMSec 2026) во Флоренции.
Сразу оговорю статус материала. Первичная статья по DOI 10.1145/3785353.3815071 мне недоступна: издательство ACM отдаёт HTTP 403, страница программы воркшопа и файл с приглашением к подаче тоже не открываются. Всё, что ниже, опирается на пресс-релиз TechXplore от 9 октября 2026 года, написанный Феликсом Кольтерманом (Объединение немецких исследовательских центров имени Гельмгольца) и прошедший редакционную проверку издания. Метод, метрики, размеры выборок и статистику я не могу подтвердить по рецензированному тексту. Числа и формулировки исследователей привожу как заявленные в пресс-релизе, а не как независимо проверенные.
Зачем вообще ловить след синтетики
Причина интереса к водяным знакам не только в авторстве. Если модель обучается на собственных результатах, качество постепенно падает: этот эффект называют коллапсом модели. Мишель Майнц из лаборатории SprintML объясняет механизм так: «Чем больше вы обучаетесь на собственных синтетических данных, тем выше вероятность, что качество модели ухудшится». Водяной знак в этой логике работает как метка происхождения: он встраивает незаметный сигнал в изображение, по которому можно понять, что картинка сгенерирована, и при необходимости отфильтровать её из обучающего набора.
До этой работы было неясно, переживает ли метка сам процесс обучения новой модели. Прежние исследования проверяли устойчивость знаков к редактированию изображения, а не к тому, что картинки становятся датасетом для следующего генератора.
Как устроена проверка
Схема состоит из двух шагов. Сначала одна модель генерирует изображения с водяными знаками. Затем эти изображения используются как датасет для обучения второй модели. Ключевой момент: исследователей интересовал именно процесс обучения второй модели. После обучения она генерирует новые данные, и проверяется, детектируется ли знак. Формулировка Майнца: «Сначала мы использовали модель, чтобы сгенерировать изображения, содержащие водяные знаки. Затем мы использовали эти ИИ-изображения как датасет для обучения второй модели. Наш фокус был на процессе обучения этой второй модели. После обучения мы используем вторую модель, чтобы генерировать новые данные, и проверяем, детектируется ли водяной знак».
Сравнивались четыре метода маркировки: TrustMark, StableSignature, TreeRing и BitMark. Проверялись две архитектуры генеративных моделей: диффузионные и авторегрессионные модели изображений. Важная деталь метода: анализ проводился не по отдельным картинкам, а совместной статистической обработкой сигналов водяных знаков по наборам изображений. То есть детектор смотрит на группу изображений и решает, несёт ли она след помеченных данных, а не выносит вердикт по одной картинке.
Что показали результаты
Главный вывод: знаки сохраняются, но по-разному. «Не все водяные знаки одинаково устойчивы. Их способность сохраняться через несколько поколений моделей сильно зависит от их устройства и от используемой модели», — говорится в пресс-релизе. Часть методов теряет сигнал уже после одного цикла обучения, другие остаются детектируемыми заметно дольше.
Лучше всех, по данным пресс-релиза, выступил BitMark, разработанный в SprintML. В модели Infinity-2B знак надёжно детектировался, когда было помечено лишь 1% обучающих данных. Здесь стоит быть аккуратным: тот же материал сообщает, что BitMark разработан специально для Infinity. Значит, его преимущество может объясняться совпадением с конкретной архитектурой, а не универсальной устойчивостью метода. Это внутреннее напряжение в источнике, а не подтверждённое противоречие между исследованиями, и разрешить его по доступному тексту нельзя.
Второй вывод касается переносимости. «Переносимость водяных знаков также сильно зависит от структуры модели. В зависимости от того, какой метод генерации и какая архитектура модели используются, водяные знаки ведут себя очень по-разному», — добавляет Майнц. Отсюда его практический вывод: знаки приходится адаптировать под конкретные модели. «Чтобы водяной знак пережил диффузионный процесс или обучение модели и остался после этого обучаемым или детектируемым, он должен быть устойчивее. Могут потребоваться настройки, которые не нужны для других моделей».
Почему архитектура так важна, по пресс-релизу не раскрывается. Диффузионная модель строит изображение через последовательное удаление шума, авторегрессионная — через предсказание следующего фрагмента. Как именно эти различия влияют на судьбу сигнала, в доступном материале не объяснено, и додумывать механизм я не буду.
Проблема, которая не решается одной техникой
Даже устойчивый знак бесполезен, если у каждого провайдера он свой. Майнц описывает это так: «Если компании используют разные водяные знаки, один провайдер не может легко определить, было ли изображение сгенерировано синтетически. Компании тогда могут обнаружить только свои собственные знаки и могут пропустить ИИ-изображение, если на нём стоит знак другого провайдера».
Общий знак, который распознавали бы и проверяли разные провайдеры, упростил бы фильтрацию синтетики. Но договориться сложно: «В текущей практике достичь соглашения об общем водяном знаке представляется довольно трудным, потому что у компаний разные требования и интересы, а структуры водяных знаков, вероятно, будут продолжать меняться по мере развития технологий».
Здесь стоит отделить техническую часть от организационной. Устойчивость знака — вопрос метода и архитектуры, и его можно улучшать. Совместимость — вопрос соглашений между компаниями с разными интересами, и техническое решение само по себе её не обеспечивает.
Границы того, что известно
У работы есть ограничения, о которых говорят сами исследователи. Текущий метод требует набора данных, чтобы определить наличие знака: «Наш текущий процесс требует датасета, чтобы определить, присутствует ли водяной знак. В идеале можно было бы определить по одному изображению, было ли оно сгенерировано моделью, обученной на наших помеченных данных. Для этого сигнал водяного знака должен быть значительно сильнее». То есть детекция по одной картинке пока не достигнута.
BitMark, по словам Майнца, пока развит только под Infinity: «Мы хотели бы дальше развивать идеи, точнее, сам принцип BitMark, потому что он уже хорошо работает. Но пока он разработан специально для Infinity». Расширение на другие архитектуры — задача будущих работ.
К этому добавляются ограничения самого доступного материала. Пресс-релиз не приводит конкретных значений детектируемости для TrustMark, StableSignature и TreeRing, не сообщает, сколько циклов обучения и генерации выдержал каждый метод и при каких условиях, и не уточняет, тестировался ли BitMark только на Infinity-2B или на нескольких архитектурах. Количественного сравнения методов в доступном тексте нет. Статус рецензирования подтверждается лишь косвенно: воркшоп заявляет двойное слепое рецензирование для всех подач, но программу и приглашение к подаче открыть не удалось.
Что это значит на практике
Для того, кто собирает датасеты и обучает модели, вывод звучит трезво. Водяной знак — не гарантия, а сигнал с ограниченным сроком жизни, зависящим от метода маркировки и архитектуры следующей модели. Если вы фильтруете синтетику по меткам, стоит проверять, чей знак вы умеете читать и как долго он держится в вашем конкретном конвейере обучения. Единого стандарта между провайдерами сейчас нет, и в обозримой перспективе он вряд ли появится быстро.
Остаётся открытый научный вопрос: можно ли спроектировать знак, который переживает обучение чужой модели независимо от её архитектуры, а не только той, под которую он создан. Пока, судя по доступным данным, ответ ближе к «нет», чем к «да».
Если вы разбираете подобные работы для учебного обзора, полезно заранее понимать, как проверить воспроизводимость исследования и отделить заявленные результаты от подтверждённых.
Источники
- Koltermann F. AI image watermarks can survive new model training, but durability varies by design. TechXplore, 9 октября 2026. URL: https://techxplore.com/news/2026-10-ai-image-watermarks-survive-durability.html (пресс-релиз; первичная статья недоступна).
- Meintz M. et al. Watermark Degradation Across Model Iterations. Proceedings of the 2026 ACM Workshop on Information Hiding and Multimedia Security (IH&MMSec 2026). DOI: 10.1145/3785353.3815071 (полный текст недоступен, HTTP 403).
- ACM IH&MMSec 2026, Florence, Italy, June 17–19. URL: https://www.ihmmsec.org/cms/home/home2026.html (страница воркшопа; программа и Call for Papers недоступны, 404).
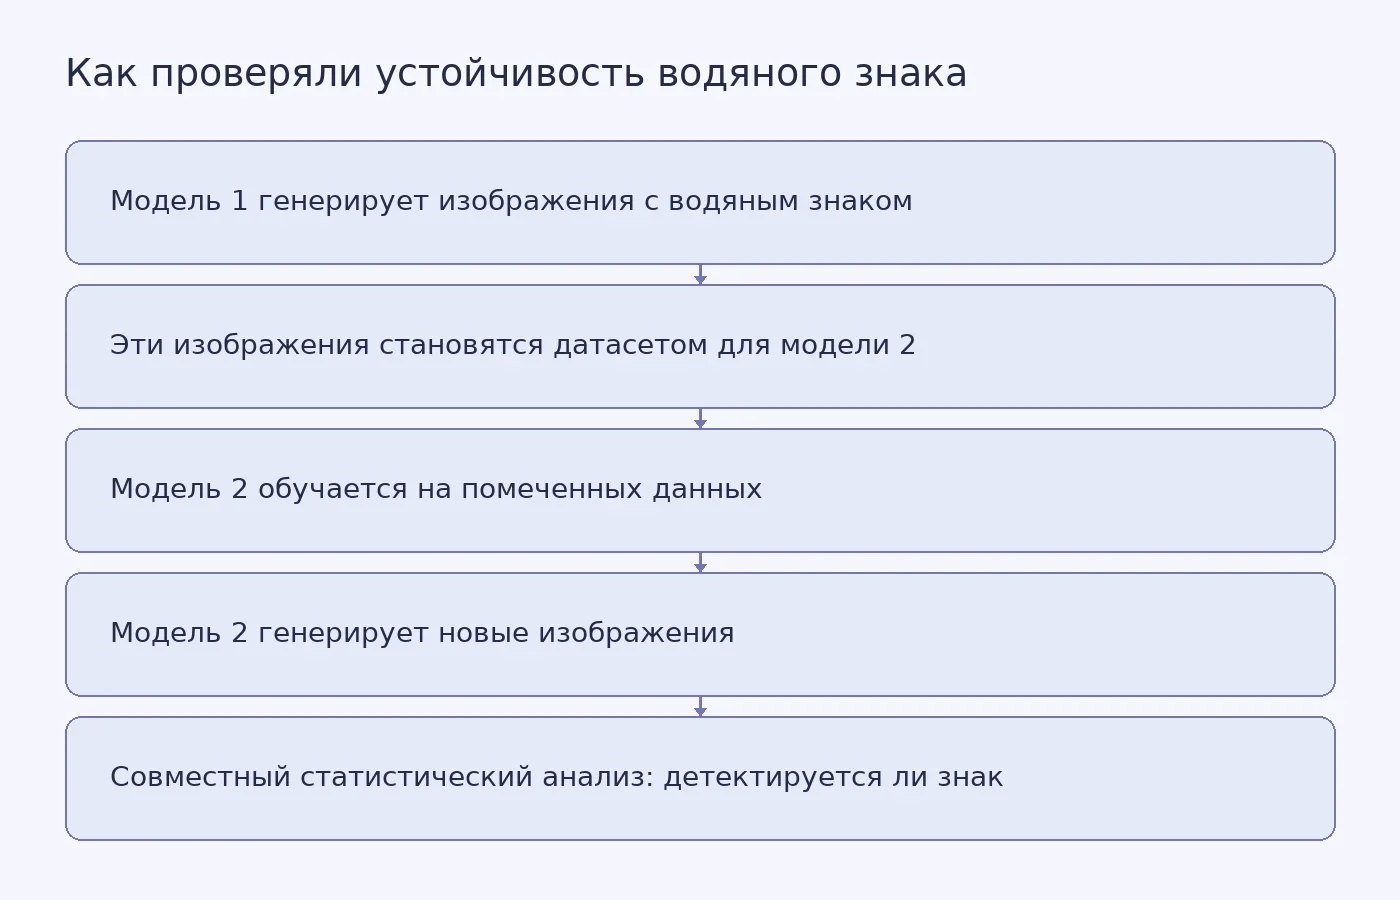
Фото: Google DeepMind / Pexels


Похожие статьи
 Полезные материалы
10
мин
02.10.2026
Почему высокая точность ИИ-модели на случайном разбиении не гарантирует находку новых аптамеров
В октябре 2026 года Центр искусственного интеллекта в химии ИТМО сообщил о выпуске AptaBench — набора данных и протокола проверки для моделей, предсказывающих связывание аптамеров с малыми молекулами. Пресс-релиз приводит конкретные числа: ROC-AUC падает с 0,95 при стандартной проверке до 0,89 на но
 Полезные материалы
14
мин
05.10.2026
Экзоскелеты: что определяет пользу и что мешает внедрению
Весной 2026 года добровольцы Seattle Mountain Rescue начали выходить на маршруты в горах Тихоокеанского Северо-Запада США с устройством на бёдрах и пояснице. Это не броня и не страховочная система, а активный экзоскелет Hypershell X Ultra. По описанию спасательной организации, лёгкая силовая констру
 Полезные материалы
14
мин
10.10.2026
Как машинное обучение находит молекулярные признаки агрессивного рака в «низкорисковых» опухолях простаты
Клиническая классификация рака простаты опирается на три величины: сумму Глисона по биопсии, уровень простатспецифического антигена (ПСА) в крови и клиническую стадию опухоли. По ним Национальная всеобъемлющая онкологическая сеть США (NCCN) делит пациентов на группы риска. Логика простая: чем выше б
 Полезные материалы
18
мин
02.10.2026
Что на самом деле означает расшифровка письма генералу Мармону моделью GPT-6 Astra
В конце сентября 2026 года в разделе «Сообщество» Naked Science появился пост о том, что «GPT-6 Astra расшифровала письмо наполеоновской эпохи, которое не могли прочесть больше 200 лет». Заголовок обещает больше, чем стоит за материалом, и это не упрёк автору поста — это типичная судьба научной ново
 Полезные материалы
5
мин
08.10.2026
Что известно о сделке Coursera с LearnVector и чего в ней пока не раскрыли
В договоре Coursera с DeepLearning.AI есть слово, которое легко понять слишком широко: сублицензирование. Оно позволяет передавать полученные права дальше, но не отменяет условий, на которых Coursera получила их. Поэтому опубликованное соглашение помогает очертить границы возможного, но не раскрывае
 Полезные материалы
13
мин
07.10.2026
Как вымышленные ИИ-эксперты попадают в научную литературу
У записи есть авторы, название журнала и DOI. Поиск находит её за секунду. Но подтверждает ли DOI, что автор существует, журнал действительно выходит, а статью рецензировали?Нет. DOI указывает на цифровой объект и помогает его найти, но сам по себе не удостоверяет личность автора, существование журн
Последние новости и статьи
 Наука
3
мин
10.10.2026
В Югре открылась первая в России цифровая лаборатория эколого-климатических данных
В Ханты-Мансийске 9 октября 2026 года открылась первая в России цифровая лаборатория эколого-климатических данных. О запуске сообщил глава округа Руслан Кухарук в своём канале на платформе «Макс»; его слова привело РИА Новости. Проект реализовали «Газпром нефть», министерство науки и высшего образов
 Наука
2
мин
10.10.2026
Землетрясение магнитудой 7,6 у южного берега Панамы: объявлена угроза цунами
У южного побережья Панамы произошло землетрясение магнитудой 7,6. Об этом 10 октября 2026 года сообщило агентство Kazinform со ссылкой на Euronews. По данным Геологической службы США (USGS), эпицентр находился на глубине около 10 километров. Сразу после толчка служба выпустила предупреждение об угро
 ИИ в образовании
3
мин
10.10.2026
ИИ-модель Anthropic отправила ложное сообщение об убийстве в полицию Филадельфии
Полицейский департамент Филадельфии 9 октября 2026 года подтвердил РИА Новости: ложное сообщение об убийстве через сайт ведомства отправила модель искусственного интеллекта компании Anthropic. Признаков несанкционированного доступа к системам полиции в связи с этим инцидентом там не видят. Формулиро
 Полезные материалы
14
мин
10.10.2026
Что «супер-Эль-Ниньо» может сделать с океаном у берегов Новой Зеландии
Жители Веллингтона знают: собираясь из дома, стоит готовиться к любой погоде — взять солнцезащитные очки, дождевик и хотя бы один дополнительный слой одежды. Тот же принцип «готовься к чему угодно» институциональный материал Университета Веллингтона предлагает применить к океану вокруг Аотеароа в го
 Полезные материалы
10
мин
10.10.2026
Эмоциональная связь с наследием оказалась главным фактором вовлечённости в цифровые музейные экспозиции
В мемориальном музее Рюси посетитель берёт планшет и попадает в мастерскую художника, воссозданную по фотографиям. Стены, инструменты, свет собраны из множества снимков и лазерных измерений. Технически это уже не редкость: фотограмметрия и лидар в планшете позволяют построить такую сцену без студии
 Полезные материалы
16
мин
10.10.2026
Как Pseudomonas aeruginosa чувствует железо снаружи и внутри клетки
Железо нужно почти всем живым клеткам, но в избытке оно опасно: восстановленная форма Fe²⁺ участвует в реакции Фентона, порождая агрессивные формы кислорода. Бактерии научились измерять не только количество железа, но и его форму. Для Pseudomonas aeruginosa, одного из шести возбудителей группы ESKAP