


Содержание статьи
Полезные материалы
07.10.2026
07.10.2026
13
мин
У записи есть авторы, название журнала и DOI. Поиск находит её за секунду. Но подтверждает ли DOI, что автор существует, журнал действительно выходит, а статью рецензировали?
Нет. DOI указывает на цифровой объект и помогает его найти, но сам по себе не удостоверяет личность автора, существование журнала или факт рецензирования. Препринт Михала Бжозовского и Нео Кристофера Чанга показывает, как повторяющиеся имена, которые языковые модели предлагают в ответах, затем обнаруживаются в интернете и научных метаданных.
Работа «Призрачная пара: связанные предпочтения языковых моделей в выборе имён и их следы в интернете и научных публикациях» размещена на arXiv. Первая версия появилась 1 июня 2026 года, версия 2 датирована 29 июля. Это препринт, а не прошедшая журнальное рецензирование статья. Ниже мы разбираем выводы авторов и отделяем их от того, что данные пока не позволяют заключить.
Модели повторяют не только имена, но и пары
Если модель часто выбирает одно имя, это ещё не значит, что она устойчиво воспроизводит одну и ту же вымышленную биографию. Авторы обнаружили более специфичный рисунок: некоторые имена регулярно появлялись вместе. В ответах отдельных моделей возникали повторяющиеся пары и тройки вымышленных персонажей.
Исследователи проверили через публичные программные интерфейсы девять версий Claude, десять версий GPT и одну версию Gemini. Для каждой версии использовали отдельные наборы по 30 одиночных и 30 парных запросов. Для Claude и Gemini дополнительно применяли по 30 запросов о трёх персонажах. Формулировки различались: от краткой просьбы придумать учёного до описания соавторов или исследовательской группы.
Температура генерации составляла 1,0. Для Claude и GPT параметр максимальной длины ответа был равен 800 токенам, для Gemini использовали ограничение 500 выходных токенов. Из ответов извлекали имена по шаблону двух соседних слов с заглавными буквами, затем считали частоту каждого имени и совместную встречаемость имён в одном ответе.
Такой подсчёт позволяет отличить популярное имя от устойчивой пары. Важно не только, сколько раз модель произнесла каждое имя, но и как часто они появлялись вместе.
В парных ответах Claude Sonnet 4 от мая 2025 года Elena Vasquez и Marcus Chen встречались вместе в 23% случаев. Общий тренд в более поздних версиях был нисходящим: затем в таблице появлялись промежуточные значения 20%, 13% и 10%, а в отдельных поздних версиях частота снижалась до 3% или 0%. У Gemini 2.5 Flash имя Aris Thorne появлялось в 93% одиночных ответов, а пара Aris Thorne и Lena Petrova встречалась в 37% парных. GPT часто предлагала Elara Voss, но постоянного партнёра для неё исследователи не обнаружили.
«Модели не просто выбирают отдельные вероятные имена. Они создают связанные ансамбли персонажей: пары и тройки, которые появляются вместе гораздо чаще, чем можно было бы ожидать случайно».
Перевод фрагмента из препринта Бжозовского и Чанга.
Почему модели предпочитают именно эти имена и связи, эксперимент не устанавливает. Авторы обсуждают возможное влияние обучающих данных и последующей настройки, но не проводили полного аудита обучающих корпусов. Тридцать запросов на условие помогают увидеть часто повторяющиеся варианты, однако могут не выявить редкие имена. Результаты относятся к проверенным версиям, доступным через публичные интерфейсы, а не ко всем языковым моделям.
От ответа модели до профиля автора
После проверки моделей исследователи использовали найденные имена как поисковые признаки. Они собирали результаты через поисковый интерфейс Google Serper, удаляли дубликаты и вручную проверяли страницы. Так авторы обнаружили 436 записей о публикациях на ResearchGate, связанных с именами Elena Vasquez, Marcus Chen, Aris Thorne, Lena Petrova и Elara Voss.
Это не означает, что в мире нет людей с такими именами. Авторы проверяли сочетание имени с указанной областью и организацией. В описанных ими случаях они не нашли прослеживаемого исследователя с таким именем, работающего в заявленной области и аффилированного с указанным учреждением.
Некоторые профили объединяли признаки, которые требуют проверки. Например, в одном профиле исследователи нашли 35 работ без цитирований. Темы публикаций охватывали безопасность Kubernetes, криптографию интернета вещей, сельское хозяйство и рентгеновскую визуализацию. Ни отсутствие цитирований, ни широкий круг тем сами по себе не доказывают, что профиль вымышленный. Значение имеет совокупность деталей: подтверждается ли связь автора с учреждением, существуют ли журналы и публикации, согласуется ли история работ.
Настоящий DOI, но неподтверждённый журнал
Отдельную проверку авторы провели на Zenodo, репозитории, которым управляет ЦЕРН. Для материалов Zenodo может автоматически регистрировать DOI через DataCite.
Запрос по названиям двух журналов вернул 1661 запись. У 1655 из них были DOI Zenodo, и авторы отнесли эти записи к подозрительному корпусу. Остальные шесть оказались легитимными материалами журнала с похожим названием. Названия Journal of Functional Materials и Journal of Computer Engineering не находились в Crossref как точные записи журналов; авторы также не обнаружили для них ISSN и подтверждённого издателя.
В пользовательских метаданных Zenodo для подозрительных публикаций были указаны даты 2020–2023 годов, тогда как временные отметки регистрации DOI в DataCite относились к марту и апрелю 2026 года. В марте зарегистрировали 991 запись, в апреле ещё 666.
Расхождение дат можно проверить по метаданным. Оно показывает, что DOI зарегистрировали позже, чем заявленная дата публикации, и служит основанием для дополнительной проверки. Однако временная отметка сама по себе не раскрывает намерений того, кто загрузил файл. Поэтому по ней нельзя безоговорочно заключить, что публикацию намеренно датировали задним числом.
«Все они зарегистрированы как действующие DOI в DataCite и доступны любому агрегатору, который собирает метаданные DataCite».
Перевод фрагмента из препринта Бжозовского и Чанга.
DOI подтверждает регистрацию цифровой записи. Он не подтверждает реальность журнала, личность автора или факт рецензирования. В описанном корпусе у записей не было связей в поле related_identifiers, которые указывали бы на DOI издателя.
Как модель может оставить след в вебе
Контекст даёт второй препринт тех же авторов, «Чтение следа дообучения: восстановление содержания методом контрастного сравнения генерации». В этой работе описан метод Contrastive Decoding Diffing, который сравнивает вероятности продолжения текста у базовой и дообученной моделей. В контролируемых экспериментах метод извлёк из моделей, среди прочего, имя вымышленной исследовательницы Elena Rodriguez, повторявшееся в синтетических учебных документах о пяти не связанных между собой областях.
Этот результат показывает возможный механизм: персонаж, многократно включённый в синтетические материалы, может закрепиться при дообучении и затем проявляться в ответах модели. Но вторая работа не доказывает, что именно так возникла каждая запись Zenodo. Связь между Elena Rodriguez из эксперимента с дообучением и более поздними именами, найденными в вебе и научных метаданных, авторы предлагают как возможную цепочку, а не как установленное происхождение каждого документа.
Как проверить научную запись
Если DOI выглядит убедительно, это повод открыть запись, а не прекращать проверку. Такой подход дополняет поиск и анализ литературы с помощью генеративного ИИ: модель может подсказать направление поиска, но сведения об авторах и публикациях нужно подтверждать независимо.
- Откройте запись DOI. Проверьте её в DataCite или Crossref. Посмотрите, кто зарегистрировал DOI, какие указаны даты и издатель, есть ли связанные идентификаторы.
- Проверьте журнал и издателя. Ищите журнал в независимых каталогах, проверьте ISSN, архив выпусков и сайт издателя. Если название встречается только в метаданных репозитория, запросите дополнительные подтверждения.
- Сопоставьте даты. Сравните заявленную дату публикации с серверной датой регистрации DOI. Большой разрыв требует объяснения, но не устанавливает мотив загрузившего.
- Проверьте авторскую биографию. Ищите страницу на сайте учреждения, профиль ORCID, подтверждаемую аффилиацию и другие публикации. Сверяйте эти сведения по первичным институциональным источникам.
- Посмотрите на историю публикаций. Тематически несвязанные работы, повторяющийся состав авторов или отсутствие подтверждаемой научной биографии могут быть поводом для дальнейшей проверки. Ни один такой признак не является доказательством сам по себе.
- Откройте полный текст. Сверьте файл с версией издателя, проверьте, описаны ли методы и данные, соответствуют ли ссылки теме. Идентификатор не заменяет чтение публикации.
Вопрос о том, как цитировать генеративную модель в учебной работе, отличается от проверки научной записи. Цитату из ответа модели можно оформить корректно, но это не удостоверяет указанного ею автора или журнал.
Насколько убедительны результаты
Сильная сторона препринта в том, что авторы проверили несколько звеньев предполагаемой цепочки разными способами. Сначала они повторяли запросы к моделям и измеряли частоту имён и их совместного появления. Затем искали эти имена в вебе и на ResearchGate. Для записей Zenodo они сопоставляли DOI и даты DataCite с пользовательскими метаданными, а также проверяли наличие Crossref, ISSN и связи с DOI издателя.
Но масштаб обнаруженных записей нельзя переносить на всю научную литературу. Авторы не оценивали, какая доля публикаций в целом имеет вымышленных авторов, и не показали, что все 1655 записей уже попали в основные библиографические индексы или повлияли на цитирование настоящих работ. Поиск через Google не охватывает весь интернет. Даты загрузки удалось извлечь только для 239 из 436 записей ResearchGate, то есть примерно для 55% этой части выборки.
Есть и более общий предел интерпретации. Эксперимент с повторяющимися именами объясняет, как такие имена могут стать поисковыми признаками, но не устанавливает происхождение каждого найденного документа. Кроме того, авторы не могут полностью исключить существование реальных исследователей с такими именами, чьи данные могли попасть в модель.
Nature пересказал работу как обнаружение сотен поддельных научных рукописей, многие из которых имеют настоящие DOI. Это редакционный материал, а не самостоятельная проверка всей выборки. Первичный источник остаётся препринтом Бжозовского и Чанга, поэтому его статус и ограничения важны при оценке вывода.
DOI открывает проверку, а не закрывает её
Возможная цепочка выглядит буднично: модель повторяет имя, оно появляется в новом тексте, текст загружают в открытый репозиторий, а запись получает DOI. Агрегатор может собрать эти метаданные, не проверяя отдельно личность автора и существование журнала.
Исследование документирует повторяющиеся предпочтения моделей в выборе отдельных имён и связанных пар, а также показывает, что записи с настоящими DOI могут содержать неподтверждённые сведения о журнале и дате публикации. Оно не измеряет распространённость таких записей во всей научной литературе. Практический вывод точнее громкого предупреждения: DOI помогает найти запись, но проверять её происхождение, журнал и авторскую биографию нужно отдельно.
Источники
- Brzozowski M., Chung N. C. The Ghost Couple: Correlated LLM Name Priors and Their Haunting of the Web and Academic Publishing. arXiv:2606.02184v2, 2026. Препринт, полный текст доступен.
- Brzozowski M., Dubanowska Z., Cassano E., Chung N. C. Reading the Finetuning Prior: Verbatim Content Recovery via Contrastive Decoding Diffing. arXiv:2605.25902v2, 2026. Препринт, полный текст доступен.
- Ryan J. Elena, Aris, Marcus: AI-generated ‘ghosts’ are polluting the scientific literature. Nature, 30 сентября 2026 года. Редакционный материал, не первичное исследование.
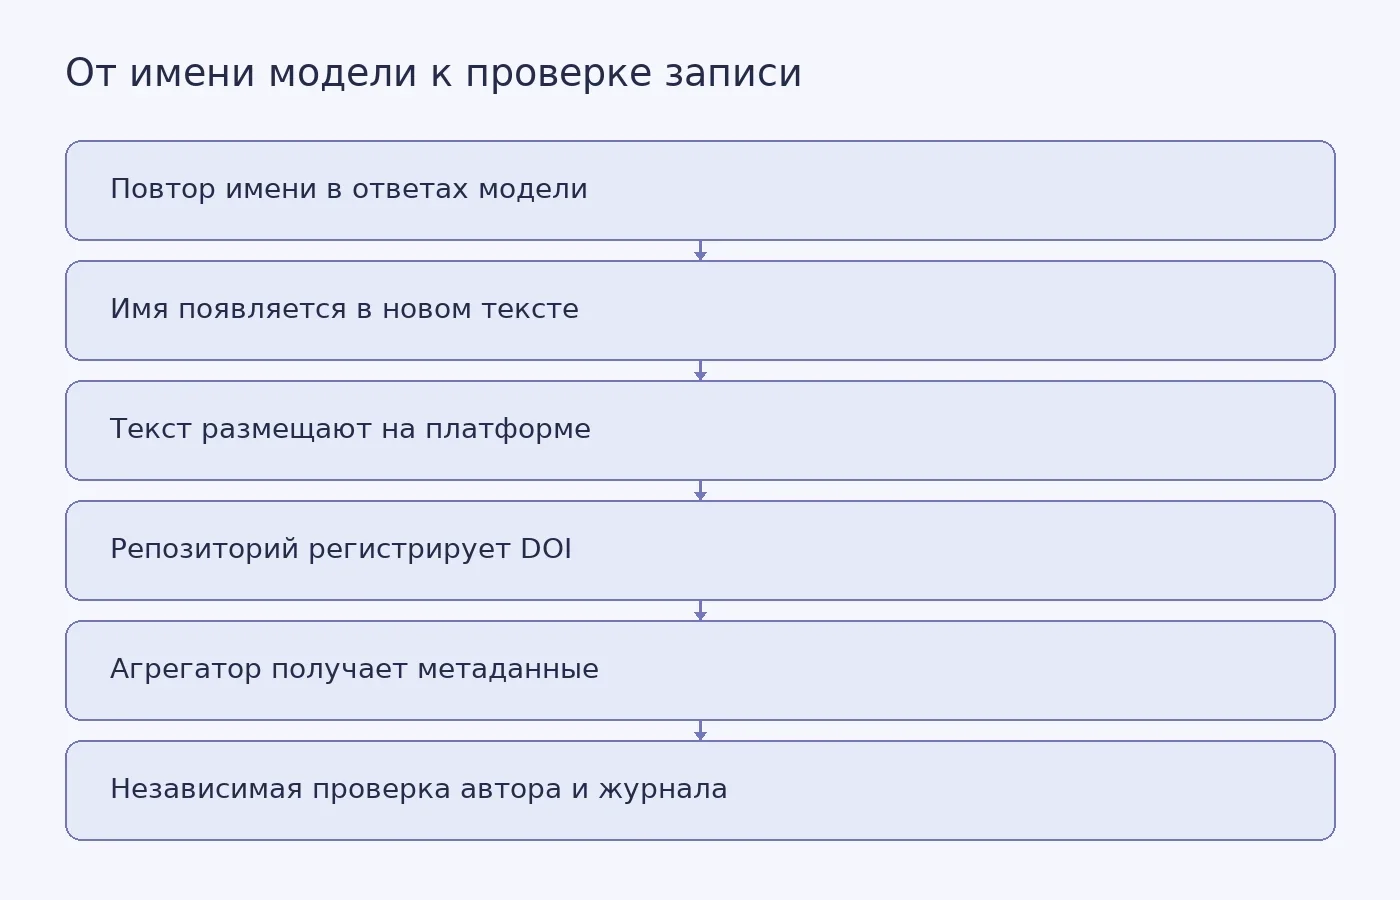
Фото: Pavel Danilyuk / Pexels


Похожие статьи
 Полезные материалы
11
мин
27.02.2026
1
Как защитить научную работу от кражи и плагиата
Проблема цифровой кражи научных работ и присвоения чужих результатов как своих собственных остается острой из-за открытого доступа к огромным информационным массивам. Чтобы избежать этой распространенной проблемы, предлагаем воспользоваться практическими рекомендациями, приведенными в этом материале
 Полезные материалы
7
мин
19.07.2022
21714
Как написать обзорную научную статью?
Научная обзорная статья – это документ, знакомящий читателя с результатами проведенных экспериментов, дискуссиями, идеями по нескольким направлениям выбранного объекта исследования. Оформляется в сжатой, лаконичной форме без употребления нагроможденных словесных конструкций. Зачем нужна об
 Полезные материалы
11
мин
27.02.2026
1
Как студенту завершить работу с источниками в конце года: что делать, если доступ к библиотекам закрывается на праздники
Декабрь – это критически важный месяц для дипломной работы: студенты завершают сбор и систематизацию информационных источников. Перед новогодними праздниками доступ к читальным залам и библиотекам резко сокращается, поэтому получить редкие книги или консультации по подбору литературы сводится
 Полезные материалы
10
мин
10.08.2026
1
Черные и белые схемы написания диссертации: что работает, а от чего лучше воздержаться
В 2026 году использовать «черные схемы» написания диссертации стало намного рискованнее: научные организации, университеты, диссертационные советы внедряют новые инструменты проверки качества текста и академической добросовестности. Если выявляется недостаточная проработка темы, формальн
 Полезные материалы
11
мин
28.12.2022
30372
Структура диплома. Как правильно составить структуру
Структура дипломной работы выстраивается с учетом логики проведенного исследования, разработанного для решения поставленных задач по теме ВКР. Строгая последовательность структурных элементов в дипломе регламентирована требованиями ГОСТ и, в ряде случаев, методическими рекомендациями учебного заве
 Полезные материалы
8
мин
21.05.2025
34692
Цели и задачи дипломной работы. Правильная постановка
Цель и задачи дипломной работы определяют желаемый результат будущего исследования, включая основные этапы его достижения. Формулировки цели, задач выносятся автором в краткой, лаконичной форме во введение выпускной работы. Чем отличаются цели от задач Цель – это характеристик
Последние новости и статьи
 Полезные материалы
8
мин
07.10.2026
Почему декаф-кофе дал неожиданный результат в тестах памяти
В одном из тестов участники, пившие кофе без кофеина, стали допускать меньше ошибок. В группе обычного кофе статистически значимого улучшения не обнаружили. Легко решить, что дело в компонентах напитка, которые сохраняются после удаления кофеина, например в полифенолах. Но наблюдение за результатом
 Полезные материалы
12
мин
07.10.2026
Если сигнал LZ реален, какая частица могла его оставить?
В детекторе LUX-ZEPLIN (LZ) зарегистрировали один необычный кандидат на ядерную отдачу с энергией 248 кэВ. За ним не последовала ожидаемая группа более слабых событий. Для физика это важная деталь: большинство простых моделей тёмной материи должно давать спектр, начинающийся с малых энергий. Здесь ж
 Полезные материалы
8
мин
07.10.2026
Как научить школьников распознавать вводящие в заблуждение графики
Две почти одинаковые колонки на графике могут выглядеть так, будто одна вдвое выше другой. Если вертикальная шкала начинается не с нуля, а, например, с 95%, разница между близкими значениями зрительно увеличивается. Поэтому график важно не только увидеть: нужно прочитать шкалу и сопоставить изображе
 Наука
3
мин
06.10.2026
Ванилин предложили использовать в покрытиях для заживления хронических ран
Исследователи Лаборатории биомедицинской наноинженерии Университета Флиндерса в Австралии рассматривают ванилин как компонент покрытий и других медицинских формуляций для хронических ран. Об этом 6 октября сообщила пресс-служба университета в материале, опубликованном Phys.org. Работа вышла в Intern
 Наука
4
мин
06.10.2026
Антарктическая озоновая дыра выросла до 27,4 млн кв. км — второй результат для сентября
20 сентября 2026 года антарктическая озоновая дыра выросла до 10,6 млн квадратных миль, то есть примерно до 27,4 млн кв. км. Это второй по величине размер для середины сентября за всю историю наблюдений, сообщает Live Science со ссылкой на записи Copernicus Atmosphere Monitoring Service. Крупнее в э
 Наука
3
мин
06.10.2026
Жёсткость ткани яичника сокращает связи между яйцеклеткой и клетками поддержки
Исследователи Национального университета Сингапура показали, как уплотнение ткани яичника может мешать развитию яйцеклетки. В работе, опубликованной 13 августа 2026 года в журнале Aging Cell, фолликулы молодых доклинических моделей выращивали в гидрогелях, имитирующих мягкую и жёсткую ткань. В жёстк