
Содержание статьи
Полезные материалы
02.10.2026
02.10.2026
18
мин
В конце сентября 2026 года в разделе «Сообщество» Naked Science появился пост о том, что «GPT-6 Astra расшифровала письмо наполеоновской эпохи, которое не могли прочесть больше 200 лет». Заголовок обещает больше, чем стоит за материалом, и это не упрёк автору поста — это типичная судьба научной новости, где самое интересное спрятано в оговорке. Оговорка там есть, и она важнее заголовка: «Я потратил шесть часов работы модели и несколько собственных вечеров», — пишет Картер Черч, автор расшифровки. Именно из этого разрыва между «шесть часов модели» и «несколько вечеров человека» вырастает вопрос, который стоит разобрать спокойно: почему расшифровка исторического шифра языковой моделью требует проверки по знакам и как вообще отличить вклад модели от работы исследователя.
Сразу договоримся о статусе. Расшифровка Мармона — не рецензированная научная статья. Это авторский разбор (writeup), опубликованный 18 сентября 2026 года на личном сайте carter.church, плюс пакет решения с транскрипцией, ключом и скриптами проверки. Каталог Cryptiana Сатоси Томокиё — тоже не журнал, а многолетний личный реестр нерешённых исторических шифров, который, впрочем, десятилетиями служит рабочим инструментом для специалистов. Первичная публикация самой пластины со шифром — статья подполковника Ж. Вилькока «Le Chiffre sous le Premier Empire» в Revue historique des Armées, 1969, том 25, № 4, с. 22–27, DOI 10.3406/rharm.1969.8686. Это публикация в научном военно-историческом журнале, и доступен нам только фрагмент (с. 22), а сама пластина в нашем распоряжении — лишь в виде оцифровки на Persée. Так что перед нами не эксперимент и не peer-reviewed результат, а документ с воспроизводимыми артефактами. Это важно, потому что дальше речь пойдёт именно о том, что можно и чего нельзя из такого документа вычитать.
Что вообще было зашифровано
Письмо адресовано генералу Огюсту Мармону, командующему корпусом в Далмации — на дальней стороне Адриатики, отрезанному от остальных французских армий австрийской территорией. Первая строка письма открытым текстом: «Vous avez dû recevoir, Monsieur le Général Marmont, mes lettres des 8, 14 et 20 courant». Дальше — двадцать четыре строки двузначных чисел, отдельных букв и придуманных символов. Ключ не сохранился, и до 2026 года документ числился в Cryptiana как нерешённый, причём с датой 1807 год.
Контекст, который делает письмо осмысленным, лежит в переписке Наполеона. 16 марта 1809 года император писал из Парижа своему пасынку Эжену Богарне, вице-королю Италии, и поручал передать Мармону сведения о расположении всех французских и союзных армий — «dans une lettre chiffrée et par un officier intelligent», шифрованным письмом и через толкового офицера. В том же приказе перечислены семь сил с численностями: баварцы Лефевра (герцога Данцигского) — 40 000 между Мюнхеном и Пассау, поляки Понятовского — 30 000 на Висле, саксонцы Бернадота (принца Понте-Корво) — перед Дрезденом, корпус Даву (герцога Ауэрштедтского) — 80 000 в Байройте, Массена (герцог Риволи) — 60 000 в Ульме и Донаувёрте, Удино — 40 000 в Аугсбурге и на Лехе, и русские, идущие на Австрию. Текст приказа опубликован в Correspondance de Napoléon Ier, том 18, с. 356–358 (Париж, 1865), и доступен на archive.org.
Расшифрованное письмо содержит ту же семёрку сил в той же последовательности и с теми же числами там, где они указаны в приказе: для саксонцев и русских численностей в приказе нет, так что совпадение по числам касается пяти сил из семи. Это и есть главный содержательный аргумент: не «модель угадала связный французский», а «независимо известный документ совпал с расшифровкой по составу и числам». Совпадение по числам — сильнее, чем совпадение по смыслу, потому что числа труднее подогнать под ожидание.
Почему здесь нельзя обойтись частотным анализом
Шифр — гомофонический: частые буквы получают несколько взаимозаменяемых знаков, и распределение частот выравнивается. Черч формулирует это прямо: «It's a homophonic cipher: common letters get several interchangeable signs, so that counting frequencies gets you nowhere». В письме 1 300 единиц шифротекста и 155 различных знаков, из которых 29 обозначают целые слова (de, que, les, vous, général и другие), а два — удвоенную S. Опубликованная таблица историка криптографии Даниэля Танта (Code d'Eugène de Beauharnais, ARCSI, Codes anciens № 373) давала 33 буквенных значения и ни одной заполненной ячейки для слов-знаков. Эти 33 значения покрывают 435 из 1 300 единиц, то есть примерно треть; остальные две трети пришлось выводить из самого письма.
Метод, который для этого применялся, не нов. Имитация отжига со скорингом по n-граммам — стандартный подход к гомофоническим шифрам, описанный, например, у Нильса Копаля в материалах HistoCrypt 2019 и у Дхаваре, Лоу и Стэмпа в Cryptologia (2013). Черч сам это признаёт и ссылается на предшественников. Новизна здесь не в принципе криптоанализа, а в том, что распознавание рукописи, поиск исторических источников и программирование сведены в один рабочий процесс. Это честная формулировка, и её стоит держать в голове, когда читаешь заголовки про «нейросеть, которая взломала шифр».
Что именно делала модель и что делал человек
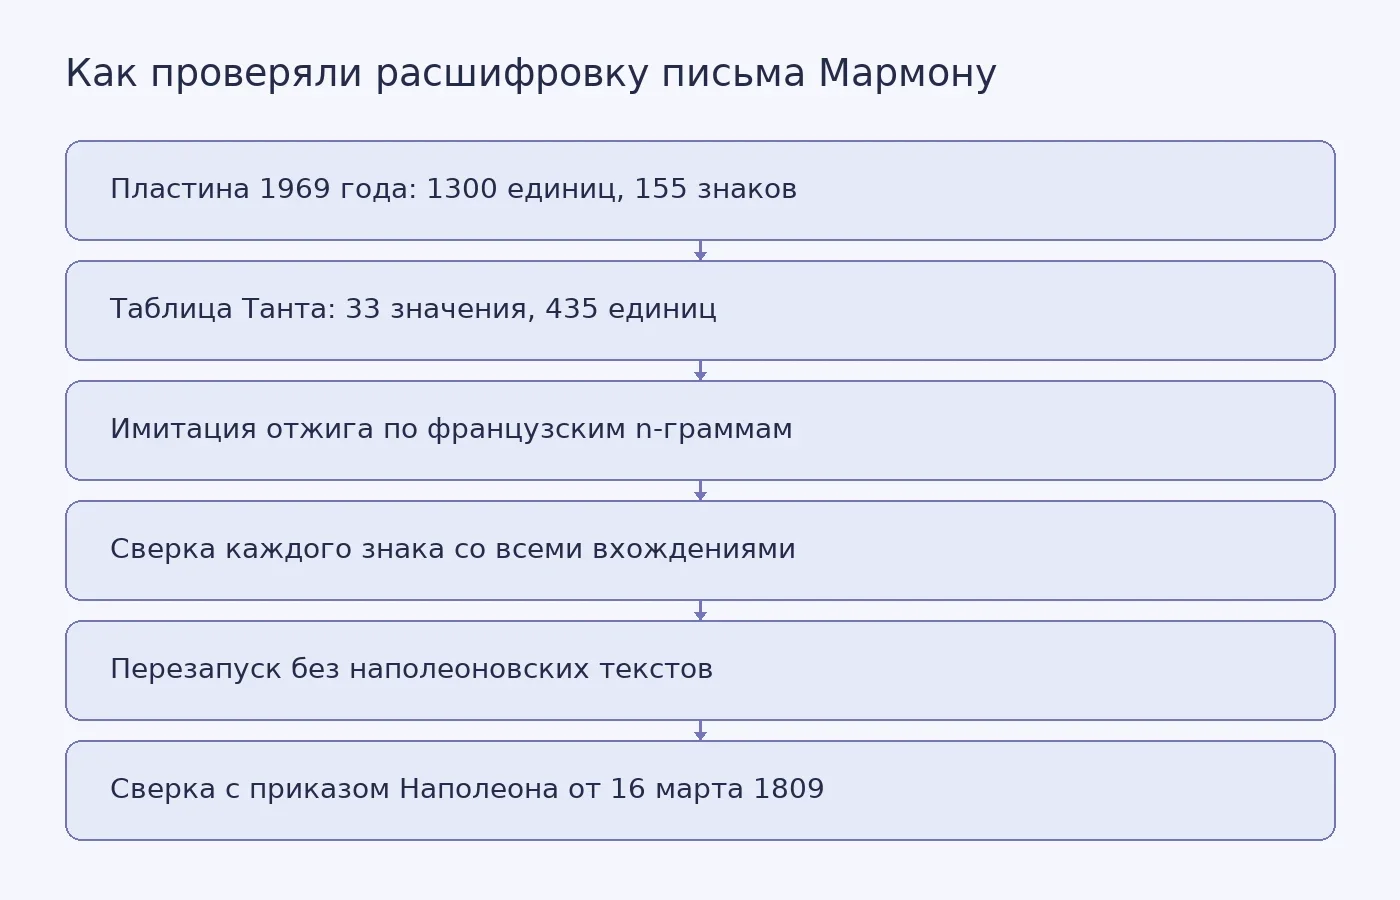
Из описания Черча вырисовывается разделение труда, которое и есть ответ на главный вопрос. Модель разрезала пластину 1 202 × 1 836 пикселей (примерно 19 пикселей на знак) на строки, прочитала знаки, свела 175 предварительных начертаний к 1 320 единицам, а затем запустила решатель. Человек — то есть сам Черч — задал рамку: взял таблицу Танта как данность, выбрал корпус французских текстов для языковой статистики (Гюго, Дюма, мемуары Мармона), решил, какие знаки тестировать как целые слова, и, что важнее всего, проверял каждое предложенное значение обратно по изображению.
Вот ключевая процедура, и её стоит процитировать дословно: «Wherever a sign's proposed value made the French smoother, that proposition was compared with every other occurrence of that sign. The value was kept only if this benefit was realized across all instances». То есть если знак, прочитанный как, скажем, «e», улучшает французский в одном месте, это ещё ничего не значит — значение принимается только тогда, когда оно работает во всех вхождениях знака на изображении. Это и есть «проверка по знакам», о которой спрашивает наш вопрос. Она принципиально отличается от проверки «получился ли связный рассказ»: связный рассказ можно получить и при неверном ключе, если язык модели достаточно силён, чтобы достроить пропуски. Проверка по всем вхождениям знака такой подгонки не допускает — либо знак ведёт себя одинаково везде, либо гипотеза отбрасывается.
Отдельно Черч описывает попытку сломать собственный результат: решатель был перезапущен с нуля, причём из языковой модели убрали мемуары Мармона и все наполеоновские тексты. Результат — то же чтение. Формулировка автора: «It recovered the same reading, so the key does not depend on the model having seen the history it was decoding». Это не идеальный контроль (модель всё равно обучена на огромном корпусе, и полностью исключить знание эпохи нельзя), но это осмысленная проверка на то, не подсказала ли модели историческая начитанность ответ, который она потом «нашла» в шифре.
Где заканчивается уверенность
Черч сам перечисляет пять чтений, которые остаются открытыми, и почти все они касаются знаков, встречающихся ровно один раз. «Sa Majesté» может быть «l'Empereur»; «l'armée du Frioul» может быть «en Frioul»; «des troupes» может быть «les troupes»; один знак, прочитанный как пустой, может быть словом «par»; «canailles» может стоять в единственном числе. Автор считает, что общий смысл от этого не меняется, и с этим можно согласиться — но именно потому, что эти места не несут новой информации, а не потому, что они надёжны.
Есть и более серьёзное ограничение, которое Черч проговаривает честно: письмо Богарне — пересказ распоряжения Наполеона, а не собственноручные слова императора. «The relay is a paraphrase, so this is not proof of Napoleon's exact word. It is the first direct evidence of what the dots were hiding». Речь о знаменитом пропуске в издании 1865 года: фраза обрывается после «par une poignée de . . . . . . . .», и в шифрованном письме соответствующее место читается как «quelques troupes ou un rassemblement de canailles». Это действительно первое прямое свидетельство о том, что скрывалось за многоточием, но это слова штаба Эжена, а не Наполеона. Разница существенная, и её легко потерять в пересказе.
Наконец, материал для чтения — одна пластина из одного журнала 1969 года, оцифрованная в скромном разрешении. Часть знаков опирается на тонкие свидетельства именно потому, что встречается по одному разу. Полный текст статьи Вилькока с таблицами в нашем доступе не подтверждён — доступен только первый фрагмент. Это не отменяет результат, но означает, что независимая проверка чтения по первоисточнику пока ограничена.
Что изменилось в каталоге и что это значит
Сатоси Томокиё внёс письмо в Cryptiana как решённое и исправил дату: «Carter Church notified me of his solution on 20 September 2026 and points out the date should be corrected to 1809». Раньше запись значилась как «Encoded Letter to Marshal Marmont (1807)», и в описании системы говорилось о двузначных числах, буквах и символах. Исправление даты — не мелочь: оно означает, что документ встал в контекст двух недель перед австрийским вторжением в Баварию 10 апреля 1809 года, и содержание письма (расположение австрийцев в Лайбахе, Клагенфурте, Филахе и Зальцбурге, угроза Тиролю через Линц) перестало быть просто списком армий и стало разведсводкой накануне войны.
Томокиё также отмечает в общем уведомлении на своей странице, что решения приходят быстрее, чем он успевает их фиксировать, и что самый плодовитый из новых решателей — Даниэль Бурдо, разобравший за несколько недель более тридцати шифров из его списков, судя по всему, тоже с помощью фундаментальных моделей. Это важный контекст: случай Мармона — не уникальный прорыв, а один из потока похожих результатов, и оценивать его стоит именно так.
Как отличить вклад модели от работы исследователя
Вернёмся к исходному вопросу. Разделение здесь не «модель сделала всё» и не «человек сделал всё». Модель выполнила ту часть, которая раньше требовала недель специалиста: прочитать 1 300 рукописных знаков с низкокачественной оцифровки, свести варианты начертаний, перебрать ключи имитацией отжига, оценить кандидатов по языковой статистике. Человек выполнил ту часть, которая делает результат проверяемым: выбрал, что считать данным (таблица Танта), что считать гипотезой, потребовал сверки каждого значения со всеми вхождениями знака на изображении, организовал перезапуск без наполеоновских текстов и опубликовал транскрипцию, ключ и скрипты. Без второй части первая осталась бы связным французским текстом неизвестного происхождения.
Именно поэтому «проверка по знакам» — не бюрократическая формальность, а то, что превращает правдоподобное чтение в проверяемое. Языковая модель по определению хороша в том, чтобы достраивать пропуски до осмысленного текста; это её сила и одновременно источник риска при работе с шифрами. Сверка по всем вхождениям знака — процедура, которая этот риск ограничивает, потому что не даёт подгонять отдельные места под красивый рассказ. Если бы Черч ограничился демонстрацией гладкого французского текста, у нас не было бы никаких оснований отличать расшифровку от правдоподобной реконструкции.
Опубликованный пакет решения (Marmont_Solution_v1.0.0.zip, SHA-256 a5292f07…e9f750) содержит key.tsv с ключом на 155 знаков, revised_tokens.txt с транскрипцией на 24 строки и 1 300 единиц, symbol_ledger.tsv, unit_classification.tsv и скрипты verify.py и reproduce.py, которые проверяют файлы друг против друга и заново порождают чтение офлайн. Это и есть та часть, по которой сторонний человек может судить о результате, не доверяя ни модели, ни автору на слово. Для исторического шифра это довольно редкий уровень открытости — большинство старых расшифровок публиковались как готовый текст без ключа.
Наша интерпретация
Заголовок «нейросеть сама справилась за шесть часов» противоречит собственному уточнению автора о нескольких вечерах личной работы, и это противоречие стоит держать в голове, а не сглаживать. Шесть часов — это время выполнения задач моделью, а не время, за которое появился результат. Разница принципиальна: она показывает, что ценность здесь не в скорости модели как таковой, а в том, что модель сняла барьер входа. Черч сам пишет об этом прямо: «A patient specialist could have done this in 1970. But it would have meant weeks of a specialist's time». Материалы были доступны — таблица Танта, переписка Наполеона с 1860-х, мемуары Мармона на Project Gutenberg. Не хватало не данных, а человека, который мог бы оправдать недели работы над одной пластиной из одного журнала.
Отсюда и осторожный вывод о том, что здесь нового. Нового принципа криптоанализа нет — имитация отжига для гомофонических шифров описана задолго до GPT-6. Новое — в снижении стоимости внимания: то, что раньше не стоило делать, теперь делается за несколько вечеров, и таких «нерешённых» документов в архивах, судя по потоку решений в Cryptiana, гораздо больше, чем принято думать. Это не отменяет необходимости проверки по знакам и не превращает авторский разбор в рецензированную работу. Но это меняет то, какие вопросы имеет смысл задавать: не «справилась ли модель», а «что именно она сделала и что осталось на долю человека, который отвечает за результат».
Для письма Мармона ответ такой: модель прочитала и перебрала, человек выбрал рамку, потребовал сверки и опубликовал артефакты. Результат — рабочее чтение с пятью открытыми местами, исправленной датой и первым прямым свидетельством о том, что скрывалось за многоточием в издании 1865 года. Это меньше, чем обещает заголовок, и больше, чем можно было ожидать от одного вечера работы с одной оцифровкой.
Ссылки и материалы: пост в разделе «Сообщество» Naked Science (naked-science.ru/community/1219605); разбор Картера Черча и пакет решения (carter.church/writeups/the-letter-to-marmont/); запись в Cryptiana Сатоси Томокиё (cryptiana.web.fc2.com/code/unsolved.htm); статья Ж. Вилькока, Revue historique des Armées 25(4), 1969, с. 22–27, DOI 10.3406/rharm.1969.8686 (persee.fr); Correspondance de Napoléon Ier, т. 18, с. 356–358 (Париж, 1865), archive.org; N. Kopal, «Cryptanalysis of Homophonic Substitution Ciphers Using Simulated Annealing with Fixed Temperature», HistoCrypt 2019; A. Dhavare, R. M. Low, M. Stamp, «Efficient Cryptanalysis of Homophonic Substitution Ciphers», Cryptologia 37(3), 2013, с. 250–281; Daniel Tant, «Code d'Eugène de Beauharnais», ARCSI, Codes anciens № 373.
Источники и литература
- GPT-6 Astra расшифровала письмо наполеоновской эпохи, которое не могли прочесть больше 200 лет — авторское мнение; доступный текст страницы
- Breaking the Marmont Cipher, 1809 - Carter Church — первичный документ; доступный текст страницы
- Unsolved Historical Ciphers — первичный документ; доступный текст страницы
- https://carter.church/writeups/the-letter-to-marmont/Marmont_Solution_v1.0.0.zip — тип публикации не установлен; доступный текст страницы
- Le Chiffre sous premier Empire - Persée — рецензируемая публикация; доступный текст страницы


Похожие статьи
 Полезные материалы
21
мин
05.04.2023
47092
Как оформить дипломную работу? Требования к оформлению
Правила оформления дипломной работы регламентируются требованиями ГОСТа и методическими рекомендациями конкретного учебного заведения. 9 основных требований к оформлению дипломной работы по ГОСТу Текст диплома оформляется только с одной стороны листа формата А4. При наборе, исполь
 Полезные материалы
31
мин
28.12.2022
44334
Особенности и методика оформления курсовой работы. Оформляем курсач правильно
Правильное оформление курсовой по ГОСТу повышает шансы студента на получение высокого балла за проделанное исследование. Кроме строгого соблюдения требований ГОСТ, автору курсовой работы следует обязательно учитывать и методические рекомендации по оформлению курсовых, составленных вузом.
 Полезные материалы
11
мин
27.02.2026
1
Как студенту законно и грамотно использовать ИИ-инструменты при подготовке диплома
С развитием информационных технологий искусственный интеллект все чаще используется при подготовке дипломных работ. Такой инструмент позволяет ускорить поиск информации, улучшить процесс структурирования материалов и повысить качество анализа. Требования к академической честности и цифровой грамо
 Полезные материалы
3
мин
12.01.2023
10971
Отчисление из аспирантуры, что делать после отчисления?
Отчисление из аспирантуры по собственному желанию – это возможность сделать перерыв в обучении и спокойно принять решение о целесообразности получения научного образования по выбранной специальности. Особенности отчисления из аспирантуры по собственному желанию Чтобы аспиранта отчислили
 Полезные материалы
18
мин
01.10.2026
Что на самом деле измеряют бенчмарки ИИ: конвергентная и дискриминантная валидность против посторонних навыков
Вопрос о том, измеряет ли бенчмарк предвзятость и безопасность модели или посторонний навык вроде понимания текста, в 2026 году перестал быть риторическим. Две работы переносят в оценку ИИ аппарат психометрики — науки об измерении человеческих способностей, — и показывают, что часть популярных тесто
 Полезные материалы
10
мин
27.02.2026
1
Как выбрать журнал (Scopus, Web of Science, ВАК) и не попасть на хищнические журналы
Публикация в авторитетных изданиях – это возможность заявить об академической ценности исследования, обеспечить корректную цитируемость, индексируемость и возможность расширить круг знакомств среди авторитетных ученых. Хищнические журналы представляют большие риски для исследователей. Такие
Последние новости и статьи
 Вопросы студентов
9
мин
03.10.2026
Изменения ЕГЭ-2027: что уже опубликовано ФИПИ и чем это отличается от 2026 года
К началу октября 2026 года на сайте ФИПИ лежат два набора документов, и их легко перепутать. Один описывает экзамен, который уже прошёл общественное обсуждение и утверждён, — это КИМ ЕГЭ 2026 года. Второй только предложен к обсуждению: это проекты документов, определяющих структуру и содержание КИМ
 Наука
3
мин
02.10.2026
В Салиш-Си описали два новых вида морских пауков
Исследователи из Университета Британской Колумбии описали два ранее неизвестных вида морских пауков, или пикногонид, в экорегионе Салиш-Си у западного побережья Канады. Статья вышла 26 августа 2026 года в журнале Organisms Diversity & Evolution. Научно-популярный журнал Nautilus назвал находку п
 ИИ в образовании
5
мин
02.10.2026
Немецкие учёные научили ИИ переносить прогноз времени удерживания между хроматографами
Исследователи Университета Фридриха Шиллера в Йене, Центра Гельмгольца в Мюнхене и Технического университета Мюнхена создали модель 2-step, которая предсказывает время выхода малых молекул из хроматографической колонки на новой измерительной системе. Статья вышла 1 октября 2026 года в Nature Methods
 Наука
3
мин
02.10.2026
Зимнее усиление грибковой инфекции изменило выпуск йосемитских жаб в природу
Исследователи Калифорнийского университета в Лос-Анджелесе и национального парка Йосемити обнаружили, что инфекция грибком Batrachochytrium dendrobatidis (Bd) сильнее всего нарастает у йосемитских жаб во время зимовки в подземных норах. О результате UCLA сообщила 1 октября 2026 года в материале, опу
 Полезные материалы
12
мин
02.10.2026
Почему специализация опылителей зависит от климата, а не только от широты
Представим условный цветущий сад. На одном растении кормятся пчела, муха и бабочка, а соседний цветок посещает только один вид насекомых. Кажется, что одни опылители разборчивы, а другие берут любой доступный ресурс. Но в экологическом исследовании одного наблюдения недостаточно. Нужно знать, какие
 Полезные материалы
11
мин
02.10.2026
Повседневные практики безопасности в классе при продолжающемся стрессе: что предлагают источники и чего они не доказывают
Вопрос, который здесь разбирается, звучит так: какие повседневные действия учителя поддерживают у детей ощущение безопасности при продолжающемся стрессе — и где проходит граница, за которой педагог начинает подменять психологическую помощь? Короткий ответ по доступным материалам: источники предлагаю