


Содержание статьи
Дипломы
29.10.2026
29.10.2026
7
мин
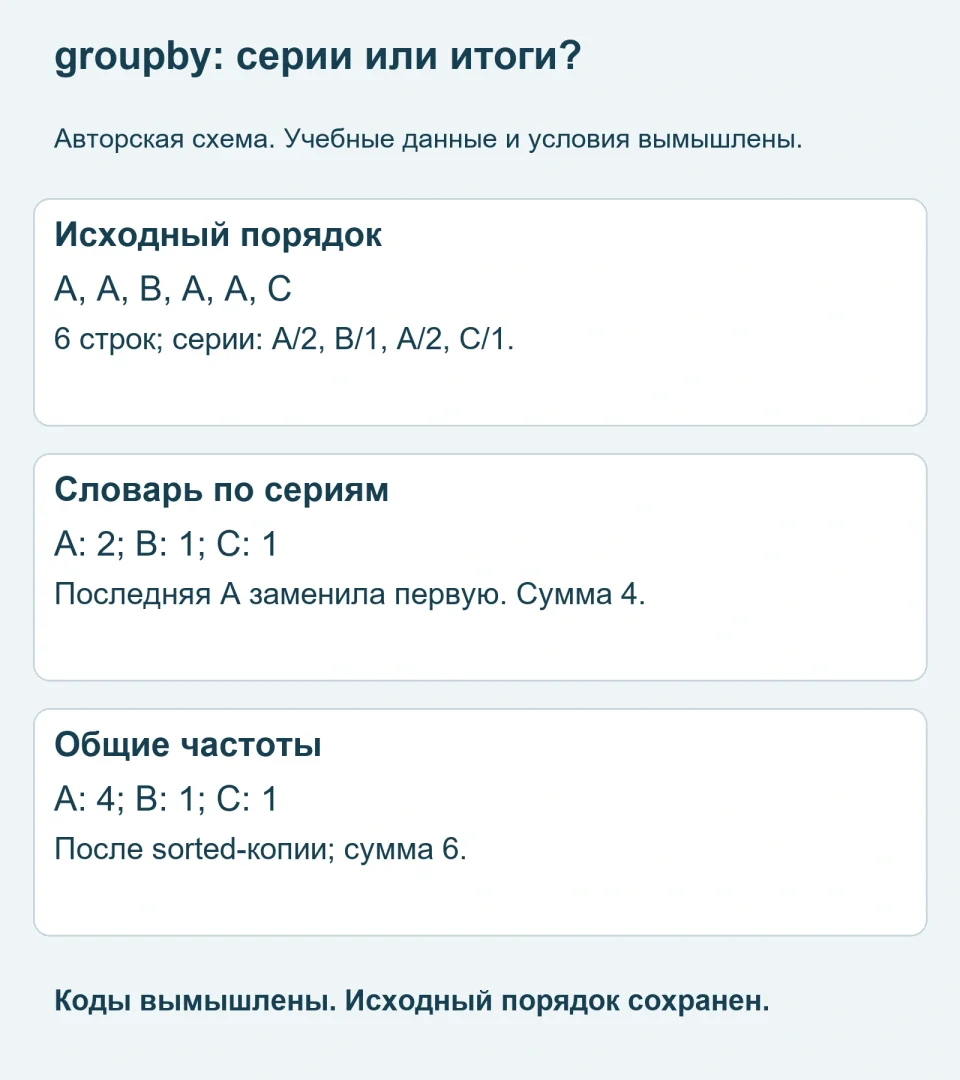
В учебной последовательности шесть строк: A, A, B, A, A, C. Если превратить размеры соседних серий в словарь с ключом-кодом, сумма его значений окажется равна четырём: ранняя серия A будет заменена поздней. Строки не исчезли из исходного файла: ошибочным оказался переход от соседних серий к общим частотам. Разберём, что возвращает itertools.groupby и как проверить, на какой вопрос отвечает результат.
Буквы ниже обозначают вымышленные коды категорий, а не идентификаторы реальных участников. Код выполнен в Python 3.12.14 без внешних пакетов; использована официальная документация ветви 3.12. Считаем строки по категориям, не число уникальных людей и не число независимых наблюдений.
Соседняя серия и общая частота — разные задачи
Согласно документации itertools.groupby, новая группа начинается при изменении ключа. Функция не собирает автоматически все одинаковые коды из разных мест последовательности. В нашем порядке две пары A разделены строкой B, поэтому получатся две отдельные серии A.
| Строка исходного файла | Код категории |
|---|---|
| r1 | A |
| r2 | A |
| r3 | B |
| r4 | A |
| r5 | A |
| r6 | C |
Для исследования последовательности такой результат полезен: видны длины непрерывных серий. Если требуется общее количество строк каждой категории, нужно другое представление. Нельзя называть две серии A двумя разными категориями только потому, что они расположены отдельно.
Полный пример: четыре серии, но три категории
runs хранит списки строк каждой серии, run_sizes хранит их длины. last_run_only намеренно показывает ошибочное сворачивание серий в словарь, а totals даёт общий подсчёт после сортировки копии. Исходный список codes сохраняет прежний порядок.
from itertools import groupby

codes = ["A", "A", "B", "A", "A", "C"]
runs = [(key, list(group)) for key, group in groupby(codes)]
run_sizes = [(key, len(group)) for key, group in runs]
last_run_only = {key: len(group) for key, group in runs}
totals = {key: len(list(group)) for key, group in groupby(sorted(codes))}
print("runs =", run_sizes)
print("last_run_only =", last_run_only)
print("sum_last_run_only =", sum(last_run_only.values()))
print("totals =", totals)
print("sum_totals =", sum(totals.values()))
print("original =", codes)
assert run_sizes == [("A", 2), ("B", 1), ("A", 2), ("C", 1)]
assert last_run_only == {"A": 2, "B": 1, "C": 1}
assert sum(last_run_only.values()) == 4
assert totals == {"A": 4, "B": 1, "C": 1}
assert sum(totals.values()) == len(codes) == 6
assert codes == ["A", "A", "B", "A", "A", "C"]
runs = [('A', 2), ('B', 1), ('A', 2), ('C', 1)]
last_run_only = {'A': 2, 'B': 1, 'C': 1}
sum_last_run_only = 4
totals = {'A': 4, 'B': 1, 'C': 1}
sum_totals = 6
original = ['A', 'A', 'B', 'A', 'A', 'C']Получены серии A/2, B/1, A/2, C/1. В словаре last_run_only повторный ключ A получает значение последней серии: 2, а не сумму 4. Это свойство словаря Python, а не автоматическое суммирование groupby. Поэтому сумма значений ошибочного словаря равна 2 + 1 + 1 = 4 при шести исходных строках.
После sorted(codes) одинаковые коды стоят рядом. В totals получаем A: 4, B: 1, C: 1; сумма равна 6. Здесь сортируется новый список, а не сам codes. Проверки assert сверяют обе промежуточные структуры и итог, а не только число в последней строке.
Когда сортировка поможет, а когда изменит смысл
| Вопрос читателя | Подход к этому примеру |
|---|---|
| Каковы длины серий в порядке файла? | Сохранить исходный порядок и немедленно материализовать каждую группу. |
| Сколько всего строк каждой категории? | Для показанных строковых кодов сгруппировать отсортированную копию по тому же ключу. |
| Нужно ли удалить повторные строки? | Эта программа не отвечает на вопрос о дубликатах и ничего не удаляет. |
Если порядок отражает время или последовательность событий, сортировка по категории уничтожает информацию о расположении серий в этой рабочей копии. Не подменяйте один вопрос другим. Для сложных записей явно задайте одну и ту же функцию ключа при сортировке и группировке; возможность сортировки и смысл ключа нужно проверить для своих типов данных.
Группа, которую возвращает groupby, сама является итератором и разделяет источник с внешним итератором. Если значения нужны позже, сохраните list(group) во время обхода, как в примере. Простое сохранение списка пар из ключа и итератора без чтения групп не равнозначно сохранению всех элементов: продвижение внешнего итератора влияет на доступность предыдущей группы.
Проверка перед переносом в свою работу
- Сформулируйте задачу: соседние серии или общие частоты; укажите единицу подсчёта.
- Сохраните исходный порядок отдельно и зафиксируйте, какую копию сортировали.
- Сверьте сумму частот с числом включённых строк и проверьте повторные ключи при создании словаря.
- При подсчёте по записям определите ключ до запуска. Пропуски, неодинаковые типы и конфликтные значения требуют отдельной проверки.
Шесть кодов достаточны для демонстрации поведения программы, но не для вывода о реальных группах. Этот фрагмент не читает CSV, не проверяет схему файла и не различает копию записи и повторный визит. Отдельно разобрано, как отличить дубликат от повторного наблюдения: там нужен смысл ключей, а здесь проверяется операция группировки последовательности.
Если после проверки структуры нужна консультация по обработке своего набора, можно обсудить помощь со статистическим анализом. Подготовьте исходный файл, описание категорий и точный вопрос: одинаковые счетчики сами по себе не подтверждают корректность исследовательского вывода.


Похожие статьи
 Дипломы
19
мин
01.10.2026
Презентация к диплому: структура слайдов и пример презентации ВКР
Презентация к диплому должна быстро показать комиссии логику ВКР: какую проблему вы изучали, как работали с данными или проектом, что получили и в чем практический смысл результата. Это не сокращенная копия текста дипломной работы и не набор декоративных слайдов. Ниже приведена рабочая структура пре
 Дипломы
11
мин
14.10.2026
Не допустили к защите ВКР: причины, что делать и можно ли защититься позже
В личном кабинете появилась отметка «не допущен», а защита уже близко. Прежде чем срочно переписывать диплом или искать дату пересдачи, выясните, что именно произошло: вас не допустили к защите, вы не явились на нее или комиссия поставила неудовлетворительную оценку. Это разные ситуации, и последств
 Дипломы
13
мин
29.10.2026
25470
Рассчитываем средний бал аттестата, диплома
Средний балл при простом арифметическом расчете - сумма выбранных числовых оценок, разделенная на их количество. Главный вопрос возникает до сложения: какие именно оценки нужны для вашей задачи? Среднее по текущим работам, итоговая отметка предмета и среднее по документу об образовании - разные резу
 Дипломы
14
мин
14.10.2026
Степень разработанности темы диплома: как написать обзор исследований
«Теме посвящены работы многих отечественных и зарубежных авторов», — говорится в черновике. Дальше идут фамилии и пересказы публикаций. Но читателю по-прежнему неясно: что исследователи уже выяснили, в чем их выводы расходятся и какой вопрос остается для диплома.Степень разработанности темы показыва
 Дипломы
18
мин
29.10.2026
50433
Защита дипломной работы. Сроки. Как проходит
Защита дипломной работы начинается не с выхода к экрану, а с проверки допуска, графика и правил своей программы. Дата защиты, срок загрузки текста и время доклада — разные контрольные точки. Если перепутать их, хорошо подготовленное выступление не устранит пропущенный срок представления ВКР. Ниже —
 Дипломы
8
мин
27.10.2026
Одинаковый ID в таблице: как отличить дубликат от повторного наблюдения
Вы открываете файл с данными и видите, что у одного и того же идентификатора несколько раз записаны баллы. Первая мысль: «Ошибка выгрузки, нужно удалить повторы». Но не все совпадения значений — это технические дубликаты. Часть может оказаться повторными визитами одного участника, а часть — конфликт
Последние новости и статьи
 Помощь по написанию
7
мин
29.10.2026
zip в Python: как заметить список, который оказался короче
Три идентификатора и два значения иногда дают две аккуратные пары, и Python молчит. Если вы ждали три пары, результат нельзя сразу пускать в расчёт. Важно понять, где останавливается zip, что проверяет strict=True и почему равная длина ещё не доказывает, что записи соответствуют друг другу. Пример у
 Студенческая жизнь
2
мин
29.10.2026
Команда ПетрГУ выиграла отборочный тур олимпиады по онкологии и ядерной медицине
Отборочный тур Международной олимпиады по онкологии и ядерной медицине по Северо-Западному федеральному округу прошёл в Первом Санкт-Петербургском государственном медицинском университете имени академика И. П. Павлова. Первое место заняла команда Петрозаводского государственного университета «Метаст
 Диссертации по темам
6
мин
29.10.2026
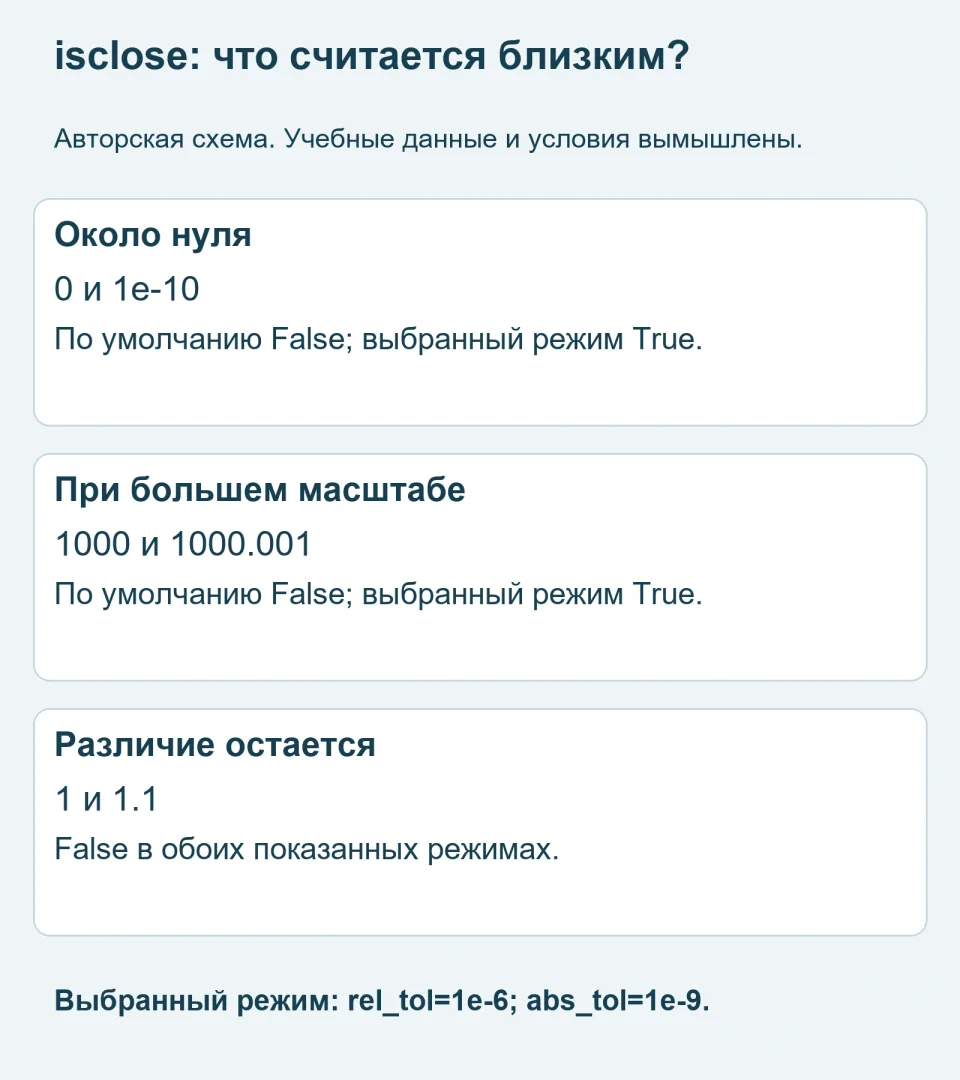
math.isclose около нуля: зачем задавать абсолютный допуск
Два очень маленьких числа кажутся одинаковыми для задачи, но math.isclose возвращает False. Обычно дело не в том, что Python «сломался», а в том, какой допуск указан в вызове. На трех учебных парах разберем разницу между относительным и абсолютным допуском и проверим, почему сравнение с нулем требуе
 Наука
6
мин
29.10.2026
Биологи проследили судьбу более миллиона клеток и составили карту развития эмбриона мыши
Группа Джонатана Вайсмана в Whitehead Institute и Массачусетском технологическом институте (MIT) восстановила родословные более миллиона клеток развивающегося эмбриона мыши и соединила их с данными о работавших в этих клетках генах и их положении в зародыше. Статья вышла 8 октября 2026 года в журнал
 Наука
2
мин
29.10.2026
Люди в паре придумали более разнообразные идеи, чем участники с ChatGPT
28 октября 2026 года Tech Xplore перепечатал материал The Conversation об эксперименте исследователей креативности Клина Лая и Роджера Бити. 208 участников случайно распределили для работы над заданием либо с живым партнёром, либо с ChatGPT. Пары людей предложили более творческие идеи, а ответы учас
 Полезные материалы
13
мин
29.10.2026
22697
Перечень рецензируемых научных журналов ВАК
Перечень ВАК помогает проверить, подходит ли научное издание для публикации результатов диссертации. Одного знакомого названия недостаточно: сопоставляют ISSN, научную специальность, отрасль науки и даты в официальных документах. Категорию журнала и требования к своему виду диссертации проверяют отд