


Содержание статьи
Сколько электричества потребляют гипермасштабные дата-центры США и что это говорит о выбросах ИИ
Защита работ
17.11.2026
17.11.2026
6
мин
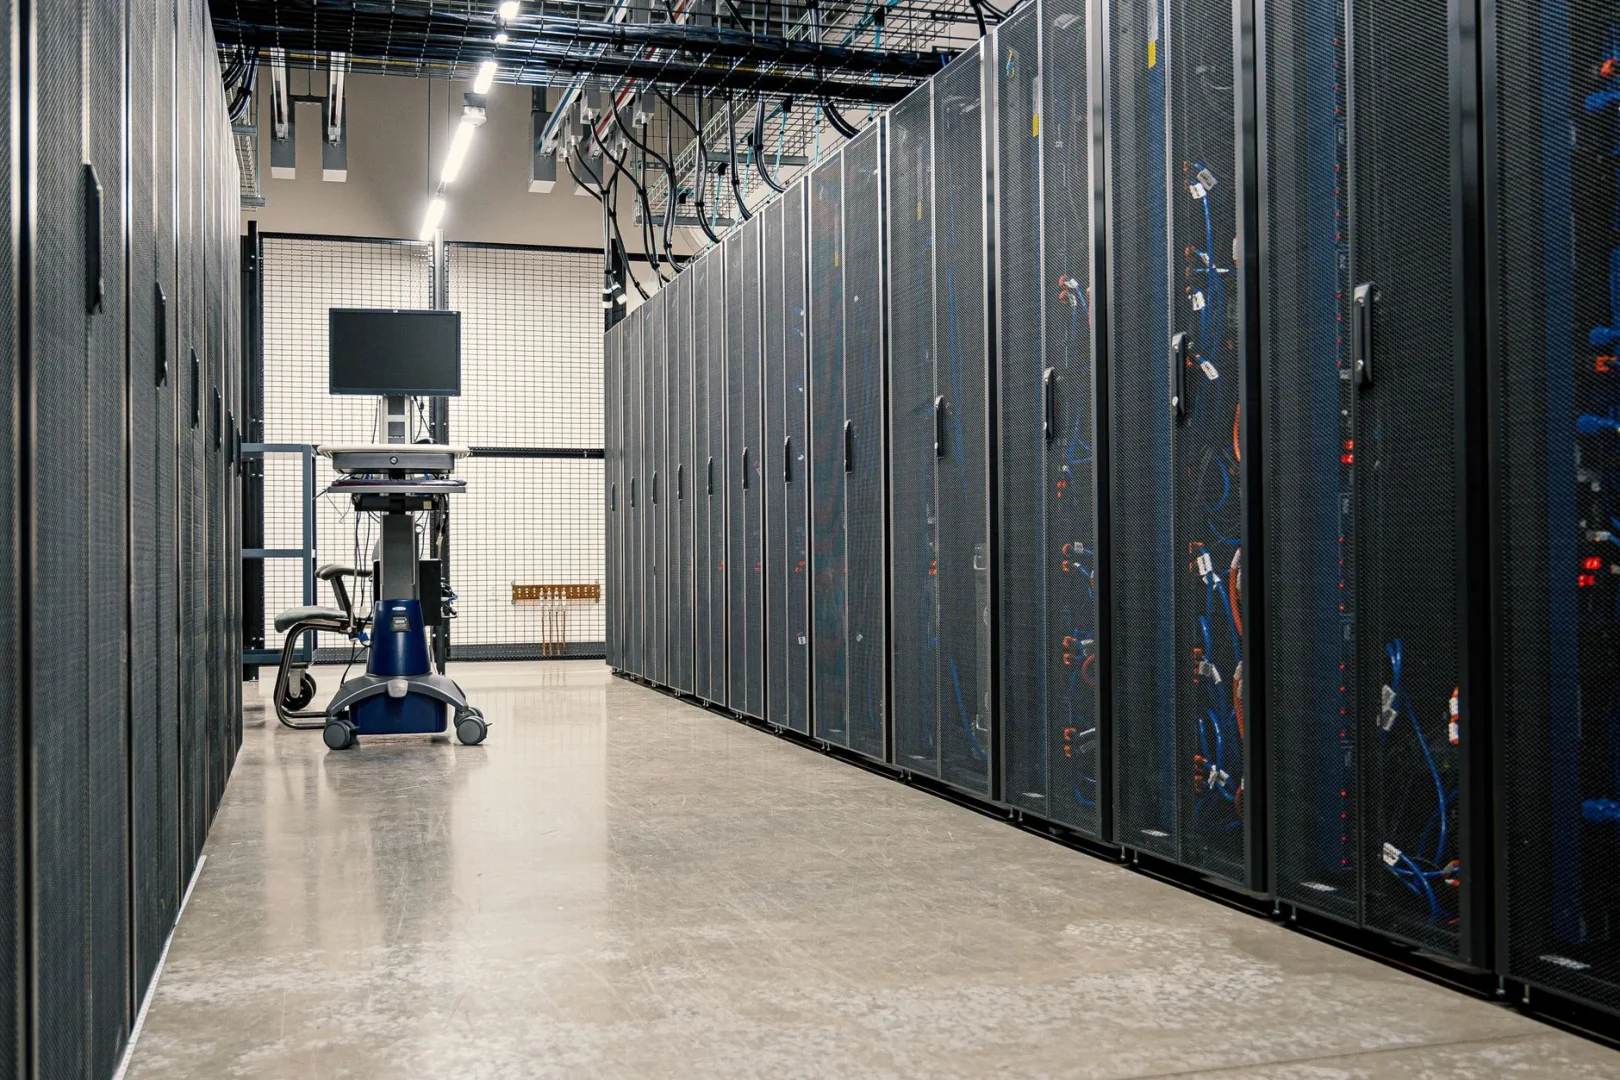
Один и тот же серверный зал может обучать модели искусственного интеллекта, хранить данные и поддерживать привычные цифровые сервисы. Электросчётчик показывает общий расход, но не распределяет его между задачами. Поэтому даже крупная оценка энергопотребления дата-центров сама по себе не говорит, каков углеродный след именно ИИ.
Эта граница заметна в новой статье в журнале Nature Sustainability. Джанлука Гуиди, Франческа Доминичи, Тициано Скуартини и их соавторы оценили потребление 403 гипермасштабных дата-центров в США за год, с мая 2024-го по апрель 2025-го. Статью приняли 13 октября и опубликовали 16 ноября 2026 года; она прошла рецензирование. Полный текст доступен по подписке, а на сайте издателя открыты аннотация, дополнительные материалы и сведения о данных.
Что именно посчитали
Авторы собрали сведения о дата-центрах и рассчитали их энергопотребление для нескольких сценариев загрузки. Затем они связали предполагаемый расход электричества с выбросами энергетики в соответствующих регионах. В аннотации метод назван атрибуцией по местоположению: расчёт опирается на общий объём выработки в региональных органах балансировки энергосистемы.
Годовая оценка зависит от сценария загрузки: потребление составляет примерно 68–99 ТВт·ч, а связанные с ним выбросы оцениваются в 21–31 млн метрических тонн CO₂. Центральный сценарий даёт около 82 ТВт·ч и 25,7 млн тонн. По расчёту авторов, это около 1,8% потребления электричества в США за тот же период. Примерно 54% выработки, приписанной этим дата-центрам, пришлось на ископаемое топливо.
Здесь важно слово «приписанной». Метод распределяет выбросы существующей региональной выработки между потребителями электричества. Он не измеряет, насколько сами дата-центры увеличили выбросы, и тем более не показывает, какая их доля связана с ИИ.
Почему загрузка меняет результат
В открытом репозитории исследования приведены четыре сценария. При низкой загрузке расчёт даёт 67,7 ТВт·ч и 21,3 млн тонн CO₂. В центральном сценарии это 81,8 ТВт·ч и 25,7 млн тонн, а при более высокой загрузке — 98,6 ТВт·ч и 31,0 млн тонн. Это не результаты прямых измерений при разной нагрузке: авторы получили их, меняя предположения о том, насколько используются мощности центров.
Такой расчёт полезен, когда фактические показания каждого центра недоступны, но неопределённость загрузки переходит в итоговую оценку. Репозиторий содержит код и агрегированные результаты, однако исходные сведения по отдельным объектам закрыты соглашением об использовании: они включают коммерчески чувствительные данные, адреса и координаты. Внешние исследователи могут проверить сводные числа и код, но без разрешённого доступа не смогут полностью повторить анализ для каждого центра.
По пересказу Ars Technica, первоначальный список включал 675 объектов, а в итоговый анализ вошли 403. Исключили центры, для которых не была опубликована мощность или чьи характеристики не удалось достаточно надёжно подтвердить. Открытая аннотация издателя подробно не описывает этот отбор, поэтому здесь сведения основаны на журналистском материале, а не на полном тексте статьи.
Почему эти цифры нельзя назвать выбросами ИИ
В исследовании дата-центры рассматриваются целиком: авторы не разделяют вычисления ИИ и другие цифровые услуги. Ars Technica прямо сообщает, что исследователи не смогли отделить нагрузку ИИ от традиционных сервисов. Поэтому даже верхняя граница оценки не означает выбросы искусственного интеллекта. Она относится к выбранным гипермасштабным центрам, какими бы задачами те ни занимались.
Эти числа всё же показывают масштаб энергопотребления крупных дата-центров и выбросы, связанные с выработкой электричества для них. Чтобы ответить на вопрос о выбросах самого ИИ, нужны данные о том, какие вычисления выполняются, сколько энергии они фактически потребляют и откуда поступает электричество. В опубликованных итогах такого разделения нет.
Есть и ещё одна граница расчёта: собственные электростанции на территории дата-центров не входят в описанную в статье сетевую атрибуцию. Ars Technica отмечает, что собственная генерация может становиться заметнее. Поэтому при сравнении будущих оценок стоит проверять, включают ли они такие установки.
Практический вывод прост: цифры исследования позволяют обсуждать энергопотребление гипермасштабных дата-центров и связанные с ним выбросы, но не дают отдельного углеродного баланса ИИ. Чтобы не смешивать оценку и причинный вывод, полезно различать подходы к оценке выбросов и климатических обратных связей: атрибуция показывает, как учтены выбросы, а причинный анализ требует сравнения с обоснованным сценарием без рассматриваемой нагрузки.
Источники
- Guidi, G. et al. Assessing the carbon emissions and energy consumption of US hyperscale data centres. Nature Sustainability, опубликована 16 ноября 2026 года. Рецензированная статья; полный текст по подписке.
- Guidi, G. et al. Код и материалы воспроизводимости, версия v0.3.1-round3-final. Открытый репозиторий с кодом и агрегированными результатами; данные по отдельным объектам ограничены соглашением об использовании.
- Johnson, S. K. Hyperscale data centers use 2% of US electricity. Ars Technica, 16 ноября 2026 года. Журналистский пересказ, использованный для деталей об отборе объектов и невозможности выделить нагрузку ИИ.
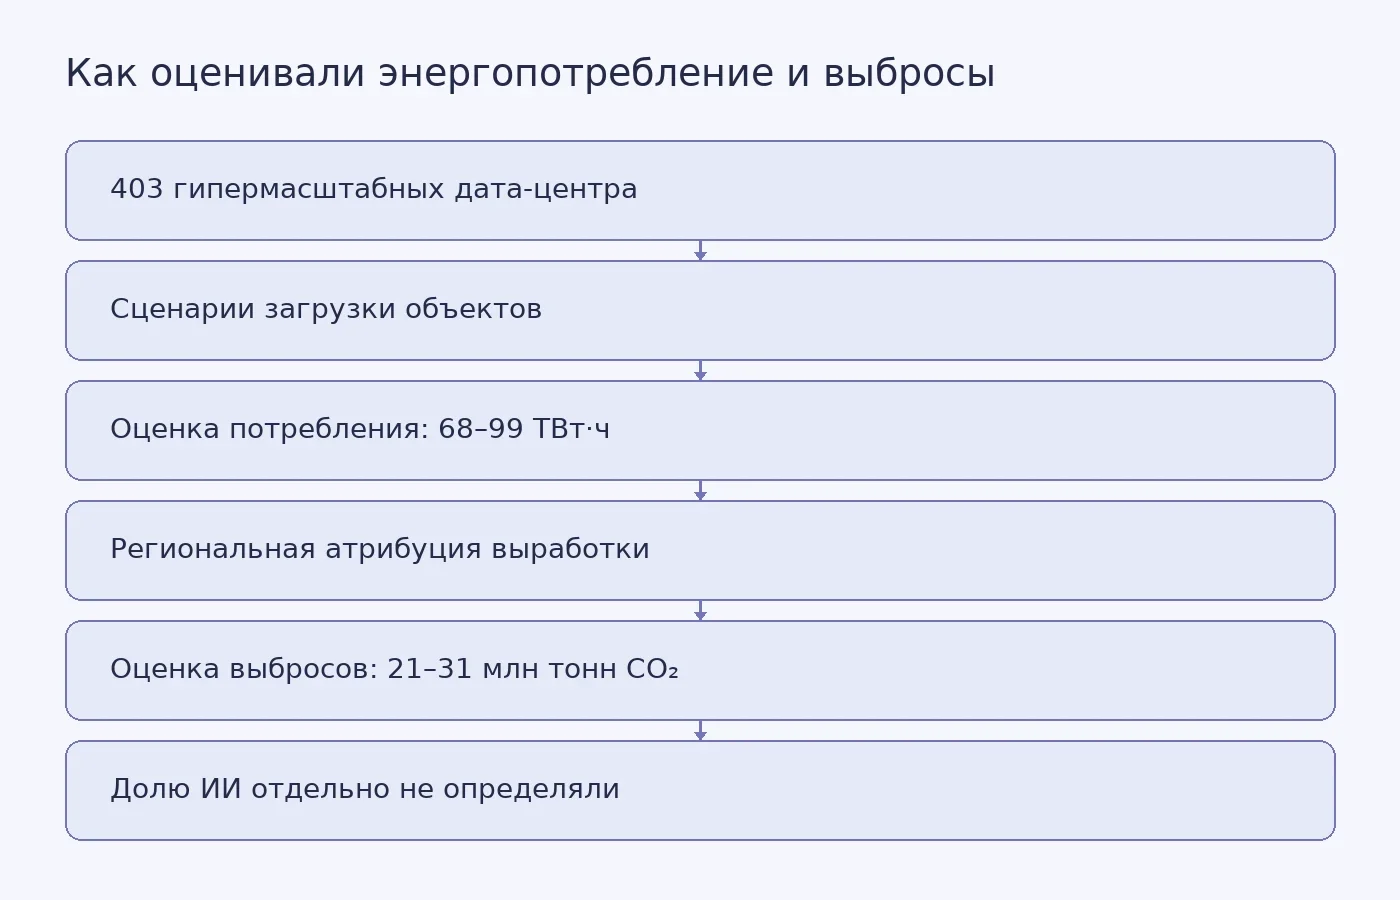
Фото: Brett Sayles / Pexels


Похожие статьи
 Защита работ
5
мин
12.01.2023
10222
Что делать после защиты диссертации?
Успешная защита диссертации – это возможность продолжить исследования в выбранной сфере деятельности, продвинуться по карьерной лестнице и получить выгодную прибавку к заработной плате. Что делать после успешной защиты диссертации После защиты научной работы, документ проходит реги
 Защита работ
9
мин
12.01.2023
10453
Как выбрать университет для защиты диссертации?
Зна Выбор университета/диссертационного совета для защиты кандидатской/докторской научной работы основывается на нескольких основных критериях – престижность учебного заведения, наличие направления научной специальности по теме исследования, руководящий состав вуза и т.д.. Зачем в
 Защита работ
30
мин
09.11.2026
Монографии по методике анкетирования: как выбрать литературу и построить вопросы под задачу исследования
Монография по анкетированию нужна не для того, чтобы взять из неё универсальную готовую анкету, а чтобы связать исследовательскую задачу, вопросы респонденту и границы будущего вывода. При подготовке собственной рукописи стоимость написания монографии обсуждают с учётом темы и исходного материала; м
 Защита работ
7
мин
12.01.2023
10617
Документы для защиты диссертации
Для успешной защиты работы необходимо помимо самого текста работы, также предоставить ряд документов подтверждающих наличие ученой степени, отзыв рецензента, подтверждение сдачи кандидатских экзаменов. Документы, необходимые для допуска к защите кандидатской/докторской диссертации
 Защита работ
13
мин
13.06.2023
24846
Защита магистерской диссертации: особенности и как проходит защита
Успешная защита магистерской диссертации – это необходимое условие для получения академической степени магистра. Защита магистерской работы предоставляет право выпускнику магистратуры на продолжение обучения специальности в аспирантуре и докторантуре. Что нужно для защиты магистер
 Защита работ
6
мин
06.03.2023
10271
Как получить допуск к защите диссертации?
Чтобы получить допуск к защите магистерской/кандидатской/докторской диссертации, соискателю ученой степени следует строго выполнять все предписания ВАК и ГОСТ и соответствовать основным требованиям, перечисленным ниже. Как получить допуск к защите соискателю ученой степени Соискате
Последние новости и статьи
 Докторские диссертации
10
мин
17.11.2026
Почему тренировки не отменяют риск длительного сидения
Можно закончить рабочий день тренировкой, пройти несколько километров быстрым шагом, а вечер всё равно провести в кресле. Такой человек одновременно физически активен и много сидит. Здесь нет противоречия: речь о двух разных сторонах повседневного движения.Это различие изучали Ziyi Zhou и соавторы в
 Наука
2
мин
16.11.2026
Квантовая сеть использовала пять уровней одного иона кальция
Исследователи из Университета науки и технологий Китая построили квантовую нейросеть на пяти энергетических уровнях одного иона кальция. В эксперименте она распознавала изображения одежды из набора Fashion-MNIST и верно классифицировала 95,7% примеров в тестовой выборке из 395 изображений. Об этом T
 Наука
3
мин
16.11.2026
Микрорельеф гидрогеля вернул прозрачность запотевшей крышке за 30 секунд
Исследователи из Калифорнийского университета в Беркли и ETH Zurich создали гидрогелевое покрытие, которое восстанавливает прозрачность при сильной конденсации. В испытании на стеклянной крышке кастрюли покрытый участок сначала запотел, а через 30 секунд после начала кипения овощей снова стал полнос
 Оформление работ
6
мин
16.11.2026
Почему теста на возврат энергии недостаточно, чтобы оценить кроссовки
Подошва сжимается, когда стопа касается земли, и расправляется при отталкивании. Но беговая нагрузка не сводится к нажиму сверху: на повороте обувь испытывает боковой сдвиг, а на неровной поверхности направления усилий меняются. Поэтому один высокий показатель возврата энергии не описывает поведение
 Наука
3
мин
16.11.2026
Фруктоза может ослаблять сцепление клеток рака яичников, но пока это показали только доклинические опыты
Исследователи из Института Уистар в США обнаружили, что фруктоза может ослаблять сцепление между клетками высокозлокачественного серозного рака яичников. В статье, опубликованной онлайн 30 июля 2026 года в журнале Nature Aging, описан механизм, который команда изучила на клетках и мышах. Результаты
 Диссертации по темам
8
мин
16.11.2026
Юмор и давление: что на самом деле показало исследование
Представим лабораторную процедуру: участник десять минут сидит в тишине, затем автоматический прибор несколько раз измеряет давление. Исследователь не рассказывает ему шутки и не просит смотреть стендап. Вместо этого он сопоставляет показатели давления с ответами на опросник о привычном стиле юмора.