


Содержание статьи
Вопросы студентов
26.10.2026
26.10.2026
8
мин
В учебной таблице три участника и два столбца оценок: «математика» и «история». Пять оценок известны, одна отсутствует. Для следующей операции нужна другая структура: название предмета в отдельном столбце, балл — в другом. Покажем переход из широкого формата в длинный и обратно на вымышленных данных, сохраняя ID и пропуск.
Разберём на конкретном вымышленном примере. Никакого реального исследования — только учебная ситуация, чтобы понять, что именно происходит с ячейками, почему не теряются участники и как проверить, что вы ничего не испортили.
| ID | математика | история |
|---|---|---|
| U1 | 60 | 70 |
| U2 | 80 | 90 |
| U3 | 50 | — |
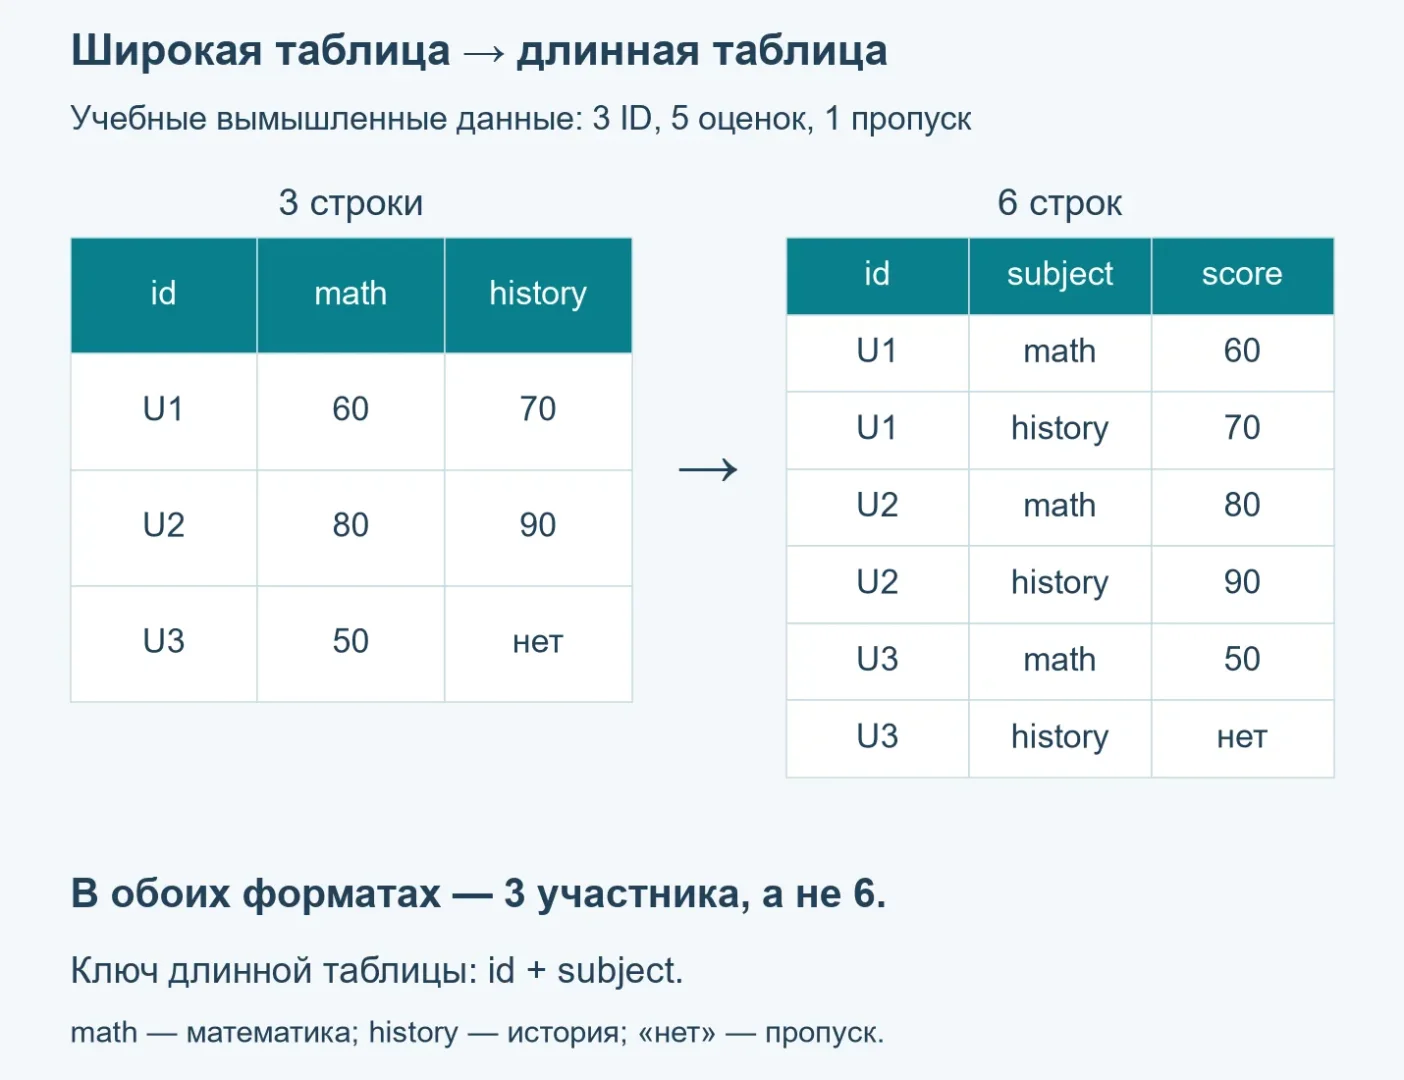
В этой таблице три строки и три столбца. Первый столбец — идентификатор участника. Второй и третий — значения двух переменных. У участника U3 нет оценки по истории: пропуск остаётся пропуском, его нельзя заменять нулём. В таблицах этой статьи знак «—» означает отсутствующую оценку. Числа относятся к двум разным заданиям; общее среднее по предметам здесь не рассчитывается.
Теперь ту же информацию представим иначе: каждая пара «участник — предмет» станет отдельной строкой.
| ID | subject | score |
|---|---|---|
| U1 | математика | 60 |
| U1 | история | 70 |
| U2 | математика | 80 |
| U2 | история | 90 |
| U3 | математика | 50 |
| U3 | история | — |
Строк стало больше — шесть вместо трёх. Но участников по-прежнему трое. Просто идентификатор U1 теперь повторяется в двух строках: для математики и для истории. Уникальной в длинной таблице служит пара (ID, subject): каждая комбинация участника и предмета встречается не более одного раза. Документация pandas описывает это отличие: в «записном» или «широком» формате обычно одна строка на субъект, в «длинном» — несколько строк на один субъект там, где применимо.
Пропуск по истории для U3 перешёл в длинную таблицу как пропуск. Это важно: если вы случайно поставите туда ноль, обратное преобразование даст неверную исходную картину.
Как это выглядит в программе (объяснение без кода)
Операция перехода из широкой таблицы в длинную обычно называется melt (в pandas — pandas.melt). Вы указываете:
- идентификатор — столбец, который остаётся неизменным (у нас
ID); - измеряемые столбцы — те, что вы хотите «переплавить» в строки (у нас
математикаиистория); - новые имена — как назвать столбец с названиями переменных (мы назвали
subject) и столбец со значениями (score).
Обратная операция — pivot (в pandas — DataFrame.pivot). Вы задаёте:
- index — столбец, который станет строками новой таблицы (у нас
ID); - columns — столбец, значения которого образуют новые заголовки столбцов (
subject); - values — столбец, откуда берутся числа (
score).
Документация pandas прямо говорит: pivot не поддерживает агрегацию. Если для одной и той же пары (index, columns) есть несколько значений, возникает ошибка ValueError. Допустим, вы случайно продублировали в длинной таблице строку U2 по математике с другим баллом — 85. Тогда при попытке вернуть широкую таблицу программа сообщит, что не может однозначно определить, какое значение использовать: 80 или 85. И это правильно. Усреднять их автоматически без проверки и обоснованного правила нельзя.
Проверка после преобразования
Чтобы убедиться, что вы ничего не потеряли, пробегитесь по короткому чек-листу:
- Сколько уникальных ID? В нашем примере — три: U1, U2, U3. Исходное число не изменилось.
- Сколько уникальных значений в столбце subject? Два: математика и история. Столько же, сколько было столбцов-переменных.
- Сколько уникальных комбинаций (ID, subject)? Ровно шесть: 3 ID × 2 предмета. Каждая комбинация встречается не чаще одного раза.
- Сколько заполненных score? Пять (пропуск не в счёт).
После обратного преобразования (pivot) при уникальной паре (ID, subject) значения должны восстановиться в тех же комбинациях; отдельно проверьте порядок строк, названия столбцов и представление пропуска. Функция pandas.isna позволяет определить, какие значения являются пропущенными.
Проверка обратного перехода на учебном наборе
После сопоставления по ID и названиям предметов получаем те же исходные значения. Сохранены 3 ID, 5 оценок и 1 пропуск. Порядок столбцов ниже выбран как в исходной таблице.
| ID | математика | история |
|---|---|---|
| U1 | 60 | 70 |
| U2 | 80 | 90 |
| U3 | 50 | — (пропуск) |
Пошаговый учебный порядок (не норматив)
- Сохраните исходную таблицу отдельно — например, в другой лист или файл.
- Выберите столбец-идентификатор. Убедитесь, что он уникально идентифицирует каждую строку исходной таблицы.
- Явно задайте id_vars: ID; value_vars: математика и история; var_name: subject; value_name: score. Если есть другие нужные поля, заранее определите, как их сохранить. Сам исходный файл держите отдельно, а неуказанные в этой операции поля не считайте автоматически перенесёнными.
- Примените melt: ID остаётся как есть, выбранные столбцы «расплавляются».
- Проверьте, что число строк стало равно (число строк в широкой таблице) × (число переменных). У нас 3 × 2 = 6.
- Для обратного преобразования: примените pivot с index=ID, columns=subject, values=score.
- Сравните значения по ID и названиям предметов, отдельно проверьте пропуск. Порядок строк и столбцов, а также запись числового типа могут отличаться; при необходимости восстановите исходный порядок перед сравнением.
Выбор формата зависит от следующей операции и инструмента. В нашем примере широкая таблица показывает оба предмета рядом в строке участника, а длинная — отдельные комбинации ID и предмета. При описании файла полезно заранее записать смысл каждой переменной в кодировочной книге данных.
Ошибки, которые стоит проверить
- Списать пропуск за ноль. Пропуск остаётся пропуском. Если вы запишете 0, обратное преобразование даст неверную картину.
- Повторная пара (ID, subject). Если так случилось, pivot выдаст ошибку. Не усредняйте автоматически — разберитесь, откуда взялся дубль.
- Потерять идентификатор. Без id_vars столбец ID не будет сохранён как идентификатор. Если при этом value_vars не задан, melt по умолчанию рассматривает остальные столбцы как измеряемые. Для нашего примера явно укажите оба набора: ID и два предмета.
- Подумать, что 6 строк = 6 участников. В длинной таблице ID повторяется — участников столько же, сколько уникальных ID.
Что почитать по теме
Назначение и аргументы операций описаны в официальной документации pandas: melt переводит выбранные столбцы в строки, pivot восстанавливает представление по ключам без агрегации. Руководство содержит дополнительные примеры преобразования. Ссылки приведены ниже; учебные значения в этой статье составлены отдельно.
Этот материал — учебный пример. Все числа и ID вымышлены, не переносите их на реальное исследование без адаптации.
Заодно посмотрите как описывать переменные и проверять данные после сбора — это пригодится, когда будете настраивать свою кодировочную книгу.
Если нужна консультация по подготовке собственного файла, можно обсудить статистический анализ данных. Заранее уточните задачу, структуру файла и объём консультации.


Похожие статьи
 Вопросы студентов
9
мин
23.10.2026
Как проверить форматирование документа Word перед печатью
На экране документ может выглядеть аккуратно, а в окне печати внезапно появляется пустая страница, таблица уходит за поле или заголовок остается внизу листа. Поэтому перед печатью курсовой, отчета или другой учебной работы стоит проверить не только текст, но и границы страниц.Ниже приведен порядок п
 Вопросы студентов
7
мин
26.10.2026
Выбросы в данных: как проверить значение и показать его влияние на среднее
В таблице стоит число 30, а остальные значения — 4, 5, 5 и 6. Первое желание — убрать «неудобную» запись и посчитать всё без неё. Но прежде чем удалять что-то из данных, стоит разобраться, откуда взялось это число и что оно меняет. Рассмотрим порядок действий на учебном примере. Учебный набор записе
 Вопросы студентов
8
мин
14.10.2026
Как проверить список литературы от ChatGPT: таблица аудита и разбор ошибок
В списке от ChatGPT может оказаться запись, которая выглядит безупречно, но не находится по точному названию. Бывает и так, что DOI открывает публикацию на похожую тему, но с другим автором. Проверяйте каждый источник отдельно: существует ли он, правильно ли указаны его данные и подтверждает ли он и
 Вопросы студентов
12
мин
25.10.2026
Кодировочная книга анкеты: как описать переменные и проверить данные
Представьте: исследователь открыл таблицу ответов, но не видел анкету. В одной ячейке стоит 97. Это ответ участника, ошибка или пропуск? Кодировочная книга помогает разобраться: она связывает каждую переменную с вопросом, возможными значениями и правилами перехода по анкете. В таблице данных обычно
 Вопросы студентов
12
мин
25.10.2026
Пилотное исследование: что проверить перед основным этапом
Перед основным опросом студентка замечает, что участники по-разному понимают вопрос: «Как часто вы используете цифровые образовательные ресурсы?». Одни учитывают только платформу вуза, другие добавляют видео и поисковики. Это выяснилось до сбора основных ответов, когда формулировку ещё можно уточнит
 Вопросы студентов
15
мин
06.03.2023
10746
Как проверить цитируемость научной статьи?
Индекс цитируемости – это международный показатель «востребованности» работ определенного ученого, отображающийся в суммарном количестве ссылок на труды, опубликованные в реферируемых изданиях российских/международных баз данных (Российский индекс научного цитирования, Web of Sci
Последние новости и статьи
 Наука
3
мин
26.10.2026
Лабораторная плазма показала механизм нагрева солнечной короны, но загадку пока не решила
Как нагреть что-то до миллионов градусов, отходя от источника тепла? Именно этот парадокс десятилетиями мучает астрофизиков: внешняя атмосфера Солнца — корона — в тысячи раз горячее его видимой поверхности. Теперь группа из Китайского института атомной энергии под руководством Вэй Суня впервые воспр
 Наука
4
мин
26.10.2026
Переезд и пустой кошелёк после разрыва связали с неопределённостью сексуальной ориентации
Расставание выбивает из жизни не только человека, но и привычный быт: общую квартиру, совместный счёт, круг знакомых на выходные. Исследователи из Университета штата Канзас обнаружили, что именно эти материальные потери — переезд, потеря друзей, изменение доходов — оказались связаны с тем, что челов
 Наука
2
мин
26.10.2026
Молекулярные особенности ПФАС помогают проектировать сорбенты для очистки воды
Доцент Коуки Ока из Университета Тохоку вместе с коллегами собрал и проанализировал данные о том, как разные материалы захватывают из воды пер- и полифторалкильные вещества (ПФАС) — их часто называют «вечными химикатами». Исследователи предложили общие принципы, по которым можно конструировать сорбе
 Вопросы студентов
7
мин
26.10.2026
Как присвоить ранги одинаковым значениям: связки и средний ранг на примере
Представьте: вы получили пять оценок от разных участников учебного теста. Баллы такие: 40, 10, 20, 20, 50. Задача — расставить эти значения по порядку от наименьшего к наибольшему и дать каждому участнику порядковый номер, то есть ранг. Если бы все баллы были разными, ранги просто совпали бы с номер
 Вопросы студентов
8
мин
26.10.2026
Множественный выбор в анкете: проценты от участников и от всех отметок
В вопросе с множественным выбором сумма процентов может оказаться больше 100%. Само превышение ещё не доказывает ошибку: сначала нужно проверить исходные отметки и знаменатель. Разберём авторский вымышленный пример, где 5 участников оставили 8 отметок и сумма долей участников равна 160%. Все данные
 Вопросы студентов
7
мин
26.10.2026
Проценты и процентные пункты: как правильно описать изменение доли
Представьте учебный отчёт: в период А из 100 опрошенных вариант «Да» выбрали 20 человек, в период Б — 30 человек. Доля выросла с 20% до 30%. Чтобы описать этот результат точно, нужно различать два понятия: процентные пункты и относительное изменение.Например, доля выросла на 10 процентных пунктов (п