


Содержание статьи
Магистерские диссертации
28.10.2026
28.10.2026
6
мин
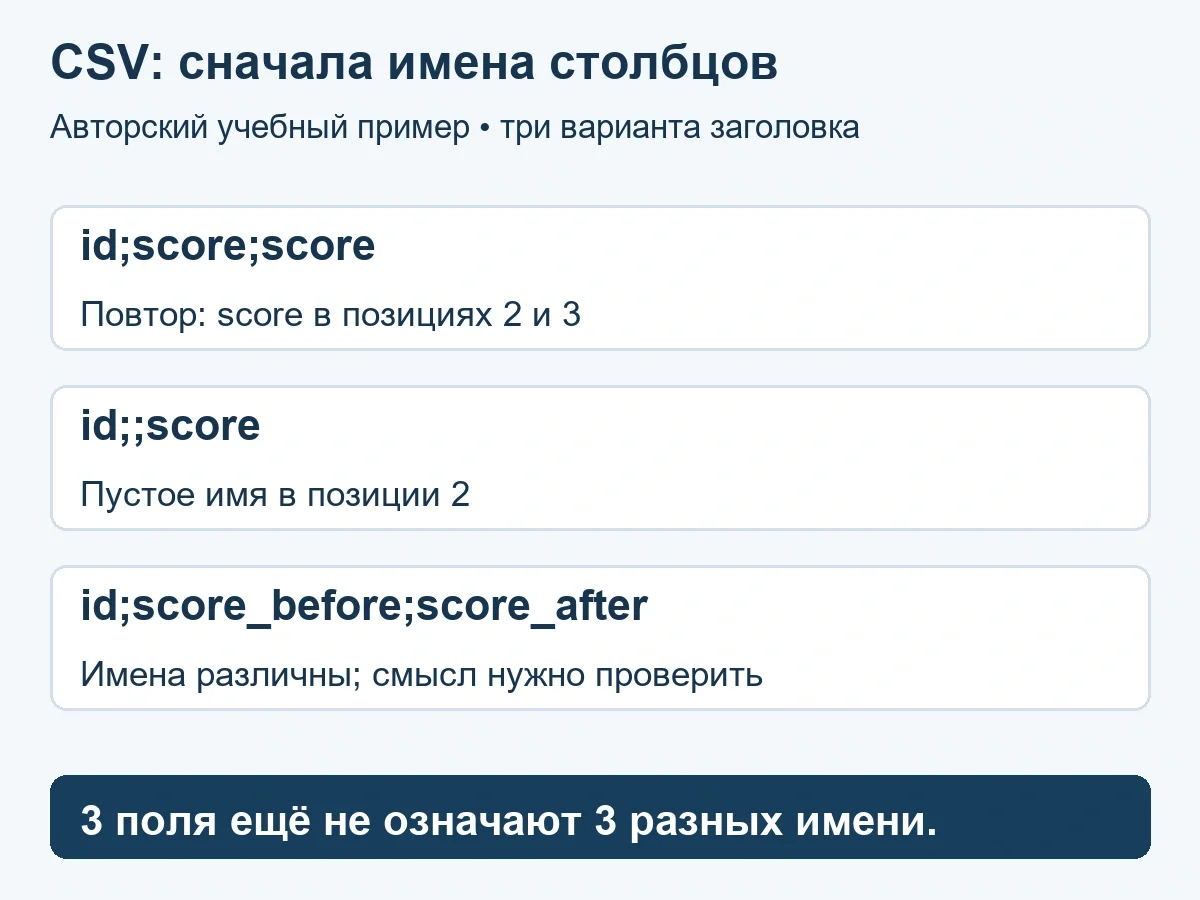
В первом учебном CSV ниже три столбца: id, score и score. После чтения его строки через DictReader в показанном коде словарь содержит два ключа: id и score. В этом примере причина в повторяющемся заголовке: одному имени нельзя одновременно сопоставить два независимых значения в обычном словаре Python. Проверьте исходные имена до преобразования строк в записи по ключам.
Ниже приведены три вымышленных файла с одной записью A01 и значениями 1 и 2. Это учебные строки, а не результаты реального исследования. В первом файле два одинаковых имени score; во втором имя второго столбца пустое; в третьем три разных имени: id, score_before и score_after. Смысл этих значений нужно подтвердить описанием источника: нельзя автоматически решить, что они измерены «до» и «после». Пустое имя и разные имена ниже проверяются отдельно; результат repeated с двумя ключами не следует переносить на другие варианты.
Три варианта заголовка
Заголовок учебного CSV. | Что здесь требует внимания. |
|---|---|
id;score;score | Имя score встречается дважды. |
id;;score | Имя второго поля является пустой строкой. |
id;score_before;score_after | Имена непустые и разные; их содержательный смысл ещё нужно проверить. |
В каждом файле строка данных одинакова: A01;1;2. Сначала полезно получить список полей через csv.reader. В нём сохраняются обе позиции с именем score. DictReader, напротив, строит словарь по именам. Его описание и правила выбора fieldnames приведены в документации csv. Само преобразование не заменяет контроль схемы.
Полный пример: проверить заголовок перед словарём
import csv
import io
from collections import Counter

samples = {
    "repeated": "id;score;score\nA01;1;2\n",
    "empty": "id;;score\nA01;1;2\n",
    "distinct": "id;score_before;score_after\nA01;1;2\n",
}

def inspect_header(text):
    rows = list(csv.reader(io.StringIO(text), delimiter=";"))
    header = rows[0]
    counts = Counter(header)
    duplicates = sorted(k for k, n in counts.items() if n > 1)
    empty = [i + 1 for i, name in enumerate(header) if name == ""]
    width_ok = all(len(row) == len(header) for row in rows[1:])
    return duplicates, empty, width_ok

for name, text in samples.items():
    print(name, inspect_header(text))

lost = list(csv.DictReader(io.StringIO(samples["repeated"]),
                           delimiter=";"))[0]
print("dict_after_repeated =", lost)
assert lost == {"id": "A01", "score": "2"}
assert inspect_header(samples["repeated"]) == (["score"], [], True)
assert inspect_header(samples["empty"]) == ([], [2], True)
assert inspect_header(samples["distinct"]) == ([], [], True)
Вывод для приведённого учебного примера:
repeated (['score'], [], True)
empty ([], [2], True)
distinct ([], [], True)
dict_after_repeated = {'id': 'A01', 'score': '2'}
В учебном повторяющемся варианте DictReader вернул {"id": "A01", "score": "2"}. Первое значение score, строка "1", не получило отдельного ключа в словаре. Оно осталось в сохранённом исходном CSV, но восстановить его из этого словаря уже невозможно. Это наблюдаемый результат именно показанного кода и входных данных.
Три независимые проверки
Проверка | Результат и ограничение |
|---|---|
Повторы имён | Counter считает точные совпадения. У repeated найдено score. Регистр и пробелы не нормализуются. |
Пустые имена | У empty обнаружена позиция 2 при нумерации от единицы. Имя из одних пробелов код не считает пустой строкой. |
Число полей | У всех трёх файлов width_ok=True: количество полей совпало с длиной заголовка. Это не отменяет повтор и пустое имя. |
Показанный код рассчитан на непустой CSV с заголовком и заранее выбранным разделителем «;». Для произвольного файла отдельно обработайте отсутствие записей, согласуйте кодировку и правила кавычек. Диагностика заголовка не подтверждает допустимость отрицательных значений, уникальность ID или единицы измерения.
Исправляйте по схеме источника, сохраняя позиции
- Остановите преобразование в словарь, если обнаружен повтор имени или пустое имя.
- Сохраните полный исходник и позиции столбцов, например score во втором и третьем столбцах.
- Найдите описание экспорта или уточните назначение каждого столбца.
- Составьте явное соответствие исходной позиции и подтверждённого имени.
- После согласованного исправления снова проверьте имена, ширину строк и значения.
Названия score_before и score_after в третьем учебном файле заданы автором. Их нельзя автоматически присваивать двум неизвестным score реальной выгрузки. Даже имена score_1 и score_2 только устраняют техническое совпадение и не объясняют переменные. Журнал преобразования должен показывать, откуда взялось каждое название.
Проверки в примере сравнивают исходные строки буквально. Если проект требует считать «Score» и «score» одним именем либо убирать пробелы по краям, заранее задайте это правило и проверьте, не создаст ли нормализация новые совпадения. Не меняйте исходный заголовок молча.
Итог: одинаковая ширина строк не гарантирует корректную схему. В трёх учебных файлах по три поля, но лишь третий проходит наши проверки на точные повторы и пустые строки в именах. Затем можно переходить к проверке типов при импорте CSV и сверке определений полей по кодировочной книге.
Если требуется подготовить собственную выгрузку к исследовательскому расчёту, можно обсудить консультацию по статистическому анализу. Заранее согласуйте исследовательский вопрос, структуру исходного файла и объём помощи. Успешное чтение файла само по себе не подтверждает достоверность измерений.


Похожие статьи
 Магистерские диссертации
7
мин
27.10.2026
Одинаковые на вид ID: как проверить латинскую A и кириллическую А
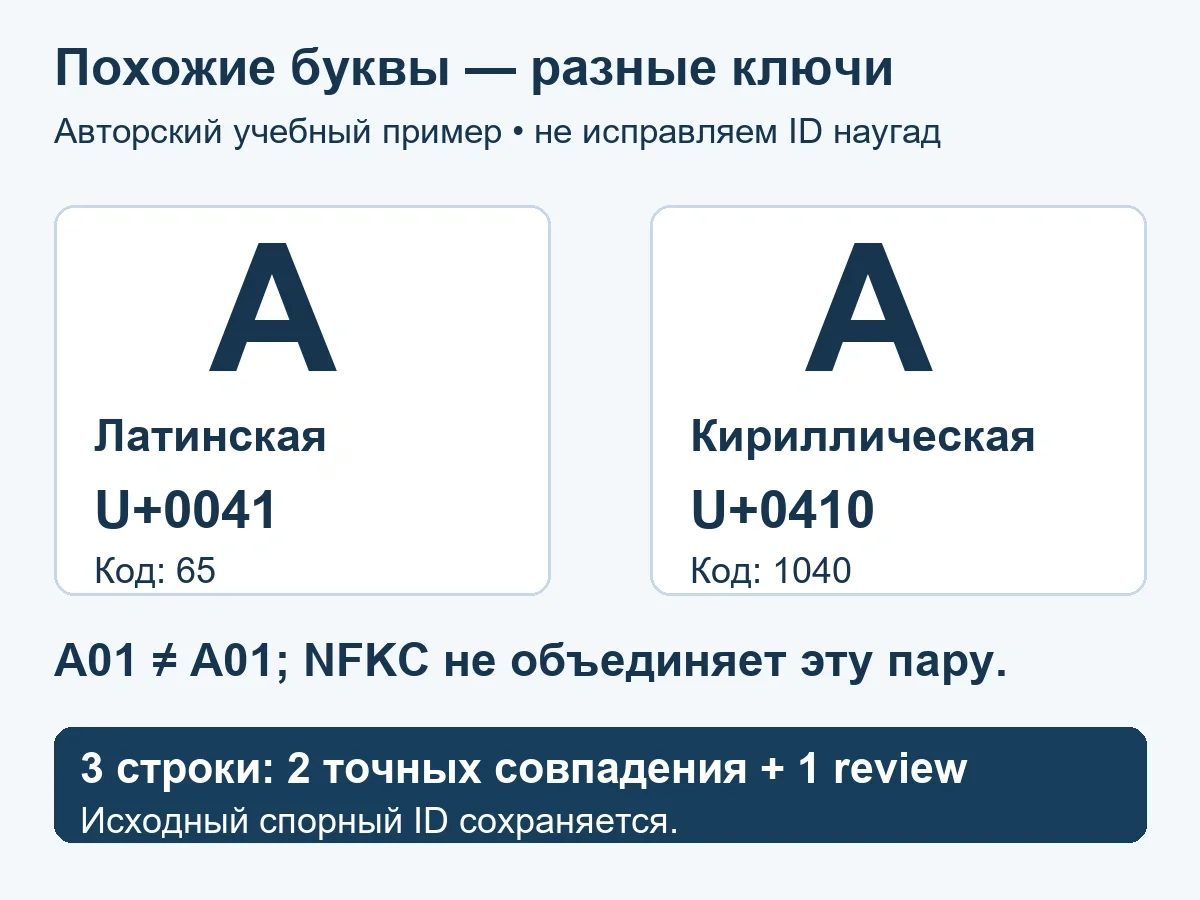
У вас есть справочник с ключами A01 и A02. На вход подано три строки, и одна из них не присоединяется к справочнику, хотя на экране выглядит такой же. Причина прячется на уровне символов: латинская A и кириллическая А записаны разными кодами. Визуальное сходство не делает строки равными и не доказыв
 Магистерские диссертации
4
мин
13.06.2023
10250
Положения на защиту магистерской диссертации + Пример
Положение на защиту магистерской диссертации – это результаты проведенной исследовательской деятельности по теме квалификационной работы, демонстрирующие пользу и ценность проделанной работы. Положения, выносимые на защиту магистерской диссертации, обладают научной новизной и рациональным объя
 Магистерские диссертации
4
мин
14.10.2026
Отменят ли магистратуру в России: что известно на 14 октября 2026 года
Короткий ответ: доступные документы не подтверждают общероссийскую отмену магистратуры. В представленном тексте статьи 10 Федерального закона № 273-ФЗ она перечислена среди уровней профессионального образования. Минобрнауки сообщает о пилотном проекте и проектируемой модели, но эти сообщения сами по
 Магистерские диссертации
7
мин
15.10.2026
Портфолио для поступления в магистратуру: что включить и как оформить
У одного абитуриента есть статья, участие в конференции и опыт работы по специальности. У другого нет публикаций, зато есть проект по теме выбранной программы. Чьё портфолио окажется убедительнее, зависит не от числа файлов и не от универсального списка достижений, а от требований вуза и связи матер
 Магистерские диссертации
11
мин
23.10.2026
Можно ли поступить в магистратуру на другую специальность: правила и примеры
В дипломе бакалавра написано «Экономика», а в списке магистерских программ привлекает «Информационная безопасность». Или филолог хочет перейти в менеджмент. В такой ситуации одного названия прежней специальности недостаточно, чтобы ответить на вопрос о поступлении. Короткий ответ: иногда поступить в
 Магистерские диссертации
10
мин
23.10.2026
Сколько страниц должно быть в магистерской диссертации: как определить объём
В одном вузе студенту выдают методичку с точным числом страниц, а в другом документ описывает только порядок подготовки и защиты ВКР. Поэтому единого объёма для всех магистерских диссертаций нет. Требование устанавливает конкретная образовательная программа, а иногда вместо диссертации программа пре
Последние новости и статьи
 Оформление работ
23
мин
28.10.2026
40395
Оформление списка литературы в диссертации по ГОСТ
Список литературы в диссертации должен помогать найти именно тот документ, который использовал исследователь: нужное издание книги, статью, редакцию нормативного акта или версию электронного материала. Начните с проверки источников и связи с текстом, затем выберите порядок записей и только после это
 Наука
3
мин
28.10.2026
Инулин снизил боль при остеоартрите колена в шестинедельном испытании
Испытание INSPIRE провели исследователи Университета Ноттингема. 117 взрослых с остеоартритом колена шесть недель либо принимали инулин, либо занимались по цифровой программе физиотерапии, либо сочетали оба подхода, либо получали плацебо. Пресс-релиз университета появился 12 марта 2026 года, материа
 Образование
2
мин
28.10.2026
СПбГУТ и китайская корпорация ТАН обсудили онлайн-курсы и цифровые проекты
28 октября 2026 года в Пекине делегация Санкт-Петербургского государственного университета телекоммуникаций имени профессора М. А. Бонч-Бруевича (СПбГУТ) провела переговоры с китайской корпорацией ТАН. Стороны обсудили совместные образовательные программы и проекты в телекоммуникациях, информационны
 Кандидатские диссертации
5
мин
28.10.2026
В JSON нет поля, null, false, 0 или пустая строка: как сохранить различия
После выгрузки данных пять разных записей могут оказаться в одной категории «пусто», если смотреть только на истинность значения. Для исследовательского набора это рискованно: отсутствие ключа и известный ноль обозначают разные состояния. Разберём представление, не гадая, почему ответ не был записан
 Наука
2
мин
28.10.2026
В горах Колумбии не нашли хитрид-грибок, но опасный вариант обнаружили в 20 км
Исследователи Гентского и Трирского университетов обследовали более 2 000 лягушек, жаб и саламандр в горах Сьерра-Невада-де-Санта-Марта на севере Колумбии. Признаков хитрид-грибка там не обнаружили, но примерно в 20 километрах от обследованной зоны нашли высоковирулентный вариант возбудителя. Об эти
 Научные статьи
6
мин
28.10.2026
Почему пять строк CSV дают три записи: переносы внутри кавычек
При проверке выгрузки легко посчитать переводы строки и объявить число участников. Но комментарий в одной ячейке CSV может занимать несколько физических строк. Поэтому сначала разберите файл с его разделителем и правилами кавычек, а затем считайте записи данных.Ниже специально созданный учебный текс