


Содержание статьи
Магистерские диссертации
28.10.2026
28.10.2026
6
мин
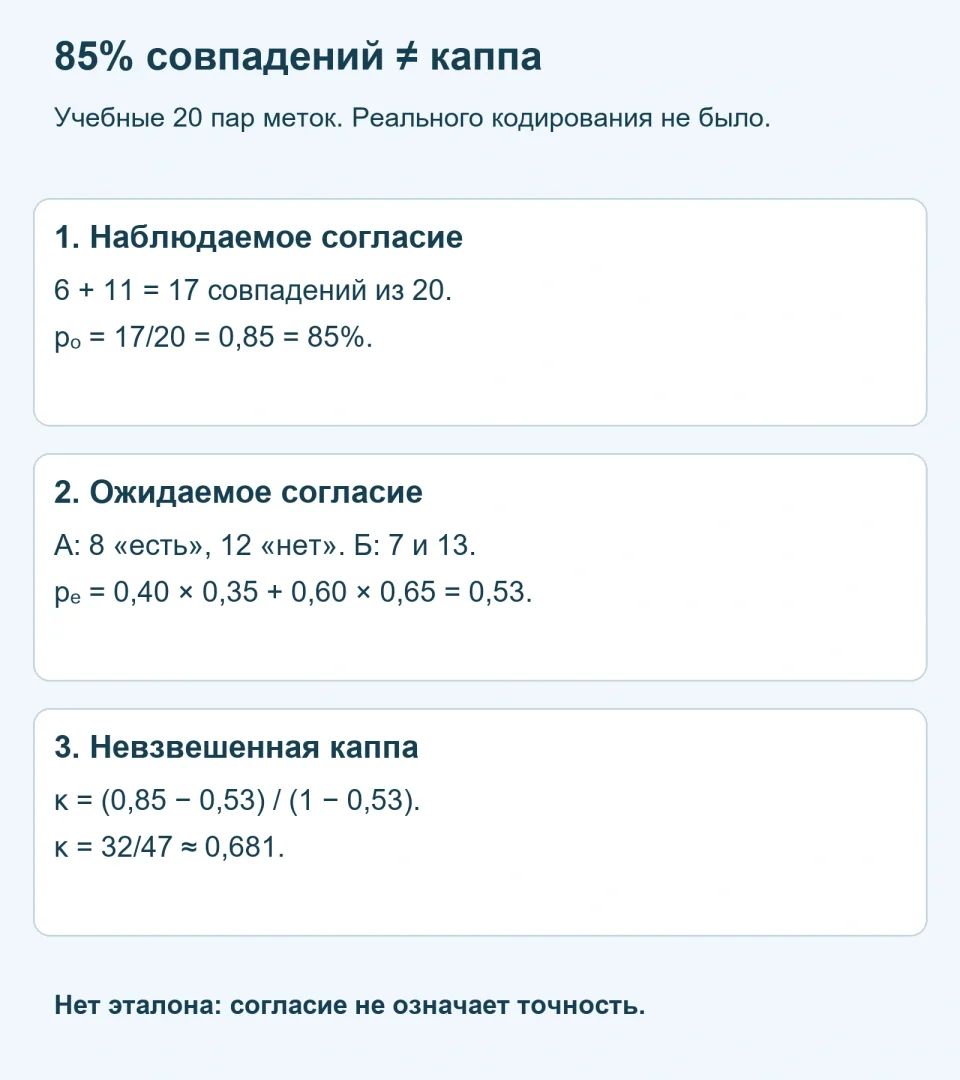
Два кодировщика разошлись в трёх случаях из двадцати, а в остальных семнадцати поставили одну и ту же метку. Отсюда легко получить 85% совпадений, но это ещё не каппа Коэна: у двух показателей разные определения. Дальше один и тот же набор пар превращается в таблицу, из которой считаются оба числа, и становится видно, почему согласие двух кодировщиков нельзя называть точностью относительно истины.
Все решения в этом разборе придуманы для упражнения: реальных текстов, участников и проведённого кодирования здесь нет. Есть двадцать условных единиц К01–К20. Для каждой записаны две метки одного и того же номинального признака, «есть» или «нет»: первая принадлежит условному кодировщику А, вторая — Б. Считаем обычную невзвешенную каппу, без весов для отдельных наблюдений.
Исходные пары: сохраняйте соответствие единиц
| Условные единицы | Метки А / Б и количество |
|---|---|
| К01–К06 | есть / есть: 6 |
| К07–К08 | есть / нет: 2 |
| К09 | нет / есть: 1 |
| К10–К20 | нет / нет: 11 |
Диапазоны ID задают все двадцать пар целиком. Это не два независимо отсортированных списка: каждая пара относится к одной единице. Если переставить метки одного кодировщика относительно ID, распределения меток могут не измениться, а число совпадений станет другим. Поэтому соответствие стоит сверить до расчёта.
Постройте таблицу совместных меток
| Ячейка: А / Б | Частота |
|---|---|
| есть / есть | 6 |
| есть / нет | 2 |
| нет / есть | 1 |
| нет / нет | 11 |
| Всего | 20 |
Совпадения стоят в ячейках «есть / есть» и «нет / нет»: 6 + 11 = 17. Расхождения дают две другие ячейки: 2 + 1 = 3. Проверка: 17 + 3 = 20, все единицы на месте. Наблюдаемая доля согласия pₒ = 17 / 20 = 0,85, то есть 85%.
Учтите, как часто каждый использовал метки
У А метка «есть» встречается 6 + 2 = 8 раз, «нет» — 1 + 11 = 12 раз. У Б соответственно 6 + 1 = 7 и 2 + 11 = 13. Это маргинальные частоты той же таблицы, а не дополнительные единицы. Их смысл и проверка итогов связаны с таблицей сопряжённости и её знаменателями.
| Кодировщик | Доли двух меток |
|---|---|
| А | есть: 8/20 = 0,40; нет: 12/20 = 0,60 |
| Б | есть: 7/20 = 0,35; нет: 13/20 = 0,65 |
В документации scikit-learn для каппы Коэна pₑ определяется через индивидуальные эмпирические доли меток. Для двух категорий здесь: pₑ = (8/20 × 7/20) + (12/20 × 13/20) = 0,14 + 0,39 = 0,53. Это ожидаемое согласие в используемой формуле, а не ещё 53% фактически размеченных совпадений.
Рассчитайте каппу отдельно от процента
Формула каппы: κ = (pₒ − pₑ) / (1 − pₑ). Подставляем доли: κ = (0,85 − 0,53) / (1 − 0,53) = 0,32 / 0,47 = 32/47 ≈ 0,681. Ответ округлён до трёх знаков после запятой, промежуточные доли в расчёте не округлялись.
| Показатель | Итог учебного примера |
|---|---|
| Наблюдаемое согласие | 17/20 = 85% |
| Ожидаемое согласие pₑ | 0,53 из маргинальных долей |
| Невзвешенная каппа κ | 32/47 ≈ 0,681 |
Каппа 0,681 не означает «68,1% правильных ответов». В примере нет эталонной разметки, сравнивать не с чем: то, что два кодировщика поставили одинаковые метки, само по себе не доказывает, что метки верны относительно изучаемого материала. И универсального порога «достаточно хорошо» из этого расчёта тоже не выводится.
Что проверить и сохранить в своей работе
- Совпадают ли у двух кодировщиков единица кодирования и порядок ID.
- Работают ли оба с одним набором меток и одной версией инструкции.
- Как обработаны пропущенные метки: в этом примере их нет, а в своей работе правило придётся описать.
- Приведены ли совместные и маргинальные частоты, наблюдаемое согласие и вид каппы.
- Не смешаны ли невзвешенные номинальные метки с задачей порядкового взвешивания.
- Не выдан ли условный пример за проверку реального кодбука.
Отдельный случай: если pₑ = 1, знаменатель 1 − pₑ обращается в ноль и эта формула значения не задаёт. Подставлять результат вручную ради красивого числа не нужно; проверьте распределения меток и правила того расчёта, которым пользуетесь. И помните, что маленький учебный набор не даёт оснований обещать, что показатель удержится на новом корпусе.
Порядок создания правил и разбора неоднозначных фрагментов описан в инструкции по контент-анализу. Здесь решена отдельная арифметическая задача: из 20 заранее заданных пар получены 85% совпадений и κ ≈ 0,681. Для реального исследования ещё нужны обоснование процедуры, описание корпуса и содержательный разбор расхождений.
Если нужна помощь со статистической частью работы, ознакомьтесь с описанием услуги статистического анализа и заранее уточните, входит ли в неё проверка такого расчёта. Согласуйте задачу, состав исходных данных, объём работы и сроки; план учебной работы обсудите с руководителем.


Похожие статьи
 Магистерские диссертации
7
мин
27.10.2026
Одинаковые на вид ID: как проверить латинскую A и кириллическую А
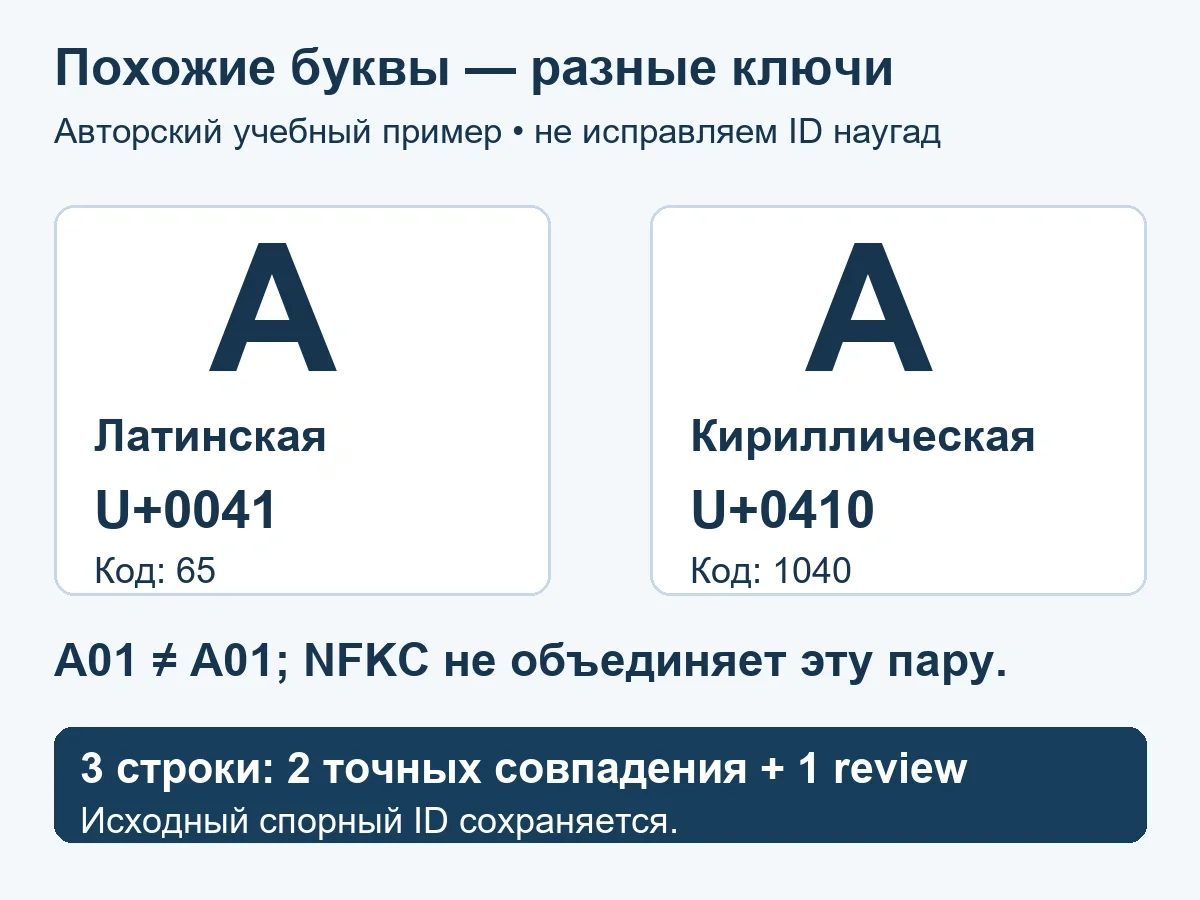
У вас есть справочник с ключами A01 и A02. На вход подано три строки, и одна из них не присоединяется к справочнику, хотя на экране выглядит такой же. Причина прячется на уровне символов: латинская A и кириллическая А записаны разными кодами. Визуальное сходство не делает строки равными и не доказыв
 Магистерские диссертации
7
мин
13.06.2023
10266
Методы исследования в магистерской диссертации: какие бывают и как их писать
Методы исследования в магистерской диссертации — это совокупность инструментов, использующихся для сбора и анализа данных в рамках исследования. Они помогают получить общее представление о рассматриваемой проблеме, проверить истинность научной гипотезы, разработать экспериментальную базу, необ
 Магистерские диссертации
4
мин
14.10.2026
Отменят ли магистратуру в России: что известно на 14 октября 2026 года
Короткий ответ: доступные документы не подтверждают общероссийскую отмену магистратуры. В представленном тексте статьи 10 Федерального закона № 273-ФЗ она перечислена среди уровней профессионального образования. Минобрнауки сообщает о пилотном проекте и проектируемой модели, но эти сообщения сами по
 Магистерские диссертации
10
мин
23.10.2026
Сколько страниц должно быть в магистерской диссертации: как определить объём
В одном вузе студенту выдают методичку с точным числом страниц, а в другом документ описывает только порядок подготовки и защиты ВКР. Поэтому единого объёма для всех магистерских диссертаций нет. Требование устанавливает конкретная образовательная программа, а иногда вместо диссертации программа пре
Последние новости и статьи
 Наука
3
мин
28.10.2026
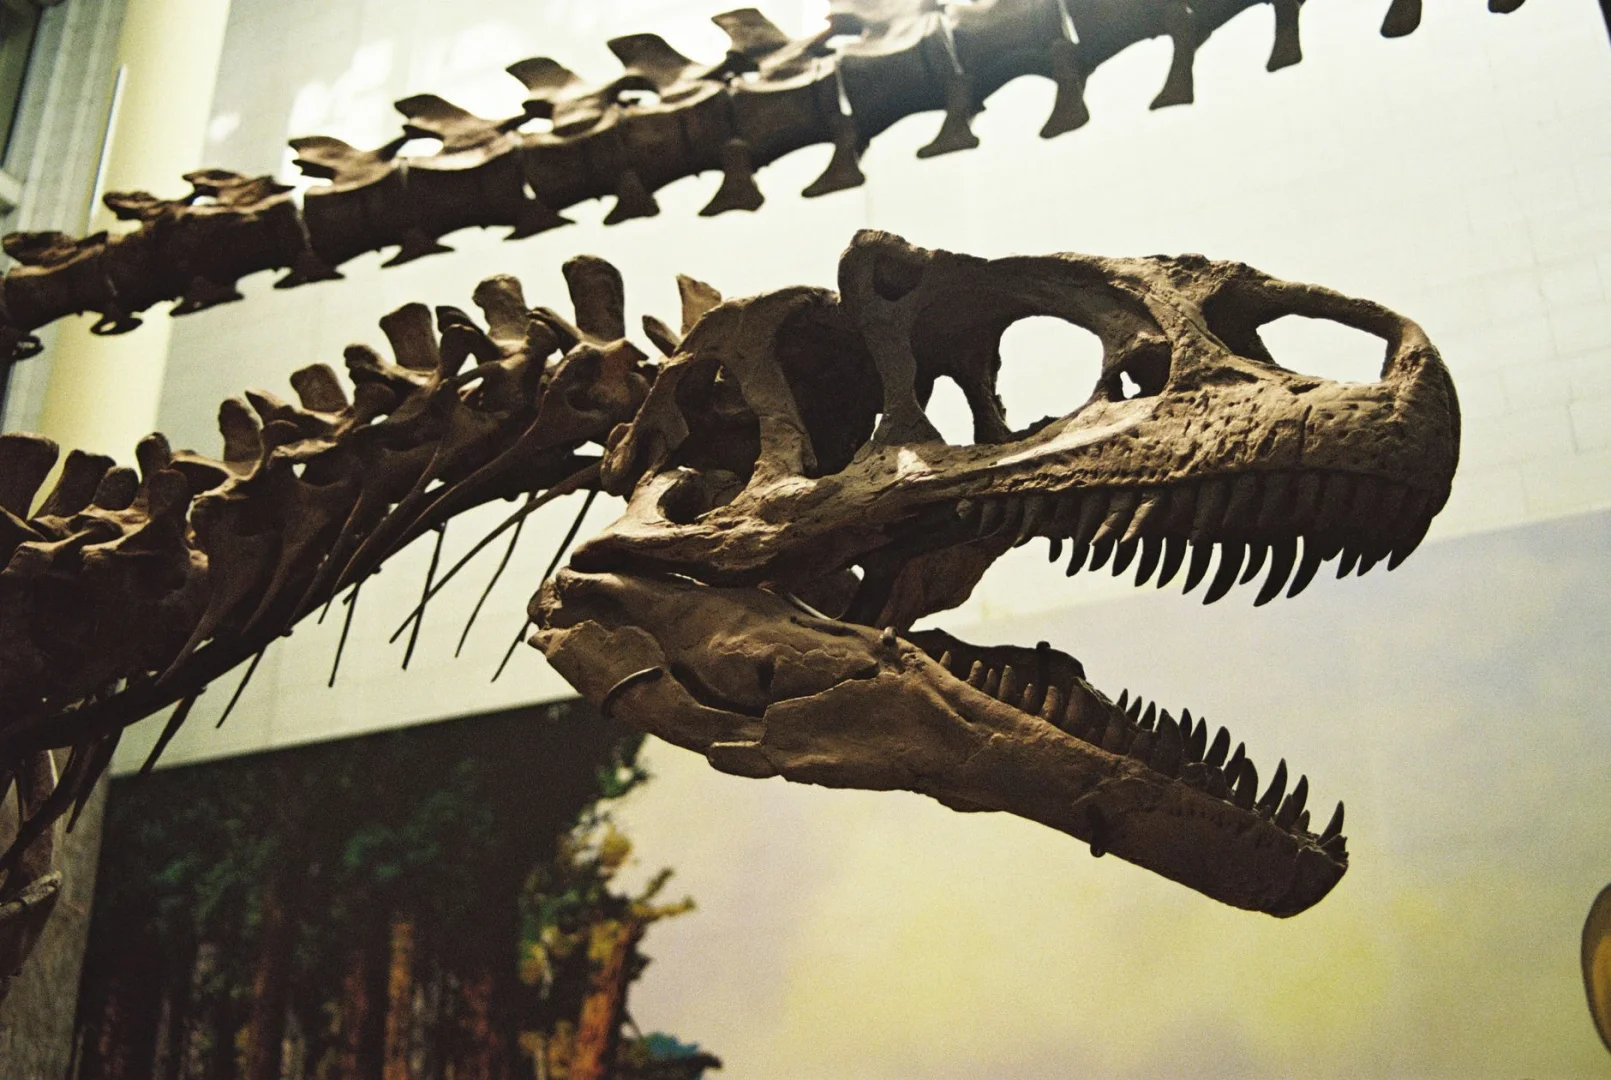
В музейных коллекциях нашли новый род динозавров из южной Англии
Палеонтологи описали новый род и вид растительноядных динозавров по окаменелостям из коллекции Музея естественной истории в Лондоне. Останки нашли в 2001 году на кирпичном заводе Ewhurst Works в графстве Суррей, после чего передали музею. О находке сообщили 27 октября 2026 года, когда исследование о
 Наука
5
мин
28.10.2026
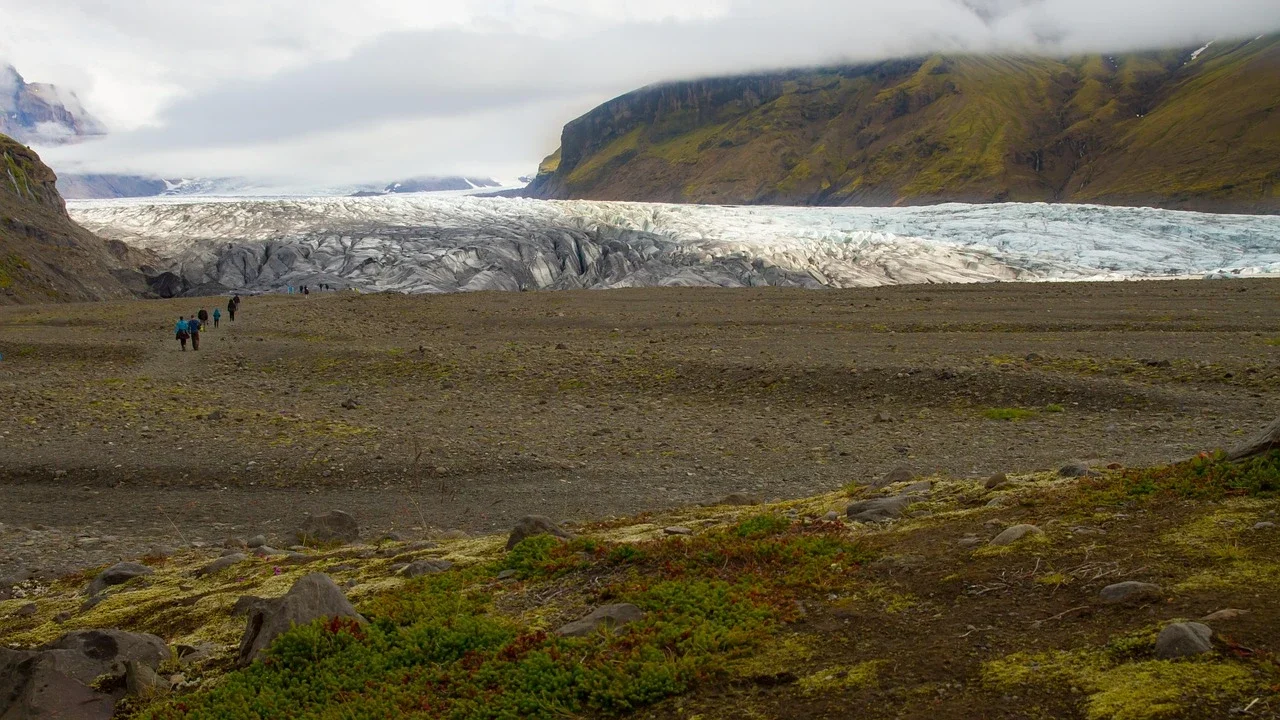
Валуны в заливе Маргерит впервые дали даты антарктических морен
По валунам на трёх моренах в заливе Маргерит на западе Антарктического полуострова впервые напрямую датировали неогляциальные отложения. Возраст морены у ледника Шумсмит на острове Хорсшу группа под руководством Атиллы Чинера из Института наук о Земле Евразии Стамбульского технического университета
 Вузы
3
мин
28.10.2026
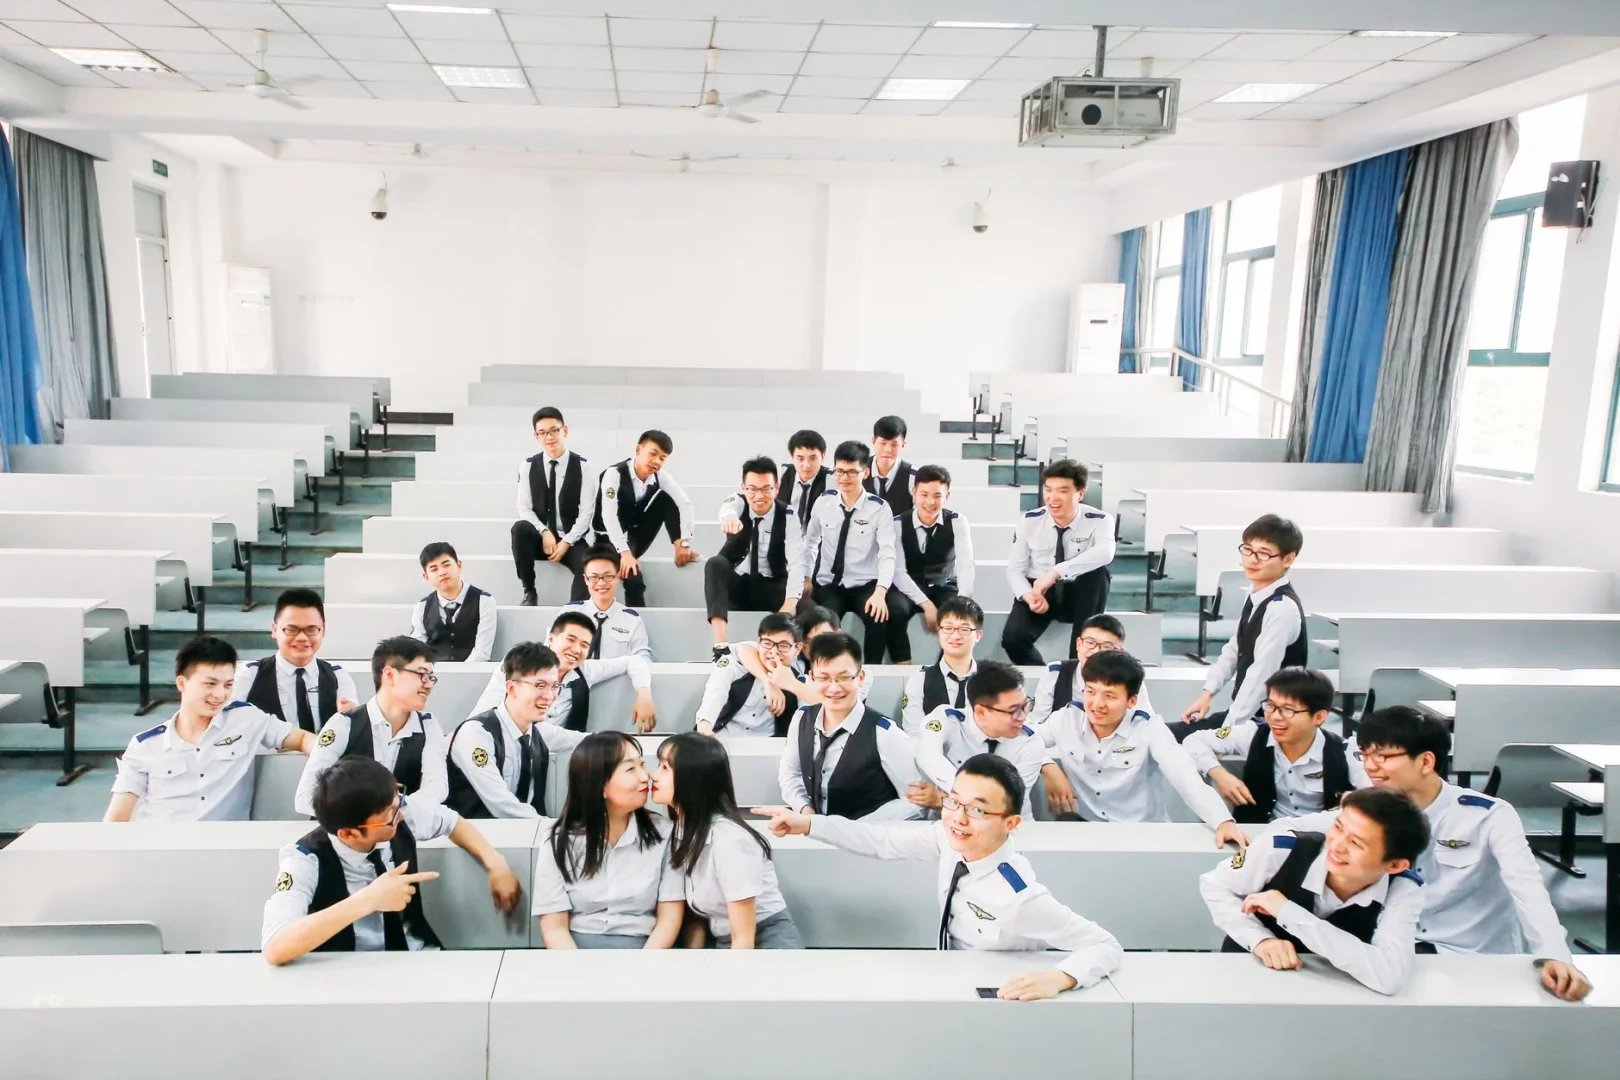
Совместный институт НГУ и Цзянсийского педуниверситета принял 276 первых студентов
Новосибирский институт математики и искусственного интеллекта при Цзянсийском педагогическом университете, созданный НГУ совместно с китайским вузом, в 2026 году принял первых 276 студентов. О церемонии открытия, которая прошла во время визита делегации Новосибирского государственного университета в
 Практика
22
мин
28.10.2026
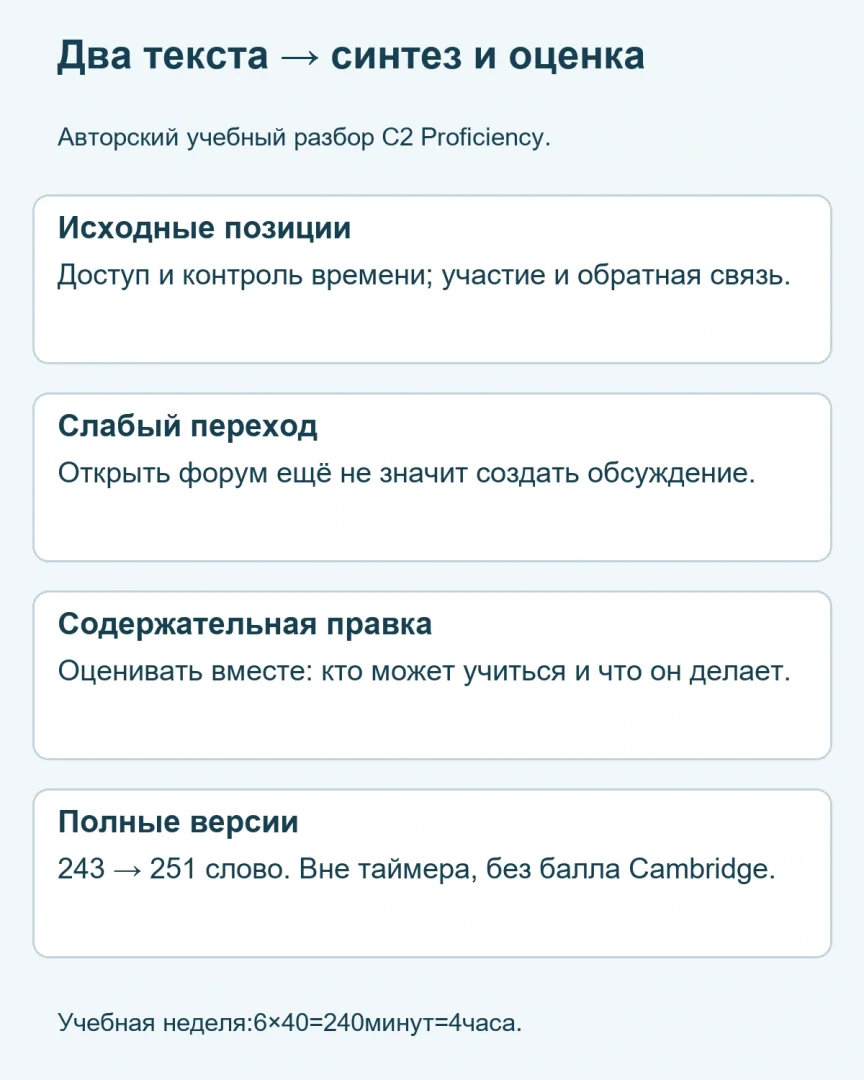
Как готовиться к C2 Proficiency: формат и проверка готовности
Подготовку к C2 Proficiency, который также известен под прежним сокращением CPE, стоит начинать с конкретного задания. В обязательном эссе нужно соединить идеи двух текстов, оценить их и предложить собственную позицию. Простого пересказа или набора сложных слов недостаточно. Ниже разбор действующего
 Оформление работ
6
мин
28.10.2026
Парадокс Симпсона: почему сравнение долей меняется после объединения групп
В каждой из двух подгрупп у варианта А доля выполненных заданий выше, чем у варианта Б. После объединения подгрупп сравнение меняется на противоположное. Арифметическая ошибка для этого не нужна: общая доля по-разному взвешивает подгруппы. Ниже обратный порядок сравнения показан на полностью заданны
 Кандидатские диссертации
6
мин
28.10.2026
Ожидаемые частоты в таблице: как считать их по итогам строк и столбцов
Наблюдаемая частота — это то, что записано в исходной таблице. Ожидаемая частота при предположении независимости получается отдельным расчётом по итогам той же таблицы. Она не исправляет данные и не сообщает, сколько объектов «должно было» наблюдаться. Разберём все шесть ячеек учебной таблицы 2 × 3.