


Содержание статьи
Магистерские диссертации
27.10.2026
27.10.2026
7
мин
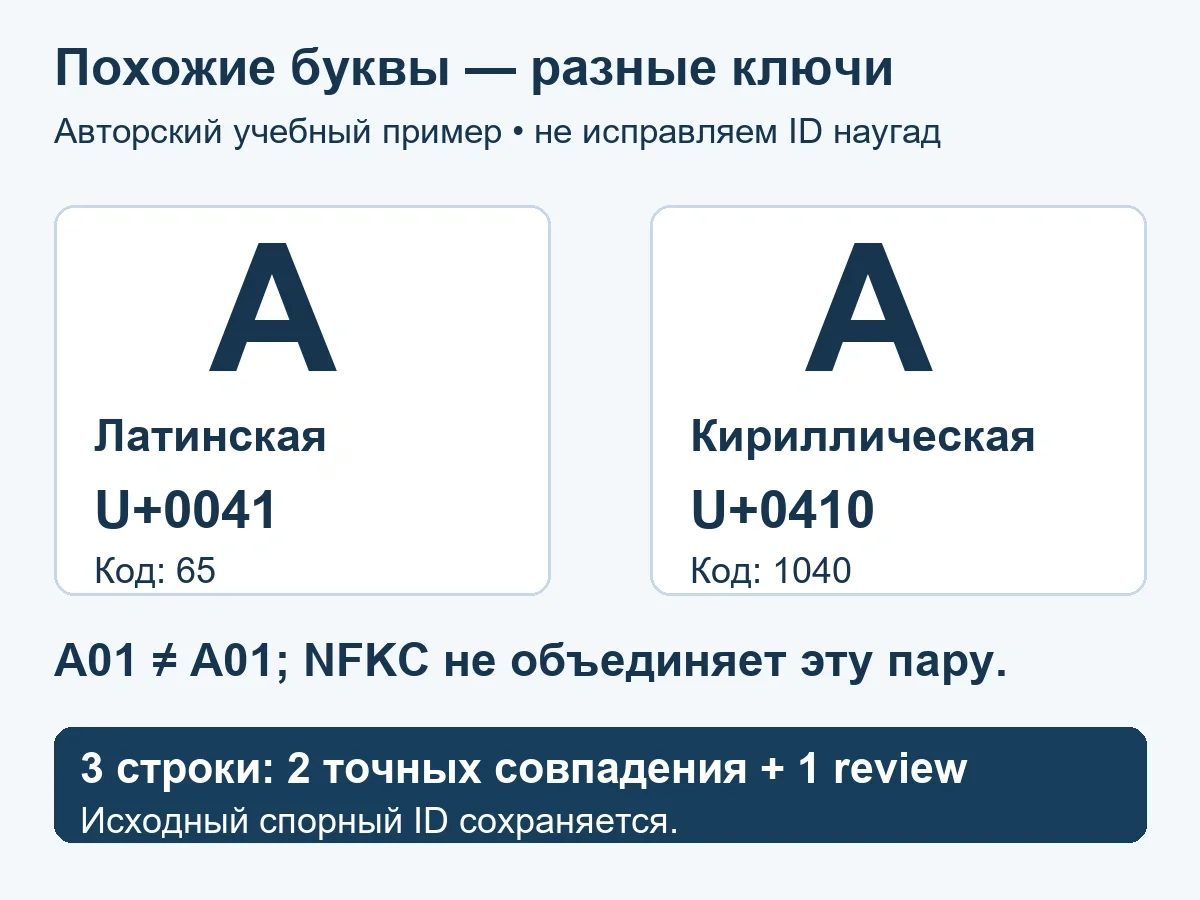
У вас есть справочник с ключами A01 и A02. На вход подано три строки, и одна из них не присоединяется к справочнику, хотя на экране выглядит такой же. Причина прячется на уровне символов: латинская A и кириллическая А записаны разными кодами. Визуальное сходство не делает строки равными и не доказывает, что они описывают один и тот же объект.
Представьте себе учебный пример. Справочник содержит только латинские идентификаторы A01 и A02. На вход подано три записи: первая A01, третья A02, а вторая — А01, где первый символ кириллический. Откуда взялся этот второй ключ, мы не знаем. Задача здесь не исправить его автоматически, а зафиксировать разницу и сохранить строку для выяснения.
Проверьте код и имя первой буквы
Для трёх вымышленных строк ниже все первые символы имеют назначенные имена: LATIN CAPITAL LETTER A или CYRILLIC CAPITAL LETTER A. В общем случае unicodedata.name возвращает назначенное имя; если имени нет и аргумент default не задан, она возбуждает ValueError. В выводе нашего кода match означает точное совпадение со справочником, а review — необходимость проверки без изменения исходного ключа.
NFKC — форма нормализации Unicode: сначала выполняется разложение по совместимости, затем каноническая композиция. Это преобразование представления текста по правилам Unicode. Ниже мы проверяем его результат только для двух выбранных ключей; оно не подменяет решение о том, какие записи относятся к одному объекту.
Символ | Код и назначенное имя |
|---|---|
A, латинская | Кодовая позиция U+0041; официальное имя — LATIN CAPITAL LETTER A; десятичное представление 65. |
А, кириллическая | Кодовая позиция U+0410; официальное имя — CYRILLIC CAPITAL LETTER A; десятичное представление 1040. |
В официальной документации Python описаны имя символа и нормальные формы Unicode. Стандарт Unicode Security Mechanisms отдельно рассматривает визуально смешиваемые символы. Наш код ниже - простая диагностика конкретных ключей, а не полная реализация проверки безопасности по этому стандарту.
Все три исходные строки и результат
Исходные строки и результат диагностики | Результат без подмены ключа |
|---|---|
Первая строка: A01 | Первый символ — U+0041. Такой ключ точно присутствует в справочнике. |
Вторая строка: А01 | Первый символ — U+0410. Точного совпадения со справочником нет, поэтому запись помечается статусом review (нужна проверка). |
Третья строка: A02 | Первый символ — U+0041. Ключ есть в справочнике. |
Два идентификатора точно совпали с эталонными, один требует проверки: 2 + 1 = 3 исходные записи. Пометка проверки не означает, что оператор ошибся при вводе, и не утверждает, что один человек фигурирует под двумя ID или что запись потеряна. Для любого из этих выводов нужна документация и источник самого идентификатора.
Полный пример для повторения
import unicodedata as ud
reference = {"A01": "known-1", "A02": "known-2"}
raw = ["A01", "\u041001", "A02"]
for n, key in enumerate(raw, 1):
    first = key[0]
    print(n, repr(key), f"U+{ord(first):04X}",
          ud.name(first), "match" if key in reference else "review")
latin, cyrillic = raw[:2]
print("equal =", latin == cyrillic)
print("NFKC_equal =", ud.normalize("NFKC", latin) == ud.normalize("NFKC", cyrillic))
assert latin != cyrillic
assert ud.normalize("NFKC", cyrillic) == cyrillic
assert sum(x in reference for x in raw) == 2
Ожидаемый вывод программы:
1 'A01' U+0041 LATIN CAPITAL LETTER A match
2 'А01' U+0410 CYRILLIC CAPITAL LETTER A review
3 'A02' U+0041 LATIN CAPITAL LETTER A match
equal = False
NFKC_equal = False
Строка "\u041001" начинается с escape-последовательности \u0410, задающей одну кириллическую букву; за ней идут цифры 0 и 1. Поэтому первый символ имеет код U+0410, и вся строка не равна латинской "A01". Приведённый код действительно сверяет ключи строго посимвольно: одинаковая длина и похожие очертания для совпадения недостаточны.
Почему NFKC не заменяет проверку смысла
В нашем примере NFKC оставляет кириллическую А на месте: нормализованные ключи всё равно не равны. Нормализация Unicode описывает канонические и совместимые представления — это не инструкция «считать любые похожие буквы одним знаком». При этом для других идентификаторов NFKC может изменить представление, поэтому сохранение наших двух ключей нельзя распространять на все возможные ID. Замена всех похожих букв по внешнему виду рискует соединить разные объекты. Даже если протокол проекта допускает исправление такого ввода, сначала получите основание, сохраните сырые данные, зафиксируйте правило и проверьте, не возникли ли после преобразования коллизии ключей. В нашем примере основания нет, так что второй ID остаётся неизменным.
Порядок проверки несовпавшего ключа
- Покажите исходную строку, её длину, коды и имена подозрительных символов.
- Сравнивайте с точным ID из исходного справочника, а не с похожей фамилией.
- Отделите диагностический флаг от решения исправить значение.
- При документированном исправлении сохраните пару «было → стало» и основание, затем убедитесь в уникальности нового ключа.
- Без документального основания оставьте пометку проверки; сохраните все исходные строки, включая несовпавшую.
После выяснения смысла ключей можно вернуться к объединению таблиц по ID и проверке несовпадений. Эта статья решает более узкую задачу: почему два визуально сходных ключа не равны на уровне символов. Она не выбирает за исследователя, какие записи являются одним объектом.
Если для собственного исследовательского набора нужна помощь с правилами подготовки и проверкой расчёта, можно обсудить подготовку и проверку статистического анализа. Заранее согласуйте вопрос, состав исходных файлов и объём помощи. Автоматическое преобразование строк само по себе не подтверждает достоверность данных.


Похожие статьи
 Магистерские диссертации
7
мин
15.10.2026
Портфолио для поступления в магистратуру: что включить и как оформить
У одного абитуриента есть статья, участие в конференции и опыт работы по специальности. У другого нет публикаций, зато есть проект по теме выбранной программы. Чьё портфолио окажется убедительнее, зависит не от числа файлов и не от универсального списка достижений, а от требований вуза и связи матер
 Магистерские диссертации
11
мин
23.10.2026
Можно ли поступить в магистратуру на другую специальность: правила и примеры
В дипломе бакалавра написано «Экономика», а в списке магистерских программ привлекает «Информационная безопасность». Или филолог хочет перейти в менеджмент. В такой ситуации одного названия прежней специальности недостаточно, чтобы ответить на вопрос о поступлении. Короткий ответ: иногда поступить в
 Магистерские диссертации
10
мин
23.10.2026
Сколько страниц должно быть в магистерской диссертации: как определить объём
В одном вузе студенту выдают методичку с точным числом страниц, а в другом документ описывает только порядок подготовки и защиты ВКР. Поэтому единого объёма для всех магистерских диссертаций нет. Требование устанавливает конкретная образовательная программа, а иногда вместо диссертации программа пре
 Магистерские диссертации
7
мин
13.06.2023
10266
Методы исследования в магистерской диссертации: какие бывают и как их писать
Методы исследования в магистерской диссертации — это совокупность инструментов, использующихся для сбора и анализа данных в рамках исследования. Они помогают получить общее представление о рассматриваемой проблеме, проверить истинность научной гипотезы, разработать экспериментальную базу, необ
 Магистерские диссертации
4
мин
13.06.2023
10250
Положения на защиту магистерской диссертации + Пример
Положение на защиту магистерской диссертации – это результаты проведенной исследовательской деятельности по теме квалификационной работы, демонстрирующие пользу и ценность проделанной работы. Положения, выносимые на защиту магистерской диссертации, обладают научной новизной и рациональным объя
 Магистерские диссертации
6
мин
08.05.2023
10304
План магистерской диссертации: пример
План магистерской диссертации позволяет выявить направление основных тезисов будущего исследования в соответствии с целью и научной гипотезой, а также грамотно организовать процесс выполнения задания. В зависимости от темы работы, план написания магистерской диссертации учитывает способы достижения
Последние новости и статьи
 Оформление работ
6
мин
27.10.2026
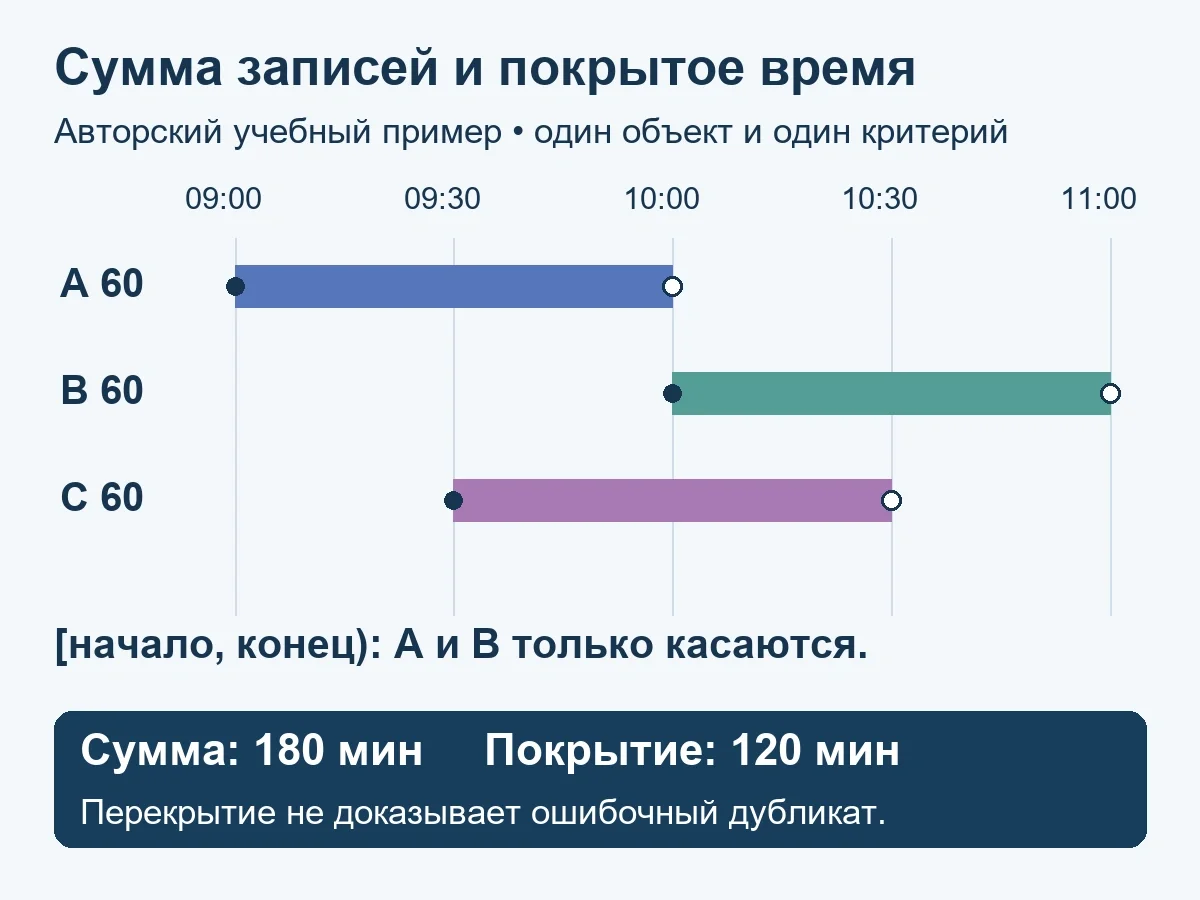
Перекрывающиеся интервалы наблюдений: как не задвоить длительность
Представьте журнал, в котором три записи, каждая по часу. В сумме — 180 минут. Но на временной шкале они умещаются всего в два часа. Ошибка возникает, когда сумму длительностей строк выдают за время, в течение которого велось хотя бы одно наблюдение. Это разные показатели, и прежде всего нужно опред
 Оформление и требования к диссертации
6
мин
27.10.2026
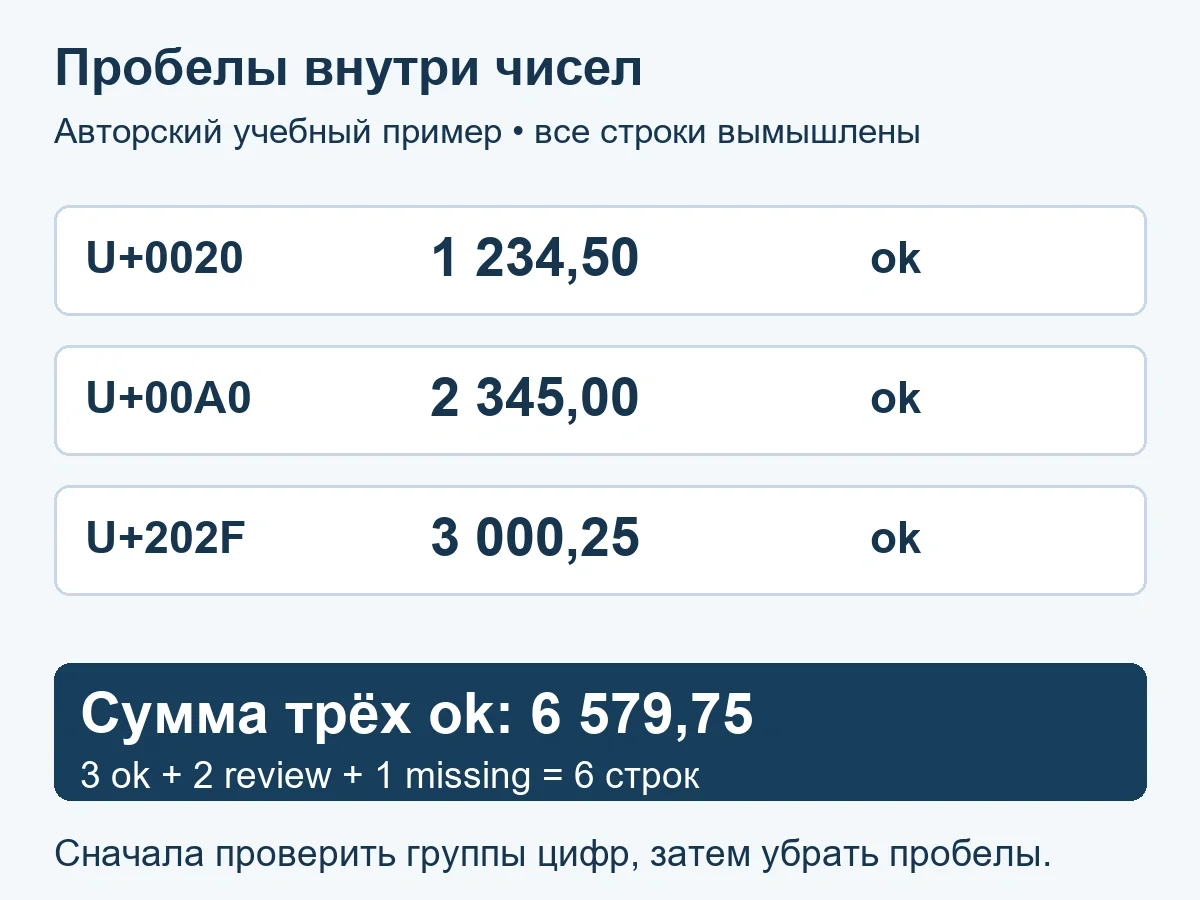
Неразрывные пробелы в числах: как проверить «1 234,50» перед расчётом
Вы открываете файл, чтобы посчитать итог, и видите значения «1 234,50», «2 345,00» и «3 000,25». Внутри стоят разные символы пробела. Если без проверки удалить из строки все разрешённые пробелы, можно скрыть ошибочную группировку. Поэтому сначала проверяют исходную строку по выбранной грамматике, со
 Наука
3
мин
27.10.2026
Шумомер вместо судей: 30 октября в ТвГУ пройдёт «Научная битва»
Четверо учёных выйдут к публике в Твери вечером 30 октября 2026 года, но привычных лекций не будет. Каждый получит ровно десять минут, чтобы рассказать о своём исследовании так, как рассказывают захватывающую историю. Победителя назовут не судьи, а шумомер — организаторы из Тверского государственног
 Помощь по написанию
16
мин
27.10.2026
21432
Как написать литературный обзор для диссертации?
Литературный обзор для диссертации должен объяснять, что известно по исследовательскому вопросу, как соотносятся результаты разных работ и на каком основании вы формулируете собственную задачу. Библиографический список сообщает, какие документы использованы; обзор связывает их содержание в аргумент.
 Наука
7
мин
27.10.2026
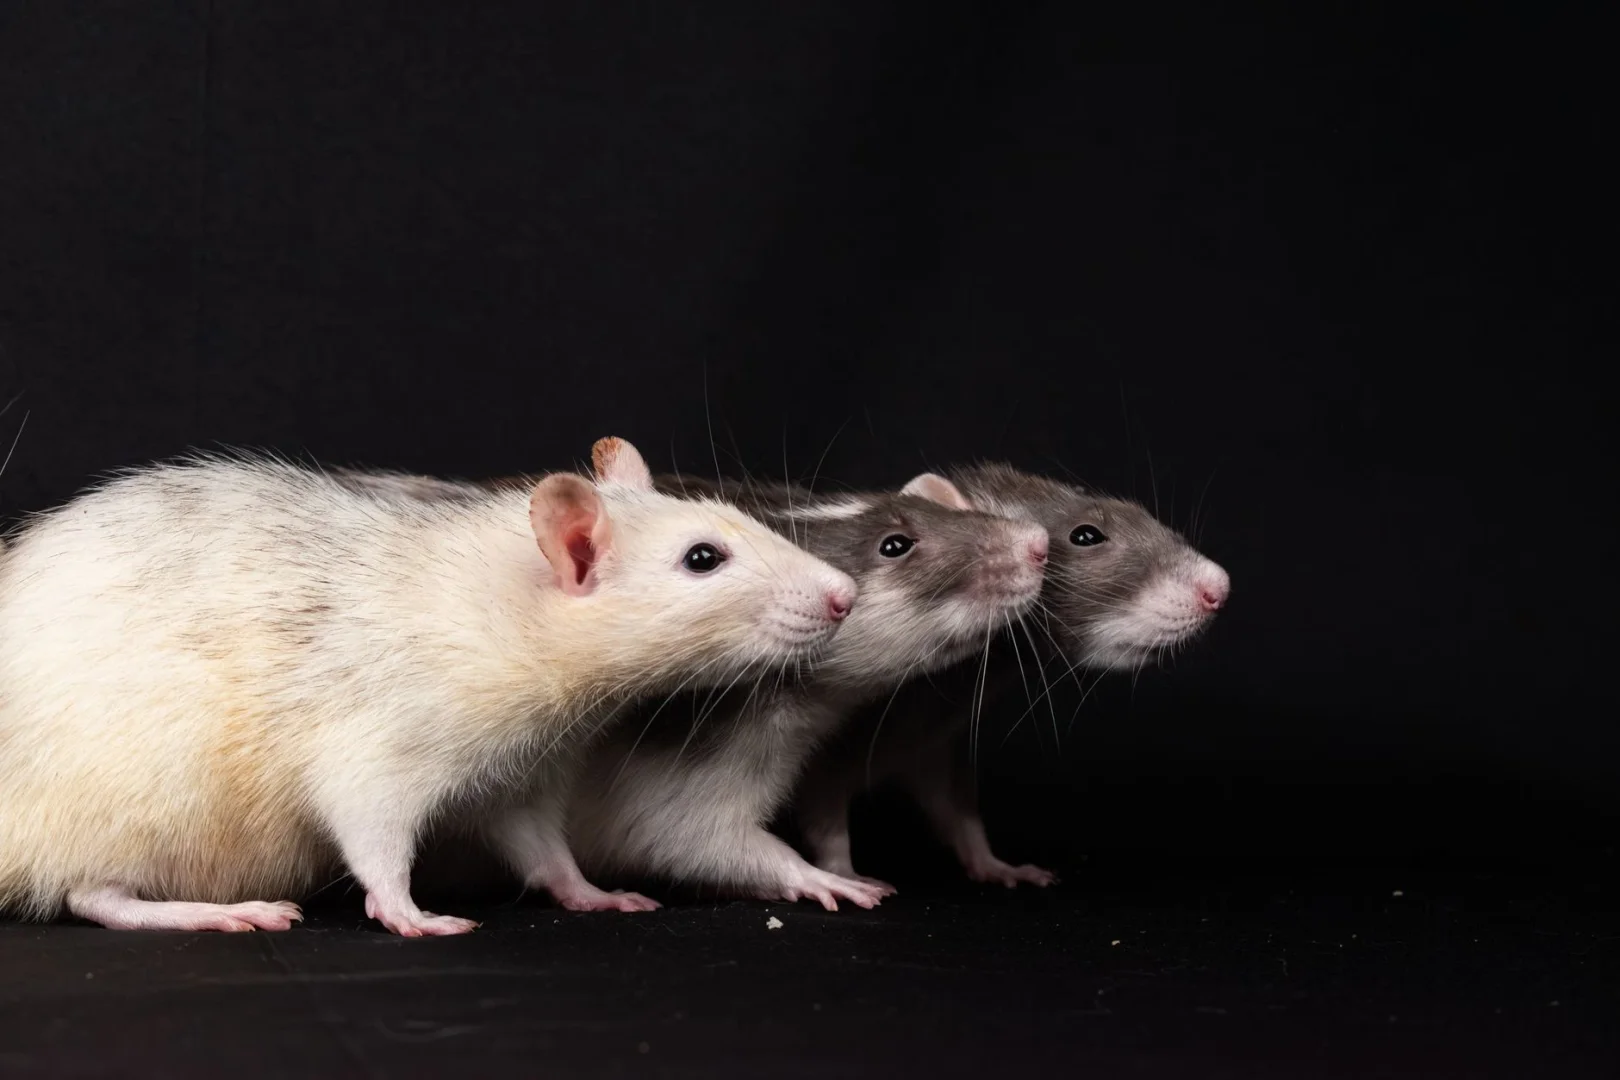
Чужой страх на своей карте: гиппокамп крысы помечает опасность, увиденную со стороны
Угол тротуара, обледеневший за ночь. Вы видите, как на нём поскальзывается незнакомец, и мозг ставит жирную зарубку: здесь опасно. Сами вы не падали, но карта места обновилась. Группа нейробиологов из Нидерландского института нейронаук под руководством Фредерика Мишона Линде проследила, как именно г
 Наука
5
мин
27.10.2026
Микроскоп с металинзой переключает фокус электрическим напряжением
Навести камеру одновременно на цветок у самого объектива и на горный хребет вдалеке невозможно — что-то обязательно останется размытым. С оптическими микроскопами та же беда: свет собирается в крошечное чёткое пятно, но лишь на одной глубине. Ткань чуть выше или ниже этого слоя выглядит мутной. Южно