Есть два файла: roster с метками групп и scores с баллами. Порядок строк разный; некоторые ID встречаются только в одном файле. Нужно соединить соответствующие записи по ключу, а затем отдельно проверить несовпадения. Покажем это на полностью вымышленных данных.
Разберём на учебном примере. Все данные вымышленные, они только показывают логику работы.
Исходные файлы
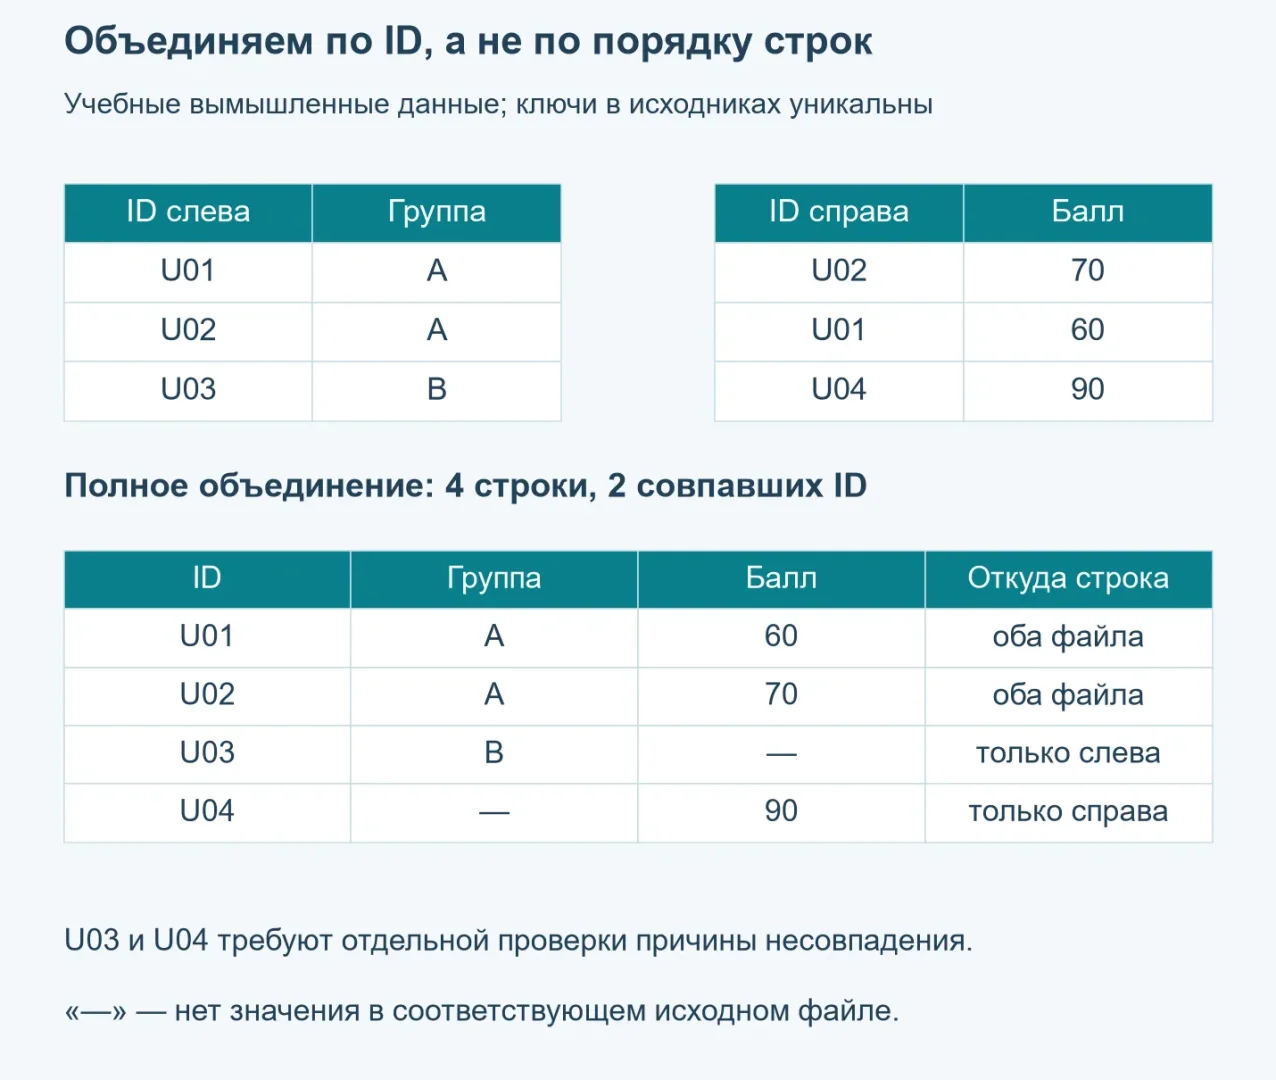
Слева — roster со столбцами id и group (метка группы), справа — scores со столбцами id и score (балл). Общий ключевой столбец называется id. В scores строки расположены иначе; U03 есть только слева, U04 только справа.
id
group
U01
A
U02
A
U03
B
Учебная схема, не скриншот программы. Данные вымышлены. Порядок строк исходников различается; значения сопоставлены по ID. Причины несовпадения U03 и U04 не заданы.
Таблица scores:
id
score
U02
70
U01
60
U04
90
Все ID уникальны внутри своего файла и не содержат пустых значений.
Что делает merge
merge — это функция pandas, которая объединяет два DataFrame по заданному столбцу (или столбцам), как операция JOIN в SQL. Её основные параметры:
on — имя столбца, по которому соединяем. Название должно быть одинаковым в обеих таблицах. Если не указать, pandas сам найдёт пересечение имён столбцов.
how — какой набор ключей оставить: left, right, inner или outer (полный).
indicator — если True, добавляет столбец _merge со статусом: both (есть в обеих таблицах), left_only (только в левой) или right_only (только в правой).
validate — проверяет уникальность ключей. Например, 'one_to_one' запрещает дубликаты в обеих таблицах.
Для этих файлов задаём on="id". Чтобы увидеть все несовпавшие ключи, в полном объединении используем how="outer", indicator=True, validate="one_to_one". Ниже отдельно показаны результаты left, inner и outer для исходных уникальных ключей.
Шаг за шагом: три варианта соединения
Левое соединение (how='left')
Сохраняет все строки из левой таблицы (roster). Если в scores нет ID из roster, в соответствующей ячейке score будет пропуск — NaN. Строка U04 из scores не попадёт в результат, потому что её нет в левой таблице.
Результат — 3 строки:
id
group
score
_merge
U01
A
60
both
U02
A
70
both
U03
B
NaN
left_only
Так мы видим, что U03 — участник из roster, у которого нет баллов в scores.
Внутреннее соединение (how='inner')
Оставляет только те строки, где ID есть в обеих таблицах. Пропадают U03 (нет в scores) и U04 (нет в roster). Остаются только общие участники.
Результат — 2 строки:
id
group
score
_merge
U01
A
60
both
U02
A
70
both
Внутреннее соединение не покажет несовпадения. Если ваша задача — проверить, кто выпал, inner не подходит.
Полное внешнее соединение (how='outer')
Сохраняет все ID из обеих таблиц. Пропуски появляются с обеих сторон: у U03 нет балла, у U04 нет группы.
Результат — 4 строки:
id
group
score
_merge
U01
A
60
both
U02
A
70
both
U03
B
NaN
left_only
U04
NaN
90
right_only
В этом примере outer позволяет сразу увидеть ID из обеих таблиц: совпавшие и встречающиеся только в одном файле.
Сравнение по числу строк
Для наглядности — сводка трёх способов:
Тип соединения
Число строк
Статусы (_merge)
left
3
2 both, 1 left_only
inner
2
2 both
outer
4
2 both, 1 left_only, 1 right_only
В этом наборе outer показывает все четыре различных ID и позволяет отдельно увидеть U03 и U04. Тип соединения выбирают по задаче, а не по принципу «чем больше строк, тем лучше».
Как проверить уникальность ключей: validate='one_to_one'
Внутри каждого исходного файла ключи не повторяются. Это не означает, что все ID есть в обоих файлах: U03 и U04 не совпали. Для проверки уникальности с обеих сторон в данном примере выбираем validate="one_to_one".
Рассмотрим отдельный сценарий: в scores добавлена строка U02 с баллом 75, а строка U02 с баллом 70 сохранена. При левом соединении how="left" без validate получится 4 строки: U01/60, U02/70, U02/75, U03/пропуск. Дважды встречается один ID U02; это не два новых участника. Число 4 относится именно к этому левому соединению, а не к любому вызову merge.
Если же добавить validate='one_to_one', pandas выбросит исключение ещё до выполнения слияния. Это защита от случайного дублирования — вы узнаете о проблеме сразу, а не после того, как результат уже пошёл в отчёт.
Кратность задают по структуре данных и исследовательской задаче. one_to_one проверяет уникальность в обоих файлах; one_to_many — только слева; many_to_one — только справа. many_to_many допускает соединение без проверки уникальности. Не заменяйте one_to_one на many_to_many только ради исчезновения ошибки: сначала установите, почему появился повтор и какой ключ действительно нужен.
Практический чек-лист перед объединением
Прежде чем вызвать merge, полезно проверить исходные данные:
Совпадает ли формат ID в обоих файлах? Нет ли лишних пробелов, разных регистров или типа (например, строка против числа).
Все ли ID уникальны в каждой таблице? Если нет, какая кратность и как её обрабатывать.
Нет ли пустых значений в ключевом столбце. pandas может сопоставлять пустые ключи между собой, что отличается от поведения SQL и может дать неожиданные строки.
Какой тип соединения вам нужен: сохранить все строки левой таблицы (left), только общие (inner) или полную картину (outer).
Нужна ли защита от дубликатов — добавьте validate.
В учебном наборе причины отсутствия U03 в scores и U04 в roster не заданы. Статус _merge сообщает только, в каком исходном файле найден ключ. Он не доказывает отказ от участия, потерю данных или ошибку ввода. Для реальных файлов сверяют версии, правила отбора и документацию.
Чего не стоит делать: переставлять строки вручную в надежде, что порядок совпадёт, или связывать записи по похожему имени, если ID разные. merge работает строго по значениям ключа, и это его главное преимущество.
Дополнительные замечания
Если вы соединяете таблицы, в которых нет общих названий столбцов, используйте параметры left_on и right_on — можно указать разные имена. Если ключ находится в индексе, пригодится left_index=True или right_index=True.
Если нужна консультация по структуре собственного файла и проверке объединения, можно обсудить статистическую обработку данных. Заранее уточните задачу, состав таблиц и объём консультации.