


Содержание статьи
Вопросы студентов
24.10.2026
24.10.2026
8
мин
Допустим, для курсовой нужно понять, помогают ли короткие перерывы в учёбе запоминать материал. Один запрос в поисковике выдаёт статьи, обзоры и страницы, похожие по словам, но не всегда отвечающие на вопрос. Нейросетевые сервисы могут искать публикации по смыслу и кратко пересказывать их. Однако для разных задач подходят разные инструменты, а найденные выводы всё равно нужно сверять с самими статьями.
Ниже сравниваются три сервиса с функциями на основе искусственного интеллекта: Elicit, Consensus и Semantic Scholar. Для ориентира добавлен Google Scholar, который полезен для академического поиска, но в предоставленной справке не описан как нейросетевой сервис. Сравнение основано на документации разработчиков, а не на независимом тестировании точности или скорости. Числа о размере баз и устройстве поиска приводятся со слов самих сервисов.
Какой сервис выбрать
| Сервис | Что делает | Подойдёт, если | Что учитывать |
|---|---|---|---|
| Elicit | Ищет научные публикации по смысловому сходству с запросом и позволяет уточнять отбор с помощью вопросов. | Нужно начать обзор литературы и быстро собрать работы по конкретному исследовательскому вопросу. | Разработчик сообщает о корпусе более чем из 138 млн публикаций из Semantic Scholar, PubMed и OpenAlex, обновляемом еженедельно. Книги, диссертации и ненаучные материалы в него не входят. Бесплатный план включает неограниченный поиск, но использование исследовательского агента и отчётов ограничено. |
| Consensus | Сочетает смысловой поиск с поиском точных ключевых слов; формирует ответы и краткие обобщения со ссылками на публикации. | Нужно быстро сориентироваться в исследованиях по вопросу и перейти к источникам. | В описании 2025 года заявлен корпус более чем из 200 млн научных документов, преимущественно рецензируемых журнальных статей, а также некоторых материалов конференций и препринтов. Краткий ответ может неверно передать содержание статьи. Политика конфиденциальности сообщает, что текст запросов и загруженных документов обрабатывается для выдачи результата; часть обработки выполняют внешние поставщики моделей, а серверы находятся в США. |
| Semantic Scholar | Ищет публикации, показывает связи между работами, предлагает инструменты для чтения и рекомендации новых статей. | Нужно найти связанные исследования, отслеживать новые публикации или читать отдельные статьи с подсказками. | Сервис преимущественно ориентирован на публикации на английском языке. Генеративные функции могут ошибаться. Semantic Reader доступен для многих статей arXiv, а подсветка ключевых фрагментов, по документации, работает на ограниченном наборе англоязычных статей по компьютерным наукам. |
| Google Scholar | Ищет научную литературу, показывает версии статей, ссылки «Цитируется» и «Похожие статьи», позволяет сортировать результаты по дате и создавать уведомления. | Нужно расширить поиск, найти более ранние и поздние работы или проверить доступные версии статьи. | Это академический поисковик, а не нейросетевой сервис в описании справки. Для одного запроса отображается не более 1 000 результатов. |
Не стоит выбирать сервис только по заявленному размеру базы. Важнее, есть ли в ней нужная область и язык публикаций, удобно ли проверять найденные записи и можно ли получить полный текст. Доступность сервисов и отдельных функций в России, а также совместимость со всеми операционными системами здесь не установлены. Перед использованием проверьте, открывается ли сайт и работает ли нужная функция на вашем устройстве.
Как применить поиск на практике
Возьмём условную задачу студента: «Как короткие перерывы влияют на запоминание учебного материала у студентов?» Это пример формулировки, а не описание проведённого исследования.
- Сузьте вопрос. Уточните, что именно хотите узнать: краткосрочное запоминание, результаты экзамена или влияние длительности перерыва. Чем конкретнее вопрос, тем проще оценить релевантность результатов.
- Сформулируйте запрос. В Elicit и Consensus можно начать с обычного вопроса на естественном языке. Попробуйте также ключевые слова, например «перерывы», «запоминание», «студенты», «обучение». Для международной литературы подготовьте английские эквиваленты терминов: такие системы преимущественно ориентированы на англоязычные публикации.
- Сравните результаты в двух сервисах. Если один инструмент показывает мало подходящих работ, другой может подсказать новые формулировки или публикации. Это не доказывает, что второй поиск полнее: базы и способы ранжирования различаются.
- Откройте первоисточники. Проверьте название, авторов, год, журнал и аннотацию. Уточните, изучали ли авторы студентов, что считали перерывом и как измеряли запоминание. Не переносите формулировку из краткого ответа сервиса в свою работу как подтверждённый вывод.
- Расширьте поиск. В Google Scholar найдите похожие работы и публикации, которые цитируют уже найденную статью. В Semantic Scholar можно просмотреть связи между публикациями и настроить рекомендации по сохранённым материалам.
- Сохраните записи. Зафиксируйте библиографические данные, ссылку и заметку о том, почему статья подходит. Для управления источниками можно выбрать отдельный библиографический менеджер. Как сопоставить такие программы, рассказано в материале «Zotero или Mendeley: что выбрать студенту и исследователю».
Для систематического обзора одного нейросетевого поиска недостаточно. Elicit прямо указывает, что такой поиск может дополнять протокол систематического обзора; пробелы в региональном охвате и серой литературе требуют дополнительных поисков. Проверьте требования кафедры или вуза к базам данных, описанию стратегии поиска и использованию ИИ: такие правила могут различаться.
Когда не стоит загружать учебные файлы
Перед загрузкой текста курсовой, неопубликованного исследования или материалов с персональными данными прочитайте политику конфиденциальности сервиса. Например, в политике Consensus от 18 августа 2026 года говорится, что текст загружаемых документов обрабатывается, а часть обработки выполняют внешние поставщики моделей. Там же указано, что серверы находятся в США. Эти сведения сами по себе не позволяют заключить, соответствует ли использование сервиса правилам конкретного вуза. Если сомневаетесь, не загружайте файл и ограничьтесь открытым запросом без личных или закрытых данных.
Типичные ошибки
- Считать пересказ доказательством. ИИ может неверно понять даже реальную статью. Проверяйте, подтверждает ли первоисточник нужный вывод и при каких условиях.
- Считать найденную выдачу полным обзором. Поиск ограничен составом базы, индексированием и алгоритмом ранжирования. Для важной работы повторите поиск в других подходящих источниках.
- Полагаться только на размер корпуса. Миллионы записей не гарантируют, что в выдаче будут нужный язык, регион или специальная литература.
- Цитировать по карточке или сгенерированному ответу. Сверьте метаданные и формулировку цитируемого тезиса по статье.
- Загружать файлы, не прочитав условия. Уточните, как обрабатываются запросы и документы, особенно если в них есть персональные данные или неопубликованные материалы.
Если после первичного поиска нужно собрать источники для литературного обзора, полезно отдельно продумать стратегию и критерии отбора. С этим связан материал о генеративных ИИ-инструментах для поиска и анализа литературы. А если требуется помощь именно с подбором научных публикаций, можно посмотреть условия услуги подбора литературы.
Практичный вариант для начала: сформулировать узкий вопрос, проверить его в Elicit или Consensus, затем просмотреть первоисточники и расширить выдачу через Semantic Scholar или Google Scholar. Нейросеть помогает быстрее наметить маршрут по литературе, но решение о том, что статья действительно подтверждает, остаётся за читателем.
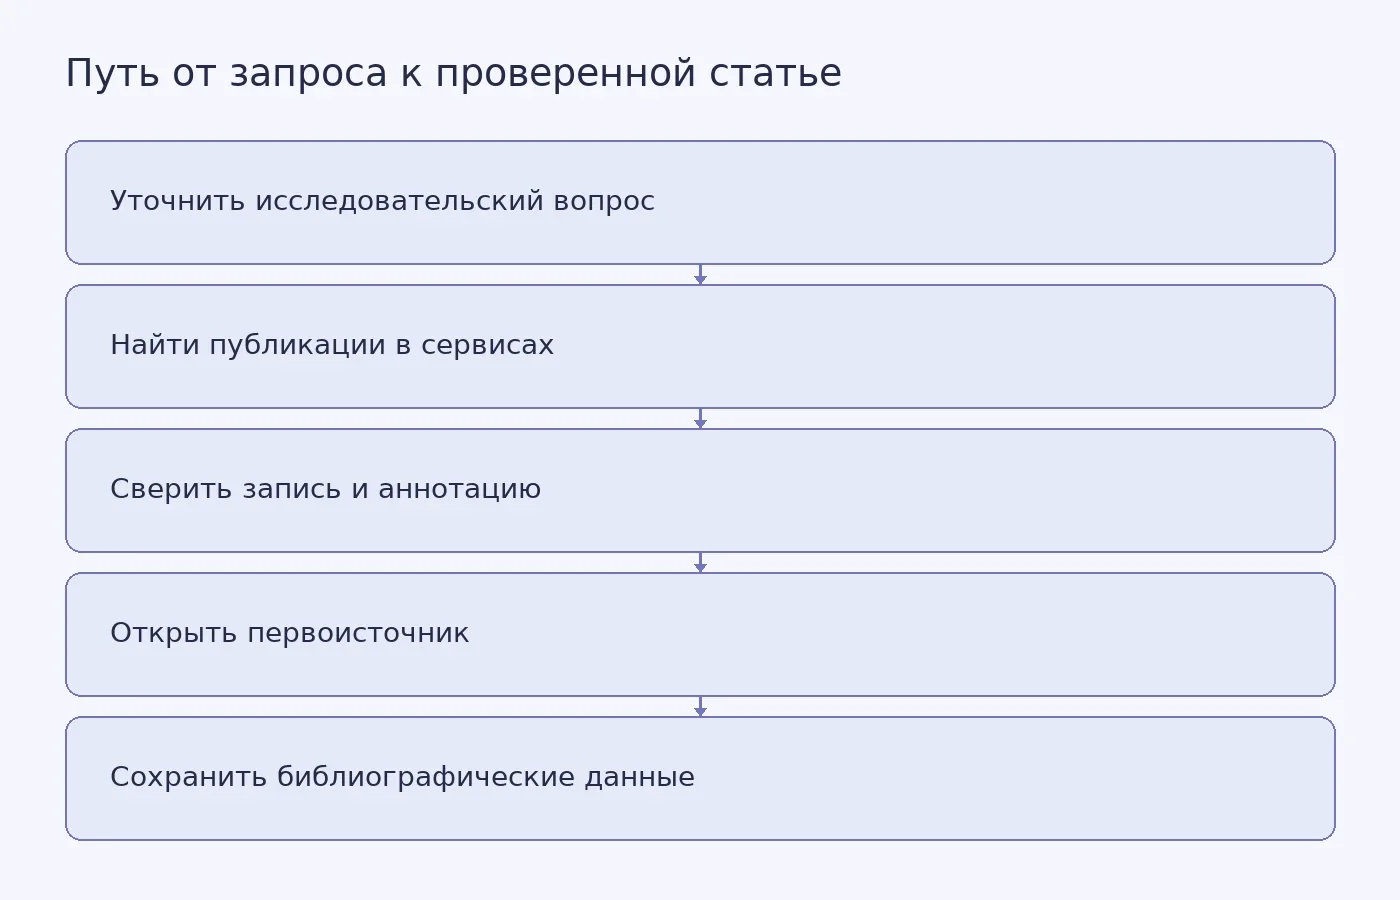
Фото: ANTONI SHKRABA production / Pexels


Похожие статьи
 Вопросы студентов
12
мин
24.10.2026
Лучшие нейросети для учебы: сравнение на учебных задачах
Перед зачётом нужно повторить лекцию на сорок страниц. Один сервис может объяснить непонятный абзац, другой — собрать вопросы для самопроверки, третий — помочь разобраться с материалом, который уже хранится в рабочем пространстве. Поэтому выбирать нейросеть для учёбы удобнее не по месту в рейтинге,
 Вопросы студентов
11
мин
24.10.2026
Приложения для записи лекций: сравнение диктофонов и конспектов
В шумной аудитории студенту приходится выбирать: включить диктофон и переслушать лекцию позже или вести конспект по ходу занятия, отмечая формулы, термины и вопросы. Приложение сохраняет речь, а не заменяет записи от руки: в них можно сразу выделить важное и отметить непонятное.Ниже сравниваются Goo
 Вопросы студентов
5
мин
14.10.2026
Google Scholar: как искать статьи, отслеживать цитирования и экспортировать записи
Вы нашли статью о связи сна и успеваемости студентов. Теперь хочется понять, кто цитировал эту работу, какие исследования похожи на неё и как сохранить библиографические данные. Google Scholar помогает пройти этот путь, но сведения из поиска и экспорта стоит сверять с самой публикацией. Поиск по наз
 Вопросы студентов
7
мин
06.03.2023
10411
Как стать рецензентом научных статей?
Рецензент – это специалист, обладающий необходимым уровнем теоретических/практических знаний в научной отрасли по направлению исследований автора рассматриваемой диссертационной работы. Для составления объективной рецензии, внутренний/внешний рецензент обязан владеть информацией о современны
 Вопросы студентов
6
мин
19.10.2026
Приложения для студентов-юристов: сравнение КонсультантПлюс и ГАРАНТ
На семинаре нужно быстро найти норму о защите прав потребителей, а при подготовке курсовой важно понять, где искать документ и как проверить его редакцию. В таких ситуациях могут пригодиться правовые приложения. По описаниям разработчиков и карточкам магазинов сравним два варианта: «КонсультантПлюс:
 Вопросы студентов
9
мин
24.10.2026
Нейросеть для конспектов: сравнение сервисов для текста, аудио и видео
У студента могут быть сразу три источника: PDF с лекцией, аудиозапись занятия и ссылка на видео. Нейросеть поможет сделать по ним заметки, но способы работы у сервисов разные. Одни расшифровывают речь, другие отвечают по загруженным материалам, третьи составляют краткий пересказ встречи. Ниже сопост
Последние новости и статьи
 Наука
2
мин
24.10.2026
Нейральные стволовые клетки пропускали псевдовирус SARS-CoV-2
Нейральные стволовые клетки человека в лабораторной культуре пропускали псевдочастицы с шиповидным белком SARS-CoV-2, в том числе вариантов Omicron BA.1 и BA.2. К такому выводу пришли учёные Калифорнийского университета в Риверсайде в исследовании, опубликованном 21 октября 2026 года в журнале PLOS
 Наука
3
мин
24.10.2026
Уязвимый нарциссизм связали с трудностями управления эмоциями
Метаанализ 26 исследований с участием 12 209 взрослых выявил умеренную связь уязвимого нарциссизма с трудностями регуляции эмоций. Для грандиозного нарциссизма статистически значимой связи не обнаружили. Результаты работы австралийских исследователей Рии Тзилиаскопулос, Роуз Фергюсон, Венди Сонг и М
 Вузы
2
мин
24.10.2026
Межвузовский кампус в Уфе планируют полностью запустить в 2027 году
Межвузовский кампус Евразийского научно-образовательного центра в Уфе планируют полностью запустить в 2027 году. Вторую очередь власти Башкортостана рассчитывают достроить до конца 2026-го. Об этом глава республики Радий Хабиров рассказал «Российской газете» 24 октября 2026 года.Что уже работает и ч
 Вопросы студентов
9
мин
24.10.2026
Приложения для перевода учебных текстов: Google Translate, DeepL и Microsoft
В научной статье одно слово способно изменить смысл целого абзаца. Поэтому при выборе переводчика важно смотреть не только на скорость, но и на работу с PDF, терминами и загружаемыми файлами. Ниже сопоставлены функции, описанные в официальных материалах Google, DeepL и Microsoft. Независимых испытан
 Вопросы студентов
10
мин
24.10.2026
Приложения для запоминания английских слов по карточкам: Anki, Noji и Brainscape
На одной стороне карточки появляется английское слово. Сначала вы пытаетесь вспомнить перевод, затем открываете ответ и проверяете себя. Такой подход заставляет не перечитывать список, а извлекать нужное слово из памяти. Приложения работают с карточками по-разному: где-то можно подробно настроить по
 Вопросы студентов
15
мин
24.10.2026
Лучшие приложения для изучения английского студенту: сравнение Duolingo, Busuu и Anki
Студенту редко нужно просто «учить английский». Обычно задача конкретнее: разобрать термины перед семинаром, не забыть лексику к зачёту, потренировать короткие фразы или привыкнуть заниматься хотя бы по десять минут между парами. Поэтому одного универсального победителя здесь нет. Приложение для еже