Диск заполнен на 51%, и мониторинг будит дежурного. Но свободного места хватит еще на месяц. В другом сервисе мониторинг собирает тысячи инфраструктурных метрик, но не замечает, что пользователи перестали оплачивать заказы.
С этого несовпадения технического состояния и пользовательского результата начинается русскоязычный инженерный разбор на Хабре, опубликованный автором RukInDaHouse. Это практический туториал, а не исследовательская работа. Автор предлагает методику настройки алертинга и сопоставляет ее с руководствами Google SRE, AWS и описанием платформы LinkedIn.
Вопрос не сводится к выбору числового порога. Нужно решить, какое изменение требует немедленно прервать работу или сон человека, какое следует оформить как задачу, а какое достаточно оставить на дашборде. Сопоставленные документы хорошо объясняют устройство этой практики, но не доказывают, что переход на такой подход всегда уменьшает простой или профессиональное выгорание на определенный процент: в источниках нет выборки команд, случайного распределения и статистического сравнения двух систем алертинга.
Почему исправная метрика еще не является сигналом
Инфраструктурная метрика отвечает на локальный вопрос. Она показывает загрузку процессора, число перезапусков контейнера, заполнение диска, задержку очереди или количество отказавших узлов. Пользователь взаимодействует не с узлом и не с очередью. Он ищет товар, добавляет его в корзину, оплачивает заказ и ждет подтверждения.
Отказ одного узла может быть скрыт резервированием. И наоборот, множество внутренних показателей могут оставаться в привычных пределах, хотя цепочка оплаты уже нарушена. Поэтому Роб Эващук, автор главы «Мониторинг распределенных систем», отредактированной Бетси Бейер, предлагает для срочных вызовов прежде всего отслеживать симптомы, заметные пользователю. Показатели возможных причин нужны главным образом для диагностики.
Проверочный вопрос Google звучит так: обнаруживает ли правило ранее не замеченное состояние, которое «срочно, требует действия и уже заметно пользователю либо неизбежно станет заметным»? Необычное значение само по себе недостаточно. Состояние должно угрожать пользовательскому результату, требовать быстрого ответа и допускать осмысленное действие.
Инфраструктурные показатели от этого не становятся бесполезными. Они помогают искать причину и иногда сами оправдывают срочный вызов. В книге Google приведен пример прогноза: диск базы данных заполнится через четыре часа. Это еще не пользовательский отказ, но угроза достаточно близкая и определенная. Такая метрика описывает уже не только процент заполнения, а время до ожидаемого ущерба.
Сначала сценарий, затем SLI и SLO
Стивен Тергуд, Дэвид Фергюсон, Алекс Идальго и Бетси Бейер в главе «Внедрение SLO» предлагают начинать с определения пользователей, их обычных задач и критичных действий. Для интернет-магазина это могут быть поиск товара, добавление его в корзину и завершение покупки. Сначала нужно понять, что важно пользователю, и только потом решать, как это измерять.
Если команда выбрала оплату заказа, ей нужно определить валидную попытку оплаты, успешный исход, исключения для тестов и отмен, источник данных и допустимую задержку подтверждения.
Из этого получается индикатор уровня обслуживания, SLI. Google рекомендует по возможности выражать его как отношение хороших событий ко всем событиям. Например, число успешно подтвержденных оплат можно разделить на число валидных попыток. Такая запись ближе к пользовательскому результату, чем загрузка процессора платежного сервиса.
Целевой уровень обслуживания, SLO, задает приемлемое значение SLI за выбранный период. При SLO 99,9% допустимая доля плохих событий составляет 0,1%. Это бюджет ошибок. Если за период было три миллиона операций, такой SLO допускает три тысячи неуспешных операций. Сбой с 1500 ошибками израсходует половину бюджета.
У измерения всегда есть границы. Серверный журнал не видит запросы, которые не дошли до сервера. Синтетическая проверка охватывает только заранее запрограммированные пути. Клиентская телеметрия лучше замечает опыт реальных пользователей, но требует изменения приложения и отдельной системы сбора. Авторы Google прямо пишут, что одна спецификация SLI может иметь несколько реализаций, различающихся точностью, охватом и стоимостью.
Что показывает скорость расходования бюджета
Обычный порог сообщает, что доля ошибок превысила выбранное значение. Скорость расходования бюджета ошибок, или burn rate, отвечает на более полезный для дежурства вопрос: как быстро при нынешнем ухудшении закончится допустимый запас ошибок.
В главе «Алертинг по SLO» Google рассматривает сервис с SLO 99,9% за 30 дней. Burn rate 1 означает 0,1% ошибок и расход всего бюджета за 30 дней. Burn rate 10 означает 1% ошибок и исчерпание бюджета примерно за три дня. Burn rate 1000 означает полный отказ и исчерпание бюджета примерно за 43 минуты.
Для SLO 99,9% авторы предлагают как отправную точку многооконную конфигурацию:
срочный вызов при burn rate 14,4 на длинном окне в один час и коротком окне в пять минут. Это соответствует расходованию 2% бюджета;
второй уровень вызова при burn rate 6 на окнах шесть часов и 30 минут. Это соответствует 5% бюджета;
задача при burn rate 1 на окнах три дня и шесть часов, когда израсходовано 10% бюджета.
Длинное окно проверяет общий масштаб расхода, короткое подтверждает, что ухудшение продолжается сейчас. После восстановления короткое окно быстрее возвращается к норме, поэтому уведомление не остается активным еще несколько часов только из-за старых ошибок.
Эти числа не являются универсальным стандартом. Google называет их отправной точкой. Конфигурацию нужно согласовывать с целевым SLO, объемом трафика, ценой отдельной ошибки, графиком дежурства и временем, которое действительно требуется для вмешательства.
Когда одна ошибка выглядит как катастрофа
При малом трафике доля ошибок становится нестабильной. Google приводит пример: сервис получает десять запросов в час, один из них завершается неудачно. Часовая доля ошибок равна 10%. Для SLO 99,9% это дает burn rate 1000 и расходует 13,9% месячного бюджета. Правило немедленно вызовет дежурного, хотя единичный сбой мог быть случайным и не повториться.
Универсального фильтра здесь нет. Если каждый запрос связан с крупным платежом и не повторяется, расследование одной ошибки может быть оправдано. Если запрос автоматически повторяется и пользователь не замечает первого отказа, такой вызов, вероятно, окажется чрезмерным.
Google перечисляет несколько вариантов для низкотрафиковых сервисов: генерировать синтетический трафик, объединять связанные сервисы, снижать влияние единичного отказа с помощью повторов или резервного пути, а также пересматривать SLO. У каждого решения есть цена. Синтетические проверки покрывают только часть состояний. Объединение сервисов может скрыть полный отказ небольшого компонента. Смягчение SLO является продуктовым решением, а не косметической правкой мониторинга.
Четыре разных назначения одного наблюдения
Разделить срочный вызов, задачу, дашборд и автоматическое действие можно с помощью вопросов из руководства Google: может ли получатель что-то сделать, нужно ли это сделать сейчас или можно дождаться утра, безопасно ли автоматизировать реакцию, устраняет ли действие причину или только временно скрывает симптом.
Срочный вызов дежурного нужен, когда влияние уже возникло или неизбежно, промедление увеличивает ущерб, а получатель способен предпринять осмысленное действие. Google формулирует требование так: «Каждый срочный вызов должен допускать действие. Ответ на него должен требовать профессионального решения. Если достаточно механической реакции, это не должно быть срочным вызовом».
Задача подходит для реальной проблемы, которую нельзя оставлять без исправления, но можно разобрать в следующий рабочий период. В терминах бюджета ошибок это устойчивое ухудшение, которое пока не угрожает исчерпать бюджет за часы.
Дашборд или журнал нужен для субкритических состояний, трендов и диагностического контекста. Google определяет дашборд как заранее собранное представление основных метрик сервиса. Авторы советуют выводить туда текущие несрочные проблемы вместо потока электронных писем, который быстро превращается в шум.
Автоматическое действие уместно, если ответ повторяем, детерминирован и безопасен. Перезапуск зависшего процесса не стоит каждый раз поручать человеку, если система может выполнить его сама и сохранить запись о результате. Автоматизация не отменяет последующую работу с причиной регулярно возникающего сбоя.
Цена неправильной классификации не ограничивается раздражением. Роб Эващук пишет, что частые вызовы заставляют сотрудников перепроверять, бегло просматривать или игнорировать уведомления. Настоящая авария может затеряться среди шума, а диагностика затянуться.
Аномалия бизнес-метрики не равна техническому инциденту
Рекомендация AWS Well-Architected OPS08-BP04 советует связывать алерты с ключевыми показателями результата, чтобы сигнал отражал деловое или операционное влияние. AWS отдельно называет избыток некритичных уведомлений и отсутствие приоритизации по таким показателям типичными ошибками.
Но падение числа заказов еще не доказывает технический сбой. На показатель влияют время суток, праздники, рекламные кампании, изменения спроса и продуктовые эксперименты. Даже статистически необычное значение не определяет срочность автоматически.
Эту границу показывает описание платформы ThirdEye, опубликованное инженером LinkedIn Сяохуэй Сунем 3 июня 2019 года. Автор пишет, что бизнес-метрики различаются по временному масштабу, сезонности, трендам и числу измерений, поэтому одного алгоритма для них нет.
В ThirdEye обнаружение аномалии отделено от доставки уведомления. Система может отфильтровать малые срезы, выбрать подходящий алгоритм, убрать незначительные изменения и объединить близкие эпизоды. После этого отдельные правила определяют получателей, частоту и канал: электронную почту, SMS или телефонный вызов.
Получается два разных вопроса. Детектор отвечает: «Произошло ли необычное изменение?» Политика реагирования отвечает: «Кому, когда и каким способом об этом сообщить?» Неожиданно высокая выручка может быть аномалией, но обычно не требует ночного звонка. Падение конверсии может требовать его лишь при достаточном трафике, свежих данных и подтвержденном влиянии на критичный сценарий.
Google для критического пути к дежурному предпочитает простые, понятные и надежные правила и предостерегает от систем, которые автоматически изучают пороги или причинность. LinkedIn описывает применение метода Холта и Винтерса и методов машинного обучения для неоднородных бизнес-рядов. Прямого противоречия здесь нет: сложная модель может искать кандидатов на аномалию, но решение разбудить человека требует отдельного и проверяемого правила срочности.
Почему подавление сигналов тоже опасно
Один сбой базы данных может одновременно вызвать ошибки приложения, задержку платежей и рост очереди. Без группировки несколько команд получат разные вызовы об одном происшествии. Агрегация и подавление зависимых сигналов сокращают такие дубли.
Однако сложная карта зависимостей быстро устаревает. Google сообщает лишь об ограниченном успехе таких иерархий и применяет их главным образом к стабильным частям инфраструктуры. Слишком широкое подавление может скрыть независимый сбой, который случайно возник одновременно с основной аварией.
Поэтому симптом пользовательского уровня не стоит удалять из картины. Если вызов создан по известной инфраструктурной причине, в нем все равно полезно показать, какие пользовательские сценарии пострадали. Тогда подавление уменьшает число уведомлений, но не стирает информацию о воздействии.
Что подтверждают источники
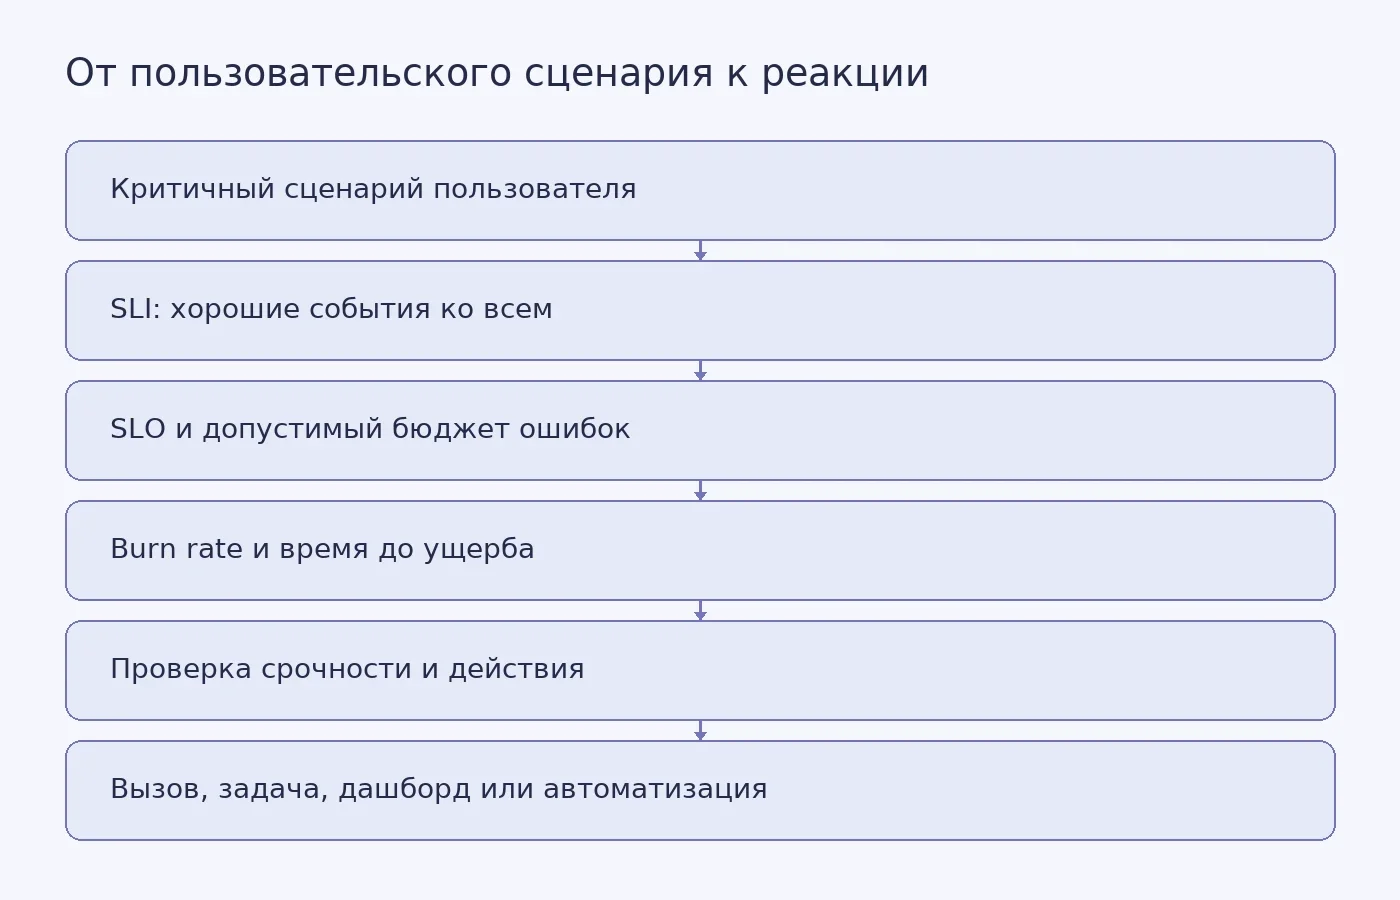
Сопоставленные документы поддерживают такую последовательность:
Выбрать критичный пользовательский сценарий.
Определить хорошее и плохое событие.
Выбрать SLI и согласовать SLO.
Рассчитать бюджет ошибок и скорость его расходования.
Проверить срочность, возможность действия и близость пользовательского ущерба.
Назначить выход: срочный вызов, задача, дашборд или автоматическая реакция.
Добавить инфраструктурные данные для диагностики и прогноза неизбежных отказов.
Это вывод авторов инженерных руководств и описаний систем. Наша интерпретация состоит в том, что бюджет ошибок нужен не как еще одна метрика на панели. Он служит общим масштабом срочности: переводит долю неудачных операций в оценку того, сколько времени остается до нарушения согласованной надежности.
Убедительность подхода основана на согласованности рекомендаций нескольких крупных инженерных организаций и на прозрачных расчетах burn rate. Предел тоже ясен. Источники не сравнивали случайным образом команды с пользовательским и инфраструктурным алертингом, не приводили общей выборки инцидентов и не оценивали причинный эффект на время восстановления или здоровье сотрудников. Производственный опыт полезен для проектирования, но не равен универсальному экспериментальному доказательству.
Практический критерий можно свести к одной проверке. Если ожидание до следующего рабочего периода заметно увеличит пользовательский ущерб, а получатель способен немедленно выполнить осмысленное действие, нужен вызов дежурного. Если проблема реальна, но время есть, нужна задача. Если наблюдение помогает понять состояние или найти причину, но не требует действия, ему место на дашборде или в журнале. Порог появляется только после этого решения, а не вместо него.