


Содержание статьи
Магистерские диссертации
03.11.2026
03.11.2026
7
мин
На тысячу обращений в приёмное отделение алгоритм отметил 121 как требующее дополнительной оценки. В 23 случаях в больничных записях появлялся код, связанный с суицидальным поведением, в течение следующих 30 дней. Ещё у 98 отмеченных обращений такого кода не было. Эти числа описывают ретроспективную проверку данных одной американской больницы, а не работу уже внедрённой системы.
Показатель «23 на тысячу» в статье Scientific Reports читается именно так. Он не означает, что модель обнаружила 23 подтверждённые попытки самоубийства или предотвратила 23 трагедии. Авторы предсказывали событие, зарегистрированное в медицинских записях в течение 30 дней после обращения, а не диагностировали острый кризис при поступлении.
Что считали результатом
Тшолофело Мокхелели, Тебого Макаба, Патрик Ндайизигизамие и Номпумело Ндлову обучили и сравнили пять моделей машинного обучения на данных MIMIC-IV. В анализ вошли 204 470 обращений в отделение неотложной помощи, они соответствовали 106 714 пациентам. Исход определяли по диагностическим кодам МКБ-9 и МКБ-10, среди которых были коды самоповреждения, суицидальных мыслей и попытки самоубийства. Поэтому зарегистрированный исход здесь шире, чем только попытка.
На независимой тестовой выборке модель LightGBM показала чувствительность 0,79: она обнаруживала примерно 79% обращений, связанных с позднее зарегистрированным исходом. Площадь под кривой «точность-полнота» составила 0,25. В статье это один из нескольких показателей качества, а не доказательство готовности алгоритма к клиническому применению.
Порог, при котором модель ставила отметку риска, выбирали на валидационных данных. Число тревог зависит не только от алгоритма, но и от порога. Если его снизить, система обычно отмечает больше людей и пропускает меньше исходов, но растёт число ложноположительных сигналов. Повышение порога даёт обратный компромисс.
Сколько сигналов не подтверждалось кодами
В пересчёте, приведённом в сообщении University of Johannesburg, на тысячу обращений приходился 121 сигнал. Из них 23 сопровождались зарегистрированным исходом в течение 30 дней, а 98 не сопровождались. Примерно четыре из пяти отмеченных обращений не имели соответствующего кода в записях этой больницы за заданный период.
Это не доказывает, что у этих людей не было риска. «Ложноположительный» в данном анализе означает отсутствие нужного кода в конкретной медицинской системе и в пределах 30 дней. Событие могло не попасть в записи этой больницы, а само определение исхода зависит от того, как кодируют медицинские случаи. Корректнее говорить о 98 сигналах без зарегистрированного исхода, а не о 98 людях, которые точно не нуждались в помощи.
Модель также пропускала часть исходов: пресс-релиз приводит округлённую оценку около 13 пропущенных случаев на тысячу обращений. Поэтому снижение числа лишних проверок нельзя рассматривать отдельно от риска не отметить человека, у которого позднее появится зарегистрированный исход.
Если бы каждый сигнал требовал отдельной проверки, 121 отметка на тысячу обращений означала бы заметный поток дополнительной оценки. Но исследование не измеряло, сколько минут или часов заняла бы такая работа, как врачи реагировали бы на сигналы и изменились бы клинические решения. Это оценка потенциальной нагрузки по числу отметок, а не фактический замер нагрузки на персонал.
Почему цифры нельзя переносить прямо в клинику
Авторы использовали данные одного медицинского центра в США. В тестовой части было 41 202 обращения и 21 343 уникальных пациента. Разделение на обучающую, валидационную и тестовую части проводили по пациентам, чтобы обращения одного человека не попадали одновременно в разные выборки. Это усиливает внутреннюю проверку модели, но не заменяет проверку в другой больнице.
Для ЮАР это ограничение особенно существенно: опубликованное исследование не обучало и не проверяло модель на южноафриканских пациентах. Распространённость диагнозов, доступность медицинской истории, порядок кодирования и состав пациентов могут отличаться. Даже если в больницах собирают похожие показатели давления, пульса и возраста, это не гарантирует, что модель будет столь же точной или создаст сопоставимое число тревог.
Данные ретроспективны. Авторы оценивают, насколько хорошо алгоритм разделяет записи с зарегистрированным исходом и без него, но не проверяют, улучшает ли его использование помощь пациентам. В статье прямо отмечена необходимость внешней проверки и перспективных исследований, то есть тестирования модели в реальной работе до выводов о её клинической пользе.
Поэтому показатель 23 из 121 полезен прежде всего как иллюстрация компромисса: модель может выделить группу для дополнительного внимания, но значительная часть сигналов не подтверждается выбранным кодовым исходом, а некоторые зарегистрированные исходы остаются незамеченными. Для оценки подобных результатов важно различать качество предсказания, клиническую пользу и то, как именно определён исход. Подробнее о том, что означает достоверность исследования, можно прочитать в отдельном материале.
Источники
- Mokheleli T., Makaba T., Ndayizigamiye P., Ndlovu N. Artificial intelligence approach for predicting suicide-related behaviour in emergency departments. Scientific Reports, 2026. Рецензируемая статья, открытый доступ; полный текст PDF.
- University of Johannesburg. Promising AI-based approach to early detection of suicide-related behavior at emergency rooms. Medical Xpress, 28 октября 2026 года. Пресс-релиз с округлённым пересчётом ошибок на тысячу обращений.
Источники и литература
- Promising AI-based approach to early detection of suicide-related behavior at emergency rooms — пресс-релиз; доступный текст страницы
- Artificial intelligence approach for predicting suicide-related behaviour in emergency departments | Scientific Reports — рецензируемая публикация; аннотация или страница публикации
- Promising AI-based approach to early detection of suicide-related behavior at emergency rooms — тип публикации не установлен; полный текст PDF
- Researchers develop machine learning models that could improve suicide-risk prediction among children — тип публикации не установлен; доступный текст страницы
- Researchers design machine learning models to better predict adolescent suicide and self-harm risk — тип публикации не установлен; доступный текст страницы
- PDF — рецензируемая публикация; полный текст PDF
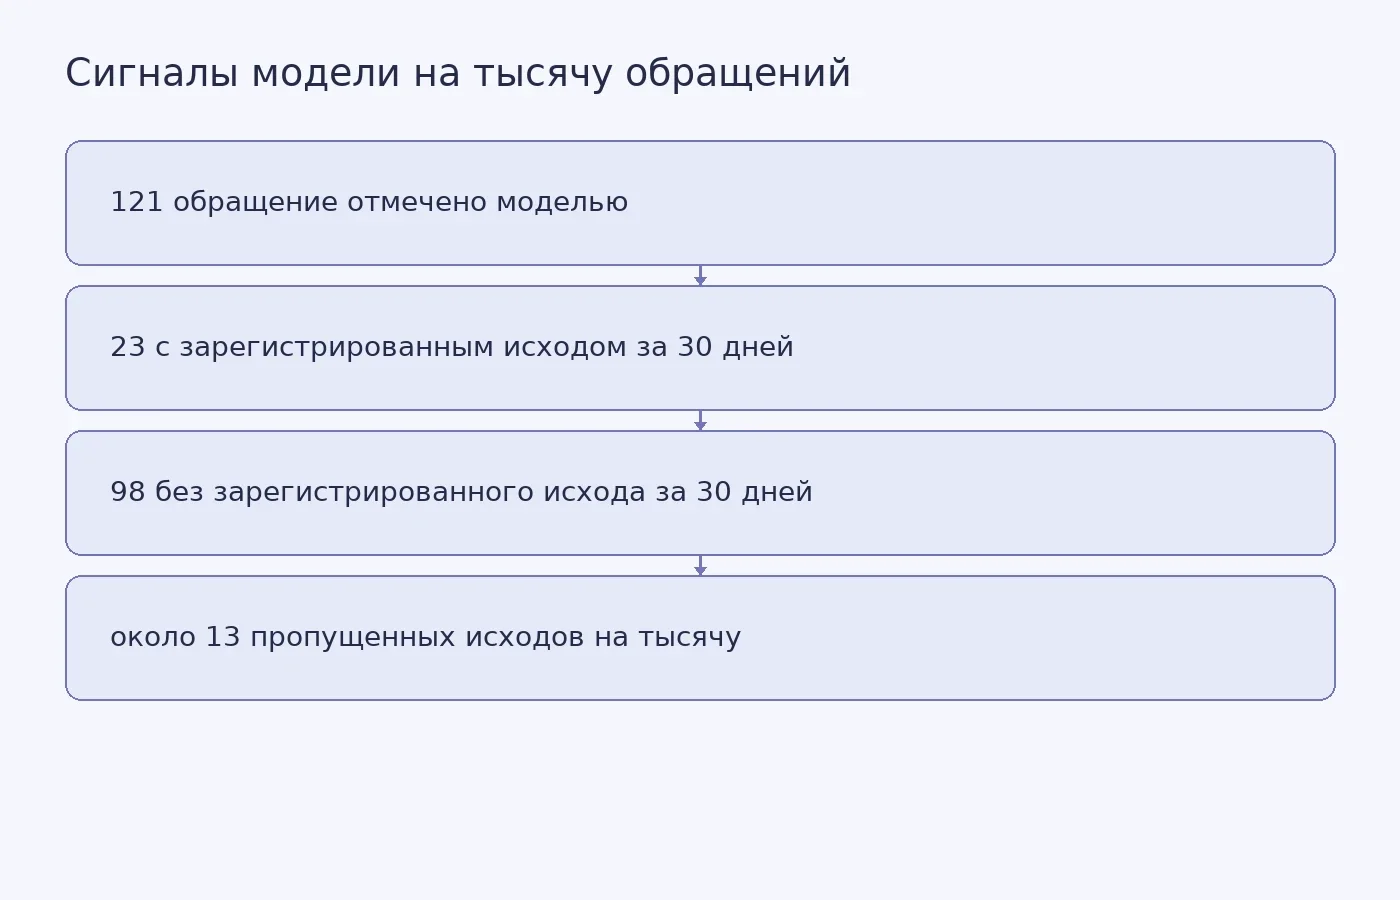
Фото: RDNE Stock project / Pexels


Похожие статьи
 Магистерские диссертации
10
мин
23.10.2026
Сколько страниц должно быть в магистерской диссертации: как определить объём
В одном вузе студенту выдают методичку с точным числом страниц, а в другом документ описывает только порядок подготовки и защиты ВКР. Поэтому единого объёма для всех магистерских диссертаций нет. Требование устанавливает конкретная образовательная программа, а иногда вместо диссертации программа пре
 Магистерские диссертации
6
мин
12.11.2024
10020
Научная новизна в магистерской диссертации
Научная новизна в магистерской диссертации – это принципиальные отличия нового исследования от похожих исследовательских работ, проведенных ранее. Грамотно написанная и правильно аргументированная научная новизна в магистерской диссертации увеличивает шанс на получение высокого балла от предст
 Магистерские диссертации
4
мин
13.06.2023
10250
Положения на защиту магистерской диссертации + Пример
Положение на защиту магистерской диссертации – это результаты проведенной исследовательской деятельности по теме квалификационной работы, демонстрирующие пользу и ценность проделанной работы. Положения, выносимые на защиту магистерской диссертации, обладают научной новизной и рациональным объя
 Магистерские диссертации
18
мин
29.10.2026
10854
Презентация к магистерской диссертации: как подготовить + пример
Презентация к магистерской диссертации помогает показать исследовательский вопрос, материал, метод и собственный результат так, чтобы комиссия могла проследить логику вывода. Слайды не заменяют текст ВКР и не должны становиться его уменьшенной копией. Хорошая рабочая проверка: по каждому слайду поня
 Магистерские диссертации
4
мин
13.06.2023
10741
Речь на защиту магистерской диссертации: структура и образец
Доклад магистерской диссертации содержит краткое описание результатов исследования. Текст речи на защиту составляется с учетом 2 факторов: длительность выступления (5-10 минут) и презентация по теме работы. Правила вступительной речи на защиту магистерской Текст доклада на защиту магистерс
 Магистерские диссертации
4
мин
13.06.2023
10067
Заключение магистерской диссертации
Заключение магистерской диссертации – это один из обязательных структурных единиц выпускной квалификационной работы магистра. Тут подводятся итоги проведенных исследований, дается детальная характеристика реализованных задач, а также полученный эффект от внедрения авторской методологии и друга
Последние новости и статьи
 Магистерские диссертации
7
мин
03.11.2026
Гигантская глубоководная губка размером с минивэн всё ещё остаётся загадкой
В августе 2015 года дистанционно управляемый аппарат Deep Discoverer шёл над подводным хребтом к северу от поднятия Банк 9, в границах морского национального памятника Папаханаумокуакеа. На глубине 2117 метров прожекторы выхватили из темноты нечто настолько большое, что осознать его как единый орган
 Помощь по написанию
9
мин
03.11.2026
Персонализированная психиатрия и психоделики: кто получит пользу от новых методов?
Представим условную пациентку с депрессией. Одному человеку помогает первый назначенный препарат, другому приходится менять лекарства и дозы. Персонализированная психиатрия обещает сократить этот поиск: сопоставить симптомы и биологические данные пациента с тем, что помогало людям со схожими особенн
 Вопросы студентов
13
мин
03.11.2026
Спор вокруг первой пересадки спинного мозга: какие доказательства нужны до операции на человеке
На 60-й день три свиньи из пяти ходили, хотя и неустойчиво. Две контрольные не восстановили движений. Так закончился опыт, опубликованный в PLOS ONE в июне 2026 года и разобранный корреспондентом New Scientist Хелен Томсон. Через несколько месяцев в Москве, в институте имени Склифосовского, прошла о
 Наука
3
мин
02.11.2026
Симуляция Lumina показала первые 2 млрд лет истории Вселенной
Астрофизики собрали модель Lumina: она прослеживает два миллиарда лет космической истории, от плотного тумана нейтрального водорода до света первых галактик. О работе сообщил Live Science, статья вышла в Monthly Notices of the Royal Astronomical Society. Первый автор Оливер Зир, бывший постдок Масса
 Наука
7
мин
02.11.2026
Скопление VVV CL001: возраст 13,4 млрд лет и оговорка в 1 млрд
Скопление VVV CL001 в созвездии Змееносца, у самого центра Млечного Пути, получило новую оценку возраста: 13,4 ± 0,4 млрд лет. Расстояние до него уточнили до 7,34 ± 0,46 килопарсека, то есть примерно 24 тысячи световых лет. Работу выполнила группа Хулио Оливареса Карвахаля из обсерватории Каподимонт
 Образование
4
мин
02.11.2026
В КФУ назвали три просьбы, которые подростки не считают преступлением
В Высшей школе журналистики и медиакоммуникаций Казанского федерального университета 2 ноября прошёл республиканский семинар для учителей «Навигатор в цифровом потоке». Собрались около 40 педагогов из разных районов Татарстана. Семинар проводят третий год подряд: по словам заведующей кафедрой телепр