


Содержание статьи
Оформление работ
06.11.2026
06.11.2026
8
мин
Можно ли узнать, что происходит внутри языковой модели, по её ответу? В обычном разговоре это трудно проверить: система может убедительно описывать «свои мысли», не опираясь на внутреннее состояние. Исследователи попробовали обойти эту трудность: искусственно меняли активации модели, а затем спрашивали, заметила ли она вмешательство.
Здесь легко смешать три разных результата. Модель может обнаружить, что произошло что-то необычное, угадать содержание изменения или действительно отслеживать собственное состояние. Одно не доказывает другое. Чтобы увидеть разницу, стоит сопоставить исходный эксперимент, его воспроизведения и критические проверки.
29 октября 2025 года Джек Линдси из Anthropic опубликовал на сайте Transformer Circuits исследовательский отчёт «Возникающее интроспективное осознание в больших языковых моделях». На странице не указан статус рецензирования. Линдси проверял, зависит ли самоотчёт модели от её внутренних представлений: извлекал векторы активности, связанные с понятиями, и вводил их в остаточный поток модели на разных слоях. Затем Claude спрашивали, обнаружила ли она внедрённую «мысль» и о чём та.
В систематической части работы использовали 50 случайно выбранных слов, варьировали слой и силу вмешательства, а результаты сравнивали с испытаниями без внедрения. Ответ считали успешным, если модель сообщала о вмешательстве, правильно называла понятие и делала это до того, как произносила связанное слово. В подходящих условиях Claude Opus 4 и 4.1 справлялись примерно в 20% испытаний. В ста контрольных попытках без вмешательства производственные модели не дали ложных срабатываний.
Ранний ответ и чистый контроль важны: модель не могла просто заметить необычное слово в собственном предыдущем тексте. Но эксперимент проверял поведение в специально устроенной, неестественной ситуации. Успех оставался редким, зависел от слоя и силы внедрения, а авторы не проверяли наличие у ИИ человеческого самосознания или субъективного опыта. Линдси считал подтверждёнными только первоначальное обнаружение вмешательства и, иногда, правильное определение понятия. Остальные детали объяснений модели могли быть выдуманными.
Именно содержание ответа стало предметом работы Харви Ледермана и Кайла Маховальда. В препринте, поданном на arXiv 5 марта 2026 года и обновлённом 7 апреля, они воспроизвели парадигму Линдси на больших моделях с открытыми весами. Их вывод: модель могла заметить аномалию, не определив надёжно, что именно внедрили. Ошибаясь, она часто называла частотное конкретное слово, например «яблоко». Авторы назвали такой эффект нечувствительным к содержанию: сигнал об аномалии обнаруживается отдельно от распознавания её причины. Это препринт, а не подтверждённая рецензированная публикация.
Такое разделение не отменяет обнаружение, но делает его более узким свидетельством. Необычный рисунок активности может вызвать реакцию «что-то не так», не позволяя модели достоверно установить, какое понятие он кодирует.
Другой препринт исследует, как устроено это обнаружение. Узай Макар, Ли Ян, Аттикус Ван, Питер Уоллич, Эммануэль Амейсен и Джек Линдси представили работу «Механизмы интроспективного осознания» на arXiv 22 марта 2026 года; версия 5 датирована 10 июня. На открытых моделях авторы проверяли устойчивость эффекта при разных формулировках и форматах диалога, сравнивали базовые и дообученные модели и анализировали механизмы по слоям и направлениям активности. Они сообщили о нулевой частоте ложных срабатываний в проверенных условиях и связали способность с дообучением: её вызывали некоторые методы оптимизации предпочтений, но не обычное обучение с учителем. По их анализу, обнаружение и определение содержания опираются преимущественно на разные механизмы.
Это объяснение спорит с простой версией, будто внедрённый вектор лишь подталкивает модель сказать «да». Однако подробное описание вычислительных механизмов не решает, подходит ли им слово «интроспекция». В этой работе оно входит в название и обозначает исследуемую способность обнаруживать внедрённые векторы, а не заранее установленное наличие человеческого самонаблюдения.
В отчёте Линдси есть и другой опыт: модель просили «думать» о постороннем слове или, наоборот, не думать о нём, а затем измеряли, как меняется его представление в активациях. Инструкция влияла на внутреннее состояние, но это не доказывает, что модель замечала изменение как отдельное событие. Сам автор оговаривал, что такое управление может не требовать интроспективного осознания.
Спор зависит и от того, как определить интроспекцию. В препринте от 20 августа 2025 года Сиюань Сонг, Харви Ледерман, Дженнифер Ху и Кайл Маховальд предложили критерий «привилегированного доступа»: модель должна получать сведения о внутреннем состоянии способом более надёжным, чем доступный внешнему наблюдателю способ с равными или меньшими вычислительными затратами. На задачах, где модели рассуждали о собственных параметрах температуры, авторы показали, что убедительное самоописание ещё не подтверждает такой доступ.
Ещё одну проверку провели Шашват Сингх, Тал Линзен и Шаули Равфогель. В препринте, поданном 25 мая и обновлённом 21 августа 2026 года, они проверили, могут ли модели отличить вмешательство во внутреннее состояние от манипуляции входными данными. По их результатам, надёжно провести это различие не удалось. Успех мог объясняться общей реакцией на аномалию, а не отслеживанием собственного состояния. Авторы заключили, что данных пока недостаточно, чтобы установить метакогнитивный мониторинг, то есть наблюдение модели за собственными мыслительными процессами. В записи arXiv указано, что работа принята на COLM 2026; это не равнозначно опубликованной журнальной статье.
Итак, эксперименты поддерживают несколько ограниченных выводов: некоторые модели реагируют на искусственно изменённые активации, иногда обнаруживают необычный сигнал до его появления в тексте, а инструкции могут менять силу внутренних представлений. Но обнаружение аномалии, распознавание её содержания и метакогнитивное отслеживание собственного состояния требуют разных доказательств. Первое подтверждено лучше; второе ненадёжно, а относительно третьего продолжается спор.
Практический вывод прост: если модель заявляет, что заметила собственное внутреннее состояние, это заявление само по себе не даёт прозрачного отчёта о том, как она пришла к ответу. Почему убедительная речь ИИ также не доказывает наличие у него субъективного опыта, разобрано в статье о различии между способностями модели и внутренним опытом.
Источники
- Джек Линдси. «Возникающее интроспективное осознание в больших языковых моделях». 29 октября 2025 года. Полный текст исследовательского отчёта.
- Харви Ледерман, Кайл Маховальд. «Возникающая интроспекция в ИИ нечувствительна к содержанию». Препринт arXiv:2603.05414, версия 2 от 7 апреля 2026 года.
- Узай Макар, Ли Ян, Аттикус Ван, Питер Уоллич, Эммануэль Амейсен, Джек Линдси. «Механизмы интроспективного осознания». Препринт arXiv:2603.21396, версия 5 от 10 июня 2026 года.
- Сиюань Сонг, Харви Ледерман, Дженнифер Ху, Кайл Маховальд. «Почему для интроспекции ИИ важен привилегированный доступ к собственному состоянию». Препринт arXiv:2508.14802 от 20 августа 2025 года.
- Шашват Сингх, Тал Линзен, Шаули Равфогель. «Способны ли большие языковые модели к интроспекции? Проверка реальностью». Препринт arXiv:2605.26242, версия 2 от 21 августа 2026 года. В записи arXiv указано принятие на COLM 2026.
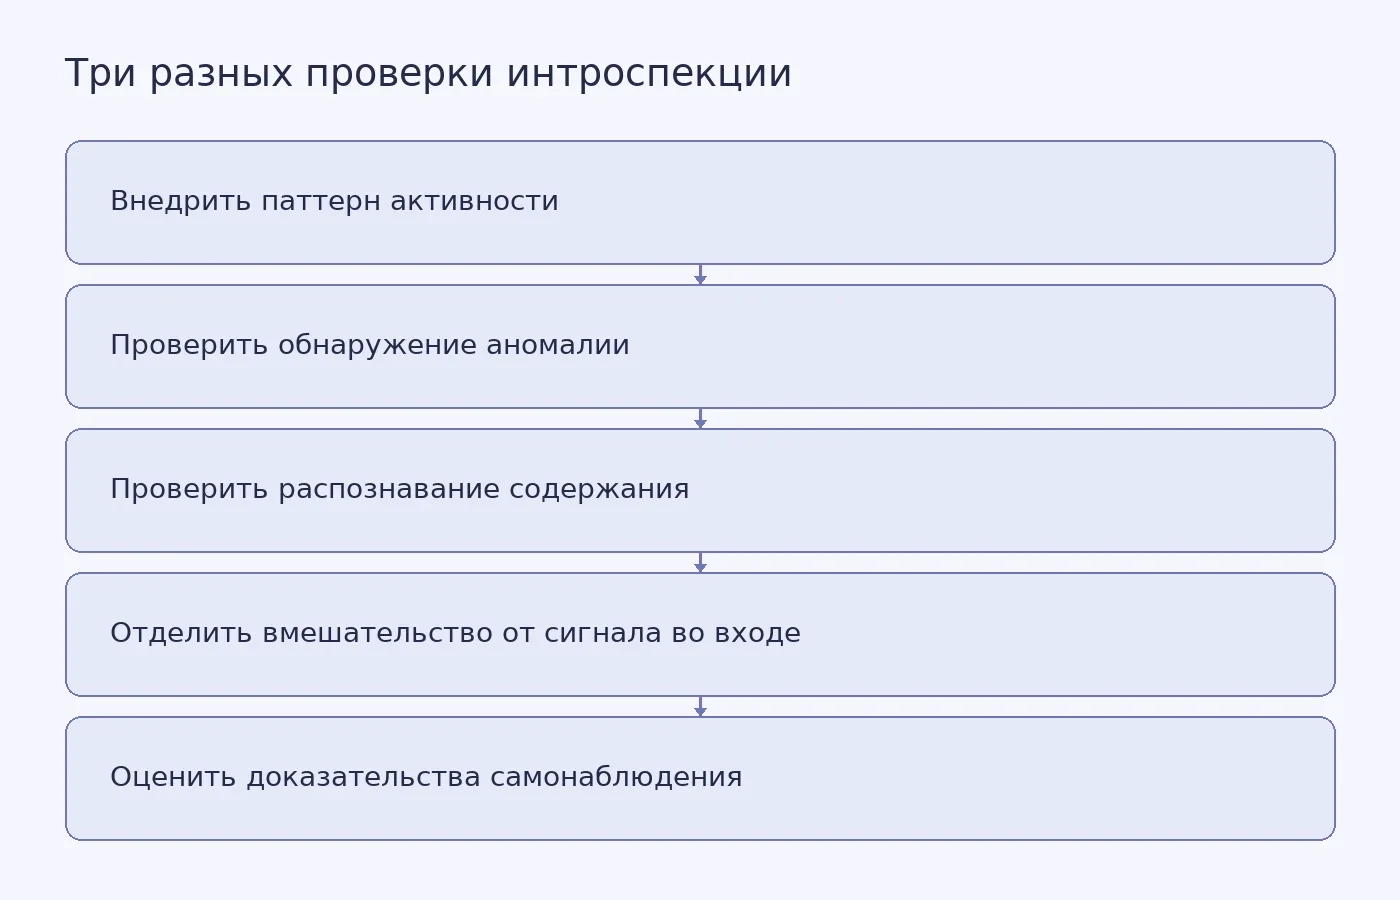
Фото: Matheus Bertelli / Pexels


Похожие статьи
 Оформление работ
14
мин
04.11.2026
Почему «reach» и «react» читаются по-разному, и при чём здесь подготовка учителя
Ребёнок останавливается на слове, пробует его прочитать и смотрит на учителя. Если произнести слово вслух, предложение поедет дальше и урок не встанет. Статья Джереми Ло и Александры Бёзе, вышедшая в The Conversation и перепечатанная phys.org 27 октября 2026 года, начинается с этой сцены. Дальше авт
 Оформление работ
33
мин
05.11.2026
Поляков «Киевская Русь как цивилизация»: метод и вече
«Киевская Русь как цивилизация» Александра Николаевича Полякова — монография о том, как устройство общества связано с землевладением, ценностями и политической властью. Ниже разбираем второе издание 2015 года: определение цивилизации, ход исследования и конкретный аргумент о вече. Если вы готовите с
 Оформление работ
8
мин
12.01.2023
10243
Как проверить диссертацию на ошибки? 15 самых распространенных ошибок в диссертации
Классификация ошибок в диссертации может быть разной – все зависит от специфики тематики научной работы, а также внимательности автора документа при написании текста. Неоднократный повтор одних и тех же неточностей может привести к возвратам на доработку или полной дисквалификации труда. По
 Оформление работ
17
мин
28.10.2026
18879
Оформление формул в диссертации по ГОСТ
Формула в диссертации должна оставаться понятной после проверки расчёта, переноса строки и изменения номера главы. Читателю нужны само выражение, значения символов, единицы величин и точная отсылка из текста. Ниже разберём эти элементы на законченном учебном расчёте средней путевой скорости: два уча
 Оформление работ
16
мин
13.06.2023
62981
Требования к кандидатской диссертации 2023
Требования к кандидатской диссертации устанавливаются действующими на сегодняшний день требованиями нормативных актов правительства, нормами ГОСТ, правилами Высшей аттестационной комиссии и рекомендациями научных советов высших учебных заведений. Общая унификация стандартов направл
 Оформление работ
15
мин
13.06.2023
18317
Требования ВАК к диссертациям
Соблюдение требований ВАК о публикациях диссертаций в научных журналах перечня упрощает получение соискателем кандидатской или докторской степени. Общие требования ВАК к диссертациям По требованиям ВАК, количество публикаций докторской или кандидатской диссертации в научных журнала
Последние новости и статьи
 Дипломы
11
мин
06.11.2026
Сингапур пробует охладить здание без кондиционера: что стоит за цифрами экономии
На Орчард-роуд, главной торговой улице Сингапура, стеклянные двери магазинов открываются, и на тротуар выходит холодный воздух. При температуре от 31 до 33 °C круглый год этот холод и правда заставляет людей заходить внутрь. Город, который давно называют «нацией кондиционеров», устроен вокруг охлажд
 Вопросы студентов
10
мин
06.11.2026
Общий продукт, разные оценки: как отделить вклад студента от качества групповой работы
Групповой проект сдан. Презентация собрана, текст вычитан, выводы на месте. И всё равно по такой работе трудно понять, кто в группе разобрался в теме, а кто просто вовремя открыл общий файл. Тем более когда заметную часть черновика можно получить у чат-бота за вечер. Линь Юэ, преподаватель Университ
 Докторские диссертации
14
мин
06.11.2026
Риск вместо «опасного вида»: как экологи перенесли климатическую логику на вред от природы
Крокодил у деревенского берега и комар, переносящий малярию, плохо укладываются в одну графу «опасный вид». Крокодила можно отпугнуть или отстрелять. С комаром такой счёт не работает: их миллиарды, болезнь распространяют не все и не везде. Схема «есть вид, есть угроза, значит надо убрать вид» даёт с
 Наука
3
мин
05.11.2026
Испытание NOVOS Core выявило изменения трёх показателей здоровья сосудов
В шестимесячном исследовании Университета Суррея в Великобритании 61 здоровый взрослый старше 40 лет принимал добавку NOVOS Core или плацебо. У группы добавки изменились три показателя состояния сосудов по сравнению с контрольной группой. Результаты опубликовали 4 ноября 2026 года в журнале European
 Наука
4
мин
05.11.2026
Показатель ARC связал активность мозга с риском когнитивного снижения до симптомов Альцгеймера
Исследователи Stanford Medicine и их коллеги разработали показатель ARC, который связывает паттерны активности мозга с последующим когнитивным снижением. Результаты опубликованы 4 ноября 2026 года в журнале Science Advances. Работа основана на данных более чем 1300 человек в возрасте от 55 до 70 лет
 Образование
2
мин
05.11.2026
В НИУ ВШЭ — Нижний Новгород переименуют программу по лингвистике
НИУ ВШЭ — Нижний Новгород с 2027/2028 учебного года переименует бакалаврскую программу «Фундаментальная и прикладная лингвистика» в «Лингвистика и интеллектуальные системы». Университет сообщил об этом 5 ноября 2026 года. Новое название описывает развитие действующей программы, в которой соединяются