


Содержание статьи
Оформление работ
05.11.2026
05.11.2026
14
мин
Адвокат, который вёл чувствительное дело, снял трубку: звонили с номера Хани Фарида, и голос звучал его. Разговор шёл о деле, о котором знали немногие. Минуты через три адвокат заподозрил неладное, положил трубку и перезвонил. Настоящий Фарид ему не звонил. Эту историю Фарид рассказывает сам в пятом выпуске подкаста Science News «The Deep End: Talk to Me»; текст и расшифровку выпуска 3 ноября 2026 года опубликовала Лаура Сандерс.
Фарид занимается информатикой в Дартмутском колледже и состоит соучредителем фирмы Get Real Security, которая ищет способы отличать подлинные записи от подделок. Что именно вызвало подозрение адвоката на третьей минуте, в расшифровке не сказано, и Фарид не утверждает, что этот случай можно повторить в обычном разговоре.
Прежде чем разбирать сам вопрос, стоит назвать статус материала. Это журналистская работа: эпизод подкаста с интервью, личными историями и аудиодемонстрациями. Ни DOI, ни рецензирования, ни выборки с протоколом у неё нет. Собственное исследование Фарида о распознавании подделок пересказано в двух фразах, без числа участников, стимулов и условий. Всё, что ниже, опирается на этот пересказ, поэтому утверждения приходится держать узкими.
Две задачи, которые обычно путают
В том, как Фарид описывает лабораторные тесты, речь идёт о двух разных вопросах, и разница между ними и есть самое полезное в материале.
Первый вопрос: настоящее или синтезированное? Здесь люди, по его словам, не могут надёжно отличить голос машины от голоса живого человека, и он сравнивает результат с подбрасыванием монеты. Второй вопрос формулируется иначе: это один и тот же человек или нет? Для ответа слушателю дают образец реального голоса и образец клона, а спрашивают не про подлинность, а про тождество. И здесь клон проходит проверку: по словам Фарида, примерно двадцати секунд чужой речи достаточно, чтобы синтез звучал как тот же человек.
Провал в первом задании и успех во втором не противоречат друг другу: вопросы разные. Слух не справляется с оценкой того, сделана ли запись машиной. Когда же его спрашивают, тот ли это человек, клон сохраняет идентичность настолько, что ответом становится «да».
Отсюда следует неприятный для практики вывод, и это уже моя интерпретация, а не результат Фарида: совет «слушайте внимательнее» от подделки почти не защищает. Мошенник предъявляет не абстрактный синтез, а голос, который слух опознаёт как голос конкретного человека.
Техническая сторона детекции — отдельная тема, и в этом материале о ней нет ничего: ни про водяные знаки, ни про артефакты сжатия. Что дают джиттер, шиммер и встраиваемые метки, разобрано в другом тексте — как отличить клонированный голос от живого: что показывают джиттер, шиммер и водяные знаки. Здесь же важно только то, что слуховая проверка не заменяет ни техническую, ни процедурную.
Когда клон возвращает голос
Джулс Родригес потерял речь из-за бокового амиотрофического склероза и пользуется клонированным голосом. Свою первую встречу с копией он описывает так: «Когда я впервые услышал свой клонированный голос, мне показалось, что я снова появился». Его жена, М. А. Фернандес, заплакала, услышав, насколько это похоже на голос мужа до болезни. Это не эксперимент и не измерение, это свидетельство одного человека, но именно на таких свидетельствах держится аргумент о пользе.
Фарид приводит два примера, где технология явно полезна: человек с боковым амиотрофическим склерозом говорит голосом, похожим на свой, и синхронный перевод, при котором речь на другом языке сохраняет тембр говорящего. Оба примера он называет состоявшимися, а не перспективными. Карина Нагин из организации Bridging Voice добавляет, что видит и общую опасность ИИ, и конкретную пользу в своей области, и считает, что оба разговора нужно вести одновременно.
Между полюсами есть середина, и Сандерс честно называет её самой трудной для оценки. Голосом Снуп Догга, который сотрудничает с сервисом Speechify, можно озвучить учебный текст по биологии клетки. Помогает это или нет? Сандерс формулирует так: хорошо, потому что кто-то узнает про митохондрии; плохо, потому что Снуп Догг этих слов не произносил. Тот же вопрос возникает к синтезированным лекциям покойного физика Ричарда Фейнмана. Это редакционная оценка, а не вывод исследования, и она полезна именно как постановка задачи: граница проходит не по качеству звука, а по тому, что человек сказал сам.
Мошенничество масштабируется без людей
Список, который приводит Фарид, укладывается в одну мысль: украденный голос нужен не для розыгрыша, а для доступа. Романтические аферы. Звонки родителям с требованием выкупа за ребёнка. Разговоры с теми, кого принимают за глав других государств. Звонки в компании с просьбой сбросить учётные данные сотрудника. Северокорейские специалисты, которые проходят в крупные компании, маскируя голос, акцент и личность.
Отдельно Сандерс говорит про масштаб: чат-боты пишут сценарии для таких звонков, и в цепочке не остаётся человека, кроме того, кого обманывают. Она же добавляет актуальный контекст: запись шла осенью 2026 года, в разгар промежуточных выборов в США, и часть политической рекламы использует поддельные аудио и видео, где противники произносят то, чего не говорили; примеры таких подделок собрала газета The New York Times. Речь идёт о конкретной кампании, а не об оценке распространённости явления.
Есть в этом и личная нота, которую стоит передать точно. Фарид говорит, что за последние двадцать лет общество рассталось с номерами телефонов, адресами и номерами социального страхования, а последним рубежом оставались собственный голос и облик. «Когда можно украсть чью-то внешность, голос и лицо, можно нанести ущерб», говорит он. И добавляет про беспомощность: у него нет контроля над миллиардами звонков, которые идут каждый час, если кто-то присвоил его подобие. Оговорка про трёхмерность тоже его: двумерную картинку с созвоном можно подделать, а физическое присутствие пока остаётся собой, и «пока» он произносит отдельно.
Серая зона: голос, который говорит после смерти
Центральный сюжет выпуска не кража голоса, а его продолжение. Сандерс читает найденный в сети текст: мужчина потерял отца, который много лет страдал деменцией, тосковал по его голосу, оплатил базовый тариф, загрузил три минуты записи и получил, по собственным словам, «жутко точного клона голоса умершего отца». Семья, пишет он, поплакала от облегчения, а клон прочитал молитву «Отче наш» и рождественское стихотворение. Этот фрагмент самодельное свидетельство из интернета, приведённое в эпизоде; проверять его нечем, и обобщать на всех скорбящих нельзя.
Дальше начинается рынок. Сервисы предлагают переписку с умершими, и на одной из страниц есть кнопка с обещанием вернуть человека к жизни. Документальный фильм «Eternal You» 2024 года показывает людей, которые с этим обращаются. Дилан Томас Дойл, бывший больничный капеллан и научный сотрудник Северо-Западного университета, изучает смерть и ИИ и описывает реакцию на такие разговоры как «экзистенциальную жуть»: сценария, объясняющего происходящее, у культуры нет, а утешение при этом есть. Он видит напряжение между здоровым продолжением связи (письмами умершему, разговорами вслух) и удержанием отношения, которое не даёт двигаться дальше.
Здесь важнее всего то, чего в материале нет. Дойл прямо говорит: надёжных данных о том, сколько людей пользуется такими программами, не существует, а распространённость домашнего использования остаётся неясной. Влияние разговоров на переживание утраты не установлено: они могут помочь, а могут навредить. Ни одного исследования, которое разрешало бы этот спор, в эпизоде не названо.
Кому принадлежит голос
На этот вопрос материал отвечает не «никакому» и не «тому, кто заплатил», а «пока никак». Нагин перечисляет вопросы, которые уже возникают у людей: стоит ли вписать это в завещание, хочешь ли ты звучать на собственных поминках, хочешь ли оставить ребёнку голосовое сообщение к выпускному, кто и когда этим может пользоваться, можно ли детям озвучить твоим голосом речь для внуков, или запись должна быть удалена после смерти. Правила, по словам Сандерс, разбросаны: регулирование различается от штата к штату и от страны к стране, у компаний свои политики, единых ориентиров нет, и при нынешнем возрасте технологии это объяснимо.
Самый ясный пример здесь не юридический, а личный. Родригес попросил жену, чтобы его голос умер вместе с ним и копию не использовали, чтобы «продолжать» его. Фернандес подтверждает: просьба прозвучала до трахеостомии, реакция была однозначной, и голос останется только в тех видео, которые он оставил намеренно. Это решение двух людей, а не норма. Оно ничего не говорит о том, что будет, если распоряжения нет, если файлы хранит сервис, если доступ к аккаунту перейдёт наследникам.
Что из этого можно вынести
Граница между полезным и вредным применением в материале не сформулирована как готовый ответ, но её очертания можно собрать из двух частей.
Первая часть это проверка. В рассказанном Фаридом случае адвокат прервал подозрительный разговор и перезвонил ему по известному каналу, и подделка раскрылась. Источник не проверяет этот приём как общий способ защиты и не оценивает его надёжность, поэтому обобщать его на другие ситуации нельзя. Можно лишь заметить, что сама история иллюстрирует обход отказа слуха: сработал не слух, а независимый канал связи. Он помогает только тогда, когда такой канал есть, и не работает против записи, на которую нечем ответить.
Вторая часть это согласие и контроль. Полезное применение в материале объединяет одно: человек сам решил, что его голос будет звучать, и сам понимает, где лежит копия. Вредное устроено наоборот: голос используют без ведома владельца, будь то афера, политический ролик или посмертная переписка, о которой человек ничего не говорил. Между этими полюсами остаются случаи, где согласие было, а границ не обсудили: именно там и оказываются разговоры с умершими.
Отсюда напрашивается моя собственная рекомендация, а не вывод подкаста. Если записывать пожелания о голосе, имеет смысл называть не только «можно или нельзя», но и кто хранит записи, кто имеет доступ и как этот доступ отзывается. Подкаст не разбирает ни юридическую силу таких распоряжений, ни технические механизмы контроля над файлами, так что это постановка вопроса, а не проверенное решение.
Ограничения этого разбора
- Единственный источник здесь журналистский материал и расшифровка подкаста. Рецензирования, DOI и первичной публикации нет.
- Лабораторные тесты описаны без выборки, числа участников, стимулов и условий, поэтому оценку «на уровне монеты» и «двадцати секунд» нельзя превращать в измеренную величину.
- История с адвокатом и история с клоном умершего отца остаются единичными случаями, а не проверенными методиками.
- Данных о распространённости разговоров с умершими и об их влиянии на переживание утраты нет; в эпизоде это сказано прямо.
- Правовая часть ограничена указанием, что правила различаются. Ни конкретных норм, ни российского регулирования источник не разбирает, и переносить американские примеры на российские правила нельзя.
Открытым остаётся вопрос, который материал только ставит. Если человек не оставил распоряжений, кто решает судьбу его голоса: наследники, сервис, который хранит записи, или никто, потому что подходящей процедуры пока не существует. Ответа на него в эпизоде нет, и придумывать его не стоит.
Источники
Laura Sanders. Your voice can now say things you never said // Science News. 3 ноября 2026. Подкаст «The Deep End: Talk to Me», эпизод 5, с расшифровкой. URL: https://www.sciencenews.org/article/voice-clone-deep-end-podcast
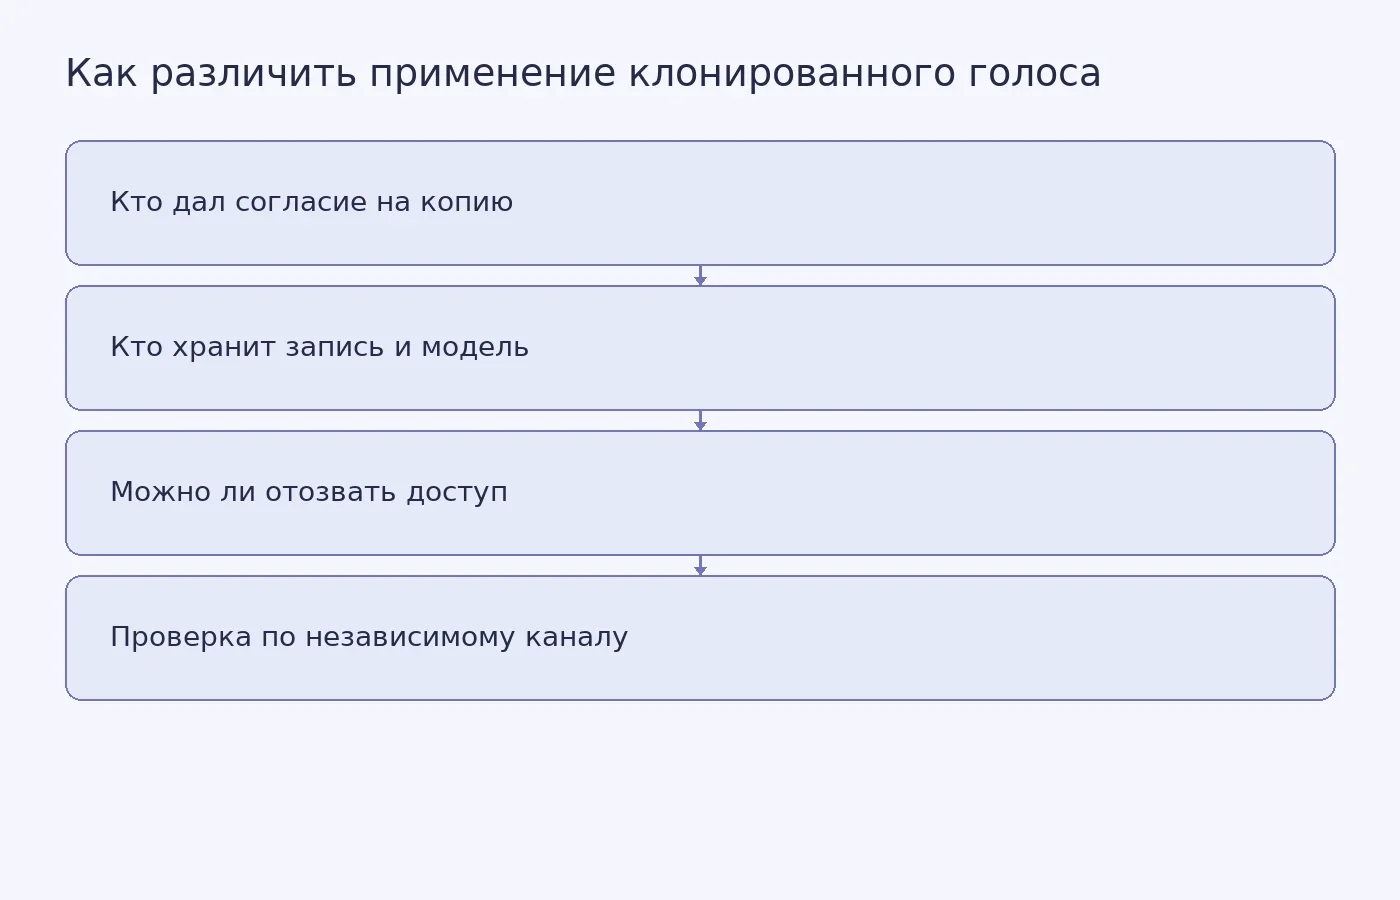
Фото: Sarah Blocksidge / Pexels


Похожие статьи
Последние новости и статьи
 Вузы
3
мин
05.11.2026
Готовность кампуса БФУ достигла 94%: открытие могут перенести на 2027 год
Новый кампус БФУ имени И. Канта в Калининграде готов на 94 процента. Об этом 5 ноября 2026 года сообщила «Российская газета» со ссылкой на губернатора Калининградской области Алексея Беспрозванных. Кампус возводят по нацпроекту «Молодежь и дети».По словам главы региона, объект практически готов, и в
 Наука
3
мин
05.11.2026
Мутации CD28 помогли CAR-T-клеткам избежать подавления сигналом PD-1
4 ноября 2026 года Phys.org сообщил о доклиническом исследовании китайских учёных: мутации рецептора CD28 помогли CAR-T-клеткам сохранять активность, когда на клетках-мишенях присутствовал белок PD-L1. Результаты опубликованы в журнале PNAS. В работе участвовали исследователи Института биофизики Кит
 Наука
2
мин
05.11.2026
Мужчины с шизофренией хуже распознавали эмоции по лицам и движениям тела
Исследователи из Тюбингенского университета в Германии обнаружили, что мужчины с шизофренией менее точно распознают эмоции и по движению тела, и по выражению лица. Работа вышла 7 июля 2026 года в журнале Schizophrenia. В ней участвовали 28 мужчин с шизофренией или близкими расстройствами и 28 здоров
 Оформление работ
33
мин
05.11.2026
Поляков «Киевская Русь как цивилизация»: метод и вече
«Киевская Русь как цивилизация» Александра Николаевича Полякова — монография о том, как устройство общества связано с землевладением, ценностями и политической властью. Ниже разбираем второе издание 2015 года: определение цивилизации, ход исследования и конкретный аргумент о вече. Если вы готовите с
 Практика
33
мин
05.11.2026
Греков «Киевская Русь»: разбор открытого фрагмента
Монография Бориса Дмитриевича Грекова «Киевская Русь» позволяет изучать не только объяснение древнерусского общества, но и способ работы историка с летописным рассказом. Ниже разобран открытый фрагмент издания «Концептуал» 2025 года: его аргументы, ограничения и пригодность для исследовательской раб
 Кандидатские диссертации
29
мин
05.11.2026
Древняя Русь: монографии, статья об Александре Невском и выбор литературы
Монографию об Александре Невском, исследование «Поучения» Владимира Мономаха и работу о понятии «Киевская Русь» выбирают под разные вопросы: о деятельности князя, устройстве литературного текста или истории научных объяснений. Ниже — маршрут выбора с разбором доступных фрагментов и ясными границами