


Содержание статьи
Оформление работ
29.10.2026
29.10.2026
7
мин
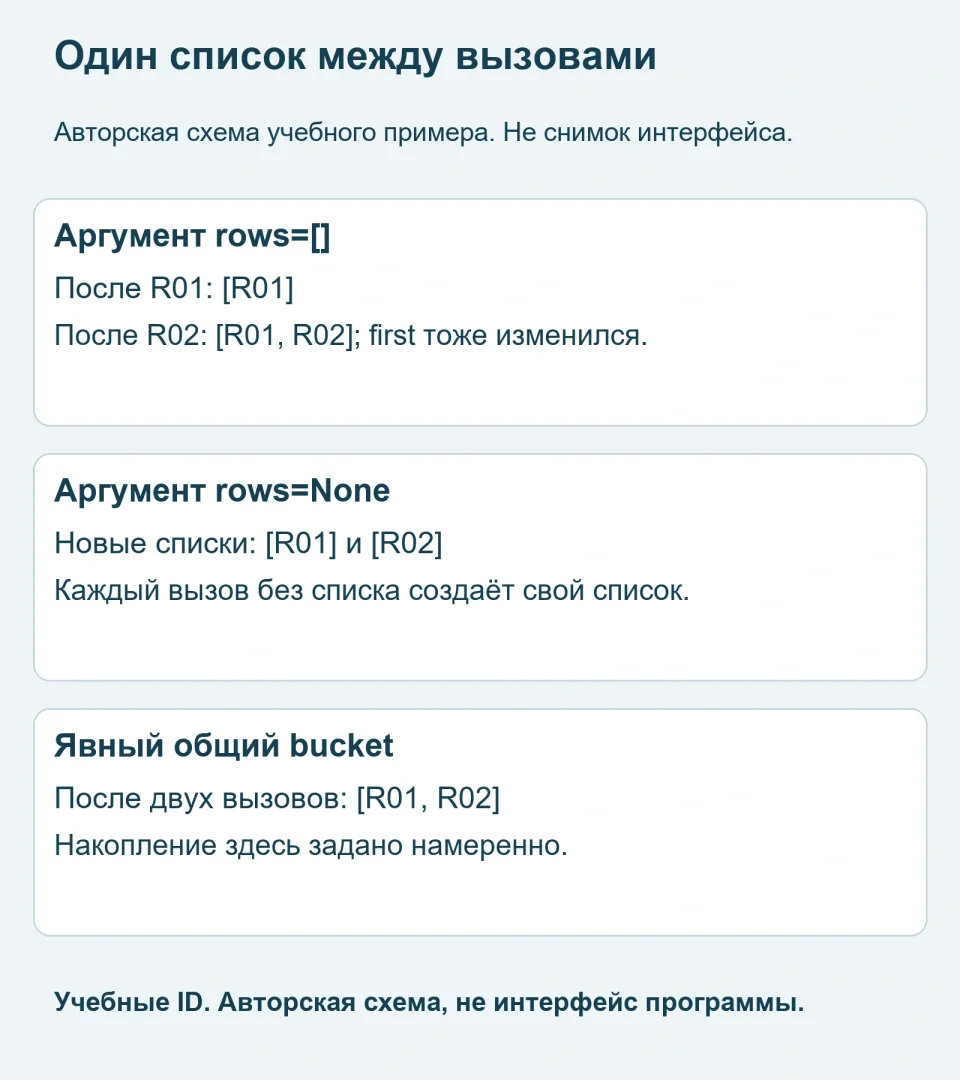
Функция собирает ID для одной порции данных, но во втором вызове неожиданно появляется ID из первой. Причина может быть не в файле и не в повторяющихся строках: изменяемый список, заданный аргументом по умолчанию, сохраняется между вызовами этой функции. Разберём, как это обнаружить и как отдельно выразить два намерения: новый список на каждый вызов и намеренное накопление в общем списке.
R01 и R02 ниже обозначают вымышленные идентификаторы двух учебных записей. Никаких сведений о реальных участниках в примере нет. Полный код выполнен в Python 3.12.14 без внешних пакетов. Он показывает поведение списков и вызовов, а не работу реальной программы сбора данных или интерфейса приложения.
Когда появляется список по умолчанию
В учебнике Python объяснено, что значение аргумента по умолчанию вычисляется при выполнении определения функции, а не заново при каждом её вызове. Если это изменяемый объект и функция меняет его, следующие вызовы без переданного аргумента обращаются к тому же объекту. Это утверждение относится к данному определению функции: новое выполнение def создаст новое значение по умолчанию.
В нашем collect_bad метод append для изменяемой последовательности добавляет ID в уже существующий список. Возврат rows не делает снимок списка. Поэтому переменная first продолжает ссылаться на тот же объект и после второго вызова показывает обновлённое содержимое. Проверка is сравнивает тождество объектов; она не заменяет сравнение содержимого через ==.
| Момент или вариант | Результат учебного примера |
|---|---|
| После первого collect_bad | first содержит R01 |
| После второго collect_bad | second и first содержат R01, R02; это один объект |
| Два вызова collect без rows | Получены отдельные списки R01 и R02 |
| Два вызова collect с одним bucket | Один явно переданный список намеренно содержит R01, R02 |
Законченный пример: ошибка, исправление и намеренное накопление
В выводе first_before показывает содержимое first до второго вызова, а first_after показывает содержимое после него. Переменная shared показывает, один ли это объект с second. Пара fresh содержит два результата исправленной функции, fresh_shared проверяет их тождество. Bucket обозначает явно переданный накопитель, а не скрытое значение по умолчанию.
Ниже приведён полный код учебного примера и фактически полученный вывод. Обозначения в выводе объяснены рядом с примером.
def collect_bad(case_id, rows=[]):
    rows.append(case_id)
    return rows

first = collect_bad("R01")
print("first_before =", first)
second = collect_bad("R02")
print("second =", second)
print("first_after =", first)
print("shared =", first is second)

def collect(case_id, rows=None):
    if rows is None:
        rows = []
    rows.append(case_id)
    return rows

a = collect("R01")
b = collect("R02")
print("fresh =", a, b)
print("fresh_shared =", a is b)
bucket = []
collect("R01", bucket)
collect("R02", bucket)
print("bucket =", bucket)
assert first is second and first == ["R01", "R02"]
assert a == ["R01"] and b == ["R02"] and a is not b
assert bucket == ["R01", "R02"]
first_before = ['R01']
second = ['R01', 'R02']
first_after = ['R01', 'R02']
shared = True
fresh = ['R01'] ['R02']
fresh_shared = False
bucket = ['R01', 'R02']None в исправленной функции означает «создать новый список». Проверка rows is None важна: пустой список, который передал вызывающий код, остаётся тем самым списком. Подстановка rows or [] выражала бы другое правило и могла бы потерять намерение работать с переданным пустым накопителем. В этом примере контракт функции специально предполагает список или None, а не любой объект.
Как выбрать поведение для своей задачи
- Если каждая порция должна иметь собственный результат, создавайте список внутри вызова при rows is None. Проверьте два последовательных вызова, а не только первый удачный пример.
- Если требуется накопление, создайте bucket в вызывающем коде и передайте его явно. Зафиксируйте, когда его нужно очистить и где начинается новая порция.
- Не воспринимайте присваивание first = result как копирование данных. Если необходим независимый снимок, отдельно выберите подходящий способ копирования для своей структуры.
- Проверьте другие изменяемые значения по умолчанию: словари и пользовательские объекты также могут сохранять изменения. Не объявляйте любое значение по умолчанию ошибкой: важно, изменяется ли объект и соответствует ли это намерению.
Исправление rows=None создаёт новый внешний список только в указанном случае. Оно не копирует вложенные объекты, не изолирует произвольно переданные структуры и не делает весь процесс автоматически безопасным для параллельного выполнения. Границы примера нужно сохранять при переносе в реальный код: здесь работают короткие последовательные вызовы с двумя заранее заданными ID.
Что занести в журнал ошибки
| Вопрос | Ответ в учебном случае |
|---|---|
| Что воспроизводит сбой | Два вызова collect_bad без второго аргумента |
| Что изменилось | Общий список получил R02; старая ссылка first тоже видит его |
| Как проверено исправление | a и b имеют разные ID и a is b даёт False |
| Что оставлено намеренным | Один явно переданный bucket накапливает оба ID |
Похожая внешне проблема разобрана в статье о повторении вложенных списков, но там причина — ссылки на одну строку матрицы, а здесь — время создания аргумента по умолчанию. Для воспроизводимости проверки пригодится и памятка о фиксации окружения Python.
Если ошибка обнаружилась в подготовке исследовательского набора и дальше нужно обсудить методику расчётов, можно уточнить задачи статистического анализа. Сохраните минимальный воспроизводимый пример, исходную выгрузку и описание переменных. Отдельно согласуйте объём консультации: исправление одной функции не подтверждает все последующие расчёты и выводы.


Похожие статьи
 Оформление работ
15
мин
01.11.2024
52094
Требования ВАК к оформлению научной статьи
Перед защитой кандидатской или докторской диссертации, соискатель на ученую степень обязан опубликовать научную статью в один из рецензируемых журналов Высшей Аттестационной комиссии (ВАК). Зачем соблюдать требования ВАК? Публикация научной статьи и выполнения требований ВАК обязательны для вс
 Оформление работ
16
мин
13.06.2023
62981
Требования к кандидатской диссертации 2023
Требования к кандидатской диссертации устанавливаются действующими на сегодняшний день требованиями нормативных актов правительства, нормами ГОСТ, правилами Высшей аттестационной комиссии и рекомендациями научных советов высших учебных заведений. Общая унификация стандартов направл
 Оформление работ
23
мин
05.12.2022
28392
Как правильно оформить цитату в дипломной работе, курсовой, статье, презентации, сочинении?
Цитаты в дипломной работе отображают уровень теоретической подготовки автора документа, способность корректного оформления выражений, заимствованных у других исследователей, умение объективно аргументировать свою точку зрения вне зависимости от сложности выбранной темы. Основные виды цита
 Оформление работ
15
мин
13.06.2023
18317
Требования ВАК к диссертациям
Соблюдение требований ВАК о публикациях диссертаций в научных журналах перечня упрощает получение соискателем кандидатской или докторской степени. Общие требования ВАК к диссертациям По требованиям ВАК, количество публикаций докторской или кандидатской диссертации в научных журнала
 Оформление работ
10
мин
14.08.2023
15634
Как правильно оформить ссылки и сноски в диссертации
Библиографическая ссылка – это источник библиографической информации об объектах ссылки (литературы, использованной при подготовке диссертационного исследования). Она содержит сведения о рассматриваемой, упоминаемой или цитируемой в тексте работы составной части источника, требуемые для его по
 Оформление работ
23
мин
28.10.2026
40395
Оформление списка литературы в диссертации по ГОСТ
Список литературы в диссертации должен помогать найти именно тот документ, который использовал исследователь: нужное издание книги, статью, редакцию нормативного акта или версию электронного материала. Начните с проверки источников и связи с текстом, затем выберите порядок записей и только после это
Последние новости и статьи
 Наука
2
мин
29.10.2026
В Испании испытали полевую установку для производства мочевины на солнечной энергии и биобатареях
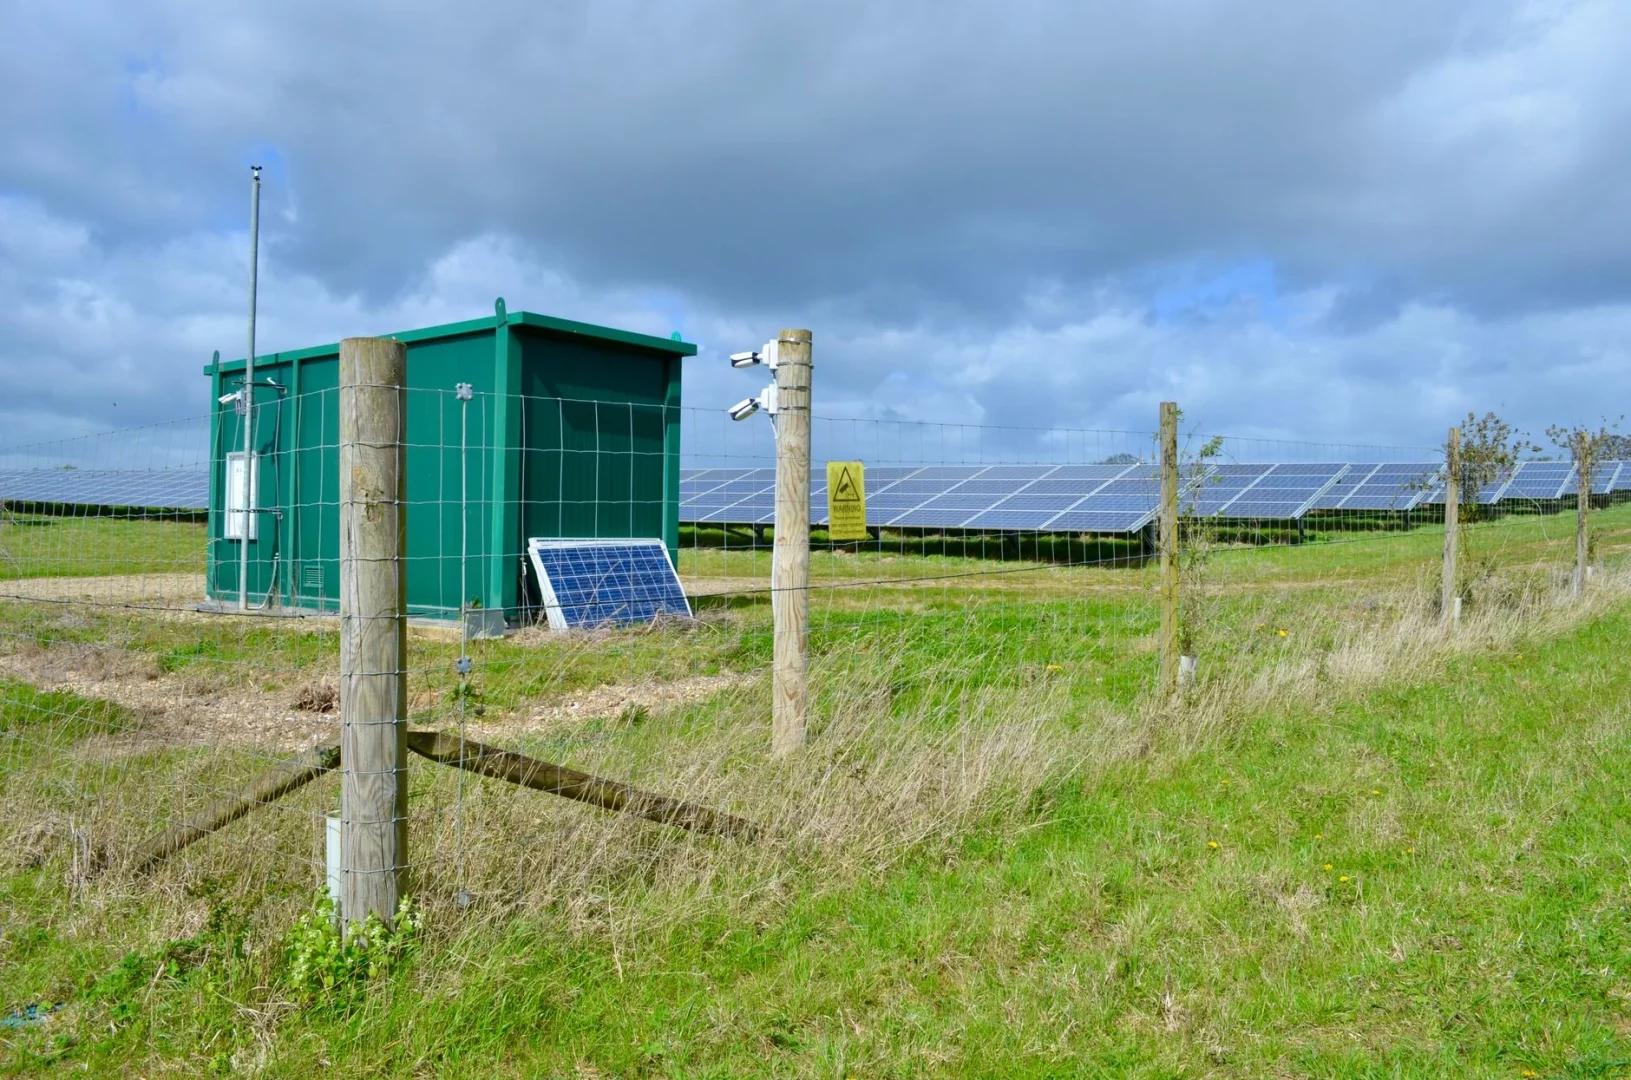
В сельскохозяйственной зоне Виладеканса заработала пилотная установка проекта CONFETI. Она производит мочевину из углекислого газа и нитратов. Систему разработали участники проекта под координацией Автономного университета Барселоны. Электрохимический реактор получает электричество от солнечных пане
 Наука
3
мин
29.10.2026
Вспышка кори в Канаде показала, как локальные пробелы в вакцинации пересекают границы
Исследование, опубликованное 28 октября 2026 года в The BMJ, описало вспышку кори в Онтарио, которая продолжалась с 28 октября 2024 года по 6 октября 2025 года. За 49 недель зарегистрировали 2 377 случаев: 2 064 подтвержденных и 313 вероятных. В ноябре 2025 года Канада утратила статус страны, свобод
 Образование
3
мин
29.10.2026
Четвёртая смена программы ЦМС: в Москве занимаются 40 школьников из четырёх стран
На четвёртой смене краткосрочной образовательной программы Центра международного сотрудничества Минпросвещения России (ЦМС) в Москве занимаются 40 школьников. Об этом 28 октября сообщила «Российская газета»: участники приехали из Вьетнама, Монголии, Южной Осетии и Приднестровья.Содержание смены газе
 Полезные материалы
18
мин
29.10.2026
52761
Как подготовить речь на защиту диплома?
Речь на защиту диплома помогает комиссии понять, какую задачу вы решали, что сделали лично и чем подтверждается результат. Для этого недостаточно сократить введение и прочитать подписи к слайдам. Нужно превратить содержание собственной ВКР в последовательный устный рассказ: поставить вопрос, объясни
 Дипломы
18
мин
29.10.2026
50433
Защита дипломной работы. Сроки. Как проходит
Защита дипломной работы начинается не с выхода к экрану, а с проверки допуска, графика и правил своей программы. Дата защиты, срок загрузки текста и время доклада — разные контрольные точки. Если перепутать их, хорошо подготовленное выступление не устранит пропущенный срок представления ВКР. Ниже —
 Диссертации по темам
7
мин
29.10.2026
Почему «виртуальная клетка» пока не заменяет эксперимент
Представим, что исследователь хочет заранее выяснить, как опухолевая клетка ответит на лекарство. «Виртуальная клетка» обещает превратить этот вопрос в вычисление: дать модели описание клетки и вмешательства и получить прогноз. Но клетка не сводится к набору показателей. Гены связаны регуляторными с