
Содержание статьи
Почему подбор кодов помещений упирается в разногласия проектов, а не в метрику сходства строк
Полезные материалы
03.10.2026
03.10.2026
15
мин
В жилом доме сотни помещений, и в модели они называются так, как привыкла мастерская: «С/у», «Кладовка», «ПУИ/Мусороудаление (К1)», «Элетрощитовая жилой части». С 2026 года архитектурно-градостроительное решение в Москве сдаётся вместе с цифровой информационной моделью в IFC, и у каждого помещения должны быть заполнены два свойства: RUS_MSSK_SpaceAndZone_Code и RUS_MSSK_SpaceAndZone_Name — код и наименование по Московской строительной системе классификаторов (МССК), раздел «Помещения и зоны». Классификатор таких имён не знает. На вопрос «а если нужного нет?» проверяющие отвечают: берите близкое по смыслу.
Кирилл (kirbim), BIM-менеджер, вместе с коллегой Анастасией (@nobimnolife) написали отчёт о плагине IDS Core, который подбирает эти коды без нейросети. Это авторский кейс разработчиков, а не рецензированное исследование, и метрики здесь не подтверждены внешней проверкой. Но в нём есть редкая для инженерного поста вещь: числа, методика и признание того, где правильного ответа нет.
Что именно подбирают
МССК распространяется в свободном доступе. Раздел «Помещения и зоны» — это 638 кодов с иерархией по уровням: ПЗ 30 — помещения квартир, ПЗ 30 10 — жилые помещения, ПЗ 30 10 03 — жилая комната, ПЗ 30 20 13 — совмещённый санузел, ПЗ 31 — общественная зона, ПЗ 31 10 19 — санузел. Уровень кода задаётся столбцом, в котором стоит наименование, и это первое, что ломается при разборе «в лоб». Второе — не всё в разделе помещения: там живут границы участка, пожарные отсеки, этажи, зоны строительной площадки. Их исключили вместе с групповыми кодами, у которых есть дочерние, потому что помещению почти всегда нужен конечный код. Для подбора осталось 542 позиции.
Отдельная деталь, важная для всех, кто сдаёт модели: в файлах IDS для элементов перечислены все допустимые коды, а для помещений проверяется только то, что код заполнен. Неправильный код автоматическая проверка не поймает — его увидит человек. Значит, подбирать нужно аккуратно, а не «хоть что-нибудь».
Почему не нейросеть
Плагин работает в Revit, часто на машинах без свободного доступа в интернет. Нужна воспроизводимость: одно и то же имя сегодня и завтра должно давать один и тот же код. И при сомнении человек должен видеть, почему предложен именно этот код, а не «так решила модель». Поэтому сначала сделали детерминированный подбор, а нейросеть оставили на потом — для того, что не найдётся.
Путь одного имени
Подбор идёт по шагам, и первое точное совпадение его останавливает. Сначала нормализация: регистр, «ё», номера («Спальня 2», «Пом. 1.05», «(К1)»), знаки. Сокращения раскрываются словарём: «С/у», «Сан. узел» → санузел, «ЭЩ», «Эл.щитовая» → электрощитовая, «м/м» → машиноместо, «Тех.» → техническое. Служебные слова — «помещение», «комната», «для» — в ключ сравнения не входят, иначе «Спальная комната» и «Спальня» оказываются разными помещениями.
Дальше идут слои словаря синонимов: типовые имена жилья, примеры заполнения реальных проектов, свой файл пользователя. Точное наименование МССК принимается только если оно однозначно: «Кладовая» в классификаторе есть и как «ПЗ 31 10 04 Кладовая», и как часть «Кладовая тары», «Кладовая овощей», и точным совпадением считается только первое. Затем отбрасывается всё после /, ,, ; — «ИТП, Насосная и Водомерный узел» это одно помещение с тремя функциями, а код в таких случаях ставят по первой. И только если ничего точного не нашлось, включается поиск похожих имён.
Левенштейн, который врёт на морфологии
Для похожих имён первым делом берётся расстояние Левенштейна — минимальное число вставок, удалений и замен букв, чтобы превратить одно слово в другое. Считается классическим динамическим программированием по таблице (|a|+1) × (|b|+1), где d[i][j] — минимум из d[i-1][j] + 1 (удалить), d[i][j-1] + 1 (вставить) и d[i-1][j-1] + (a[i] == b[j] ? 0 : 1) (заменить). Хранить всю таблицу не нужно, хватает двух строк. Сходство — 1 − d / max(|a|, |b|).
На опечатках это работает отлично: «элетрощитовая» и «электрощитовая» отличаются одной вставкой, сходство 0,93. А на русской морфологии — плохо. «Раздевалка» в модели и «Раздевальная» в классификаторе — одно и то же помещение, но для Левенштейна это три правки из двенадцати букв, 0,75, на грани «не похоже». Полноценный морфологический анализатор в плагин тащить не хотелось, поэтому правило получилось грубым, но рабочим: если у слов общее начало от четырёх букв и обрывается оно не раньше чем за две буквы до конца короткого слова — сходство 0,9. «Раздевал-ка» и «раздевал-ьная», «спальн-я» и «спальн-ая» проходят, «кладовая» и «кладбище» — нет.
Сравнивать имена целиком тоже не получается: мешает порядок слов («Комната жилая»), лишние уточнения, слитное написание. Поэтому итоговая оценка складывается из двух частей: 0,7 — сходство по словам, где каждое слово ищет самое похожее на другой стороне, и 0,3 — триграммы, коэффициент Дайса по тройкам букв, которые ловят то, что ломает слова: «венткамера» и «вент. камера», «техпространство».
Первая версия считала сходство по словам симметрично и споткнулась на самом частом случае. «Элетрощитовая жилой части» против «Электрощитовая»: слово «электрощитовая» в имени нашлось, а «жилой» и «части» пары не имеют — и оценка проваливается ниже порога. Лишние уточнения в именах помещений — норма, а не исключение. Поэтому сейчас важнее, чтобы в имени нашлись все слова наименования МССК (55 % оценки), чем чтобы каждое слово имени нашло себе пару (45 %). А первое слово имени весит вдвое: «Кладовая продуктов» — это кладовая, а не продукты.
Пороги такие: от 88 % код отмечается сам, но строка подсвечивается жёлтым; от 62 % предлагается без отметки; ниже — «не найдено» и список ближайших. И отдельное правило: если два разных кода идут почти вровень (разница меньше 4 %), галочка не ставится никогда.
506 имён и первые 47 %
Без данных все эти веса — гадание. Коллеги дали таблицы заполнения реальных проектов — «имя помещения → код МССК», шесть таблиц, 519 пар, 506 уникальных имён. Там много неожиданного: «Лапомойка», «Бьюти пространство», «КНС».
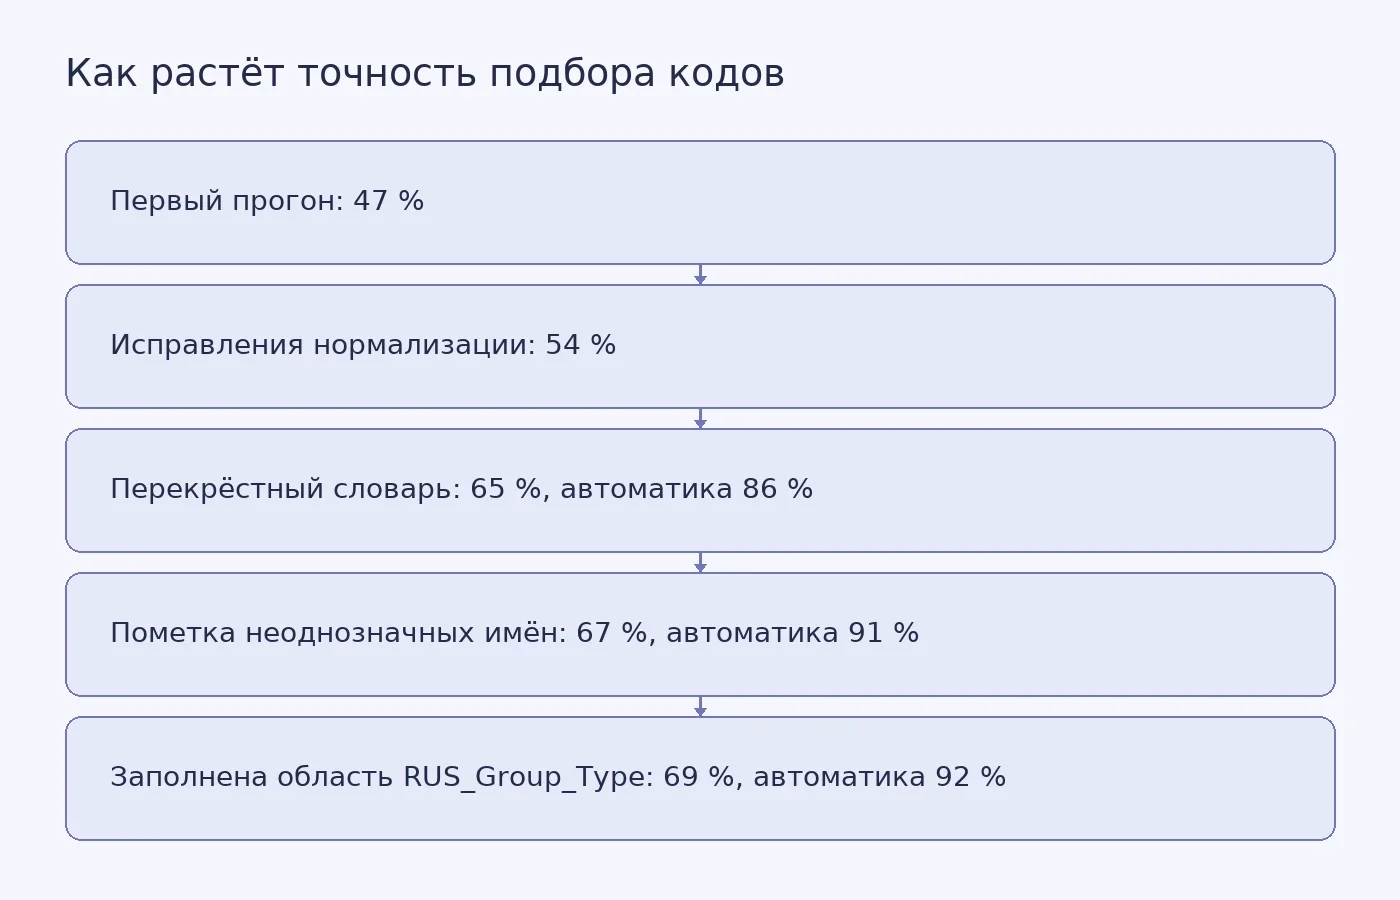
Первый прогон — только классификатор и поиск похожих — дал 47 % верных кодов. Разбор ошибок оказался полезнее любых формул. «C/У» во многих моделях набрано латиницей, и нормализация превращала его в пустую строку; теперь латинские буквы, похожие на кириллические, заменяются в словах, где есть кириллица, и в коротких словах вроде «C». Скобки сначала отбрасывались вместе со вторичными функциями, и это сломало «Кладовая (Сухие продукты)» и «Помещение персонала (Гардероб)»: в скобках оказалось уточнение типа, а номера вида «(К1)» и так уходят на нормализации. Отбрасывать стали только то, что после /, ,, ;. «Раздевалка Ж» — женская, но «Спортзал 20х40 м» — метры, поэтому одиночная «м» сразу после числа не раскрывается. С этими исправлениями получилось 54 %.
Честная проверка и ловушка копий
Самое простое — положить пары из таблиц в словарь и проверить на них же. Получится 96 %, и это ничего не значит: на новом проекте таких имён не будет. Поэтому проверяли перекрёстно — словарь строится без одной таблицы, проверка идёт на ней, и так по очереди. Тут вылезла ловушка: таблицы копируют из проекта в проект. Одинаковые листы в разных книгах — по сути одна таблица, и если её копия осталась в обучающей части, проверка снова завышена. Листы с одинаковым содержимым склеили в одну группу.
Перекрёстно словарь поднял точность до 65 %. И уронил то, что важнее: из автоматически отмеченных верными оказалось 86 % вместо 90 %. Автоматика стала чаще ошибаться уверенно. Это и есть ответ на вопрос, вынесенный в заголовок: рост метрики сходства сам по себе не делает подбор надёжнее, если он повышает цену ошибки на тех строках, где система поставила галочку.
Проекты не согласны друг с другом
Причина — не алгоритм. Одиннадцать имён в разных проектах получили разные коды. «С/у» — ПЗ 30 20 13 (квартира) и ПЗ 31 10 19 (МОП). «Гардероб» — ПЗ 30 20 04 и ПЗ 31 08 03. «Помещение СС» — ПЗ 31 09 02, ПЗ 31 13 12, ПЗ 31 13 14 и ПЗ 31 13 21. «ПОН» — ПЗ 31 09 01 и ПЗ 31 13 11. «Помещение отдыха» — ПЗ 12 и ПЗ 31 12 05. «Обеденный зал» — ПЗ 31 14 01 и ПЗ 31 14 02.
Часть расхождений законна: санузел в квартире и санузел в местах общего пользования — действительно разные коды. Такие записи развели по области. Часть решается большинством. А для остальных — «Помещение СС» с четырьмя кодами в четырёх проектах — правильного ответа у авторов нет, и делать вид, что он есть, хуже, чем промолчать. Такие имена помечены как неоднозначные: варианты из проектов попадают в список похожих, но сами не ставятся. Это вернуло точность автоматики к 91 %, а общую подняло до 67 %.
Разведение по области работает, только если область известна. В ЦИМ её задаёт RUS_Group_Type: «Квартира» — помещение квартиры, другое значение — нет. С заполненной областью точность выросла до 69 %, автоматики — до 92 %. Если тип группы пуст, а код от него зависит — санузел, коридор, холл, кладовая, балкон — плагин код предлагает, но не отмечает и прямо пишет: заполните тип группы. Угадывать здесь хуже, чем спросить.
Общий словарь без утечек
Каждый ручной выбор уходит в файл словаря, и файл можно положить в общую папку отдела. Логичный следующий шаг — общий словарь для всех, кто пользуется плагином. Он есть, но с двумя ограничениями. Делиться решениями — по согласию, и уходят только нормализованное имя без номеров, область и код; модель, проект, площади — нет. А в общий словарь имя попадает, только когда тот же код для него независимо подтвердили как минимум две разные организации. Пробные учётные записи привязаны к компьютеру и легко размножаются, поэтому их голоса копятся, но в порог не идут. Иначе уникальное название из одного проекта увидели бы все.
Что из этого следует
На незнакомом проекте плагин верно подбирает код примерно для двух имён помещений из трёх, а среди тех, что отметил сам, ошибается примерно в одном случае из двенадцати. Остальное — жёлтые строки с вариантами и красные с поиском по классификатору. Раньше на заполнение одного корпуса могло уйти несколько часов сравнивания классификатора и спецификации.
Выводы, которые не зависят от конкретного инструмента, авторы формулируют так: Левенштейн хорош для опечаток и плох для морфологии, и для русских слов без простого правила общей основы он отбрасывает очевидные пары. Проверка на тех же данных, на которых строили словарь, бесполезна, а копии таблиц между проектами незаметно её завышают. И главное: потолок точности здесь задают не формулы, а разногласия в самих данных. Модель, которая «уверенно» выбирает одно из четырёх мнений, вредна — честнее показать все четыре.
Наша интерпретация отличается от авторской только акцентом. Кейс показывает, что для такой задачи метрика сходства строк — не главный показатель качества. Куда важнее, как система ведёт себя на неоднозначных именах и как она защищена от утечек между проектами: и то и другое прямо влияет на долю ошибок среди уверенных решений, а именно их пользователь и не проверяет. Ограничения здесь тоже честные: выборка — шесть таблиц реальных проектов одной предметной области (МССК), переносимость на другие классификаторы и регионы не проверялась, а пороги 88 %, 62 %, 4 % и веса 0,7/0,3, 55/45 подобраны эмпирически на этих же данных, без внешней валидации. Так что числа стоит читать как результат одного аккуратно описанного кейса, а не как воспроизводимую оценку метода.


Похожие статьи
 Полезные материалы
12
мин
31.10.2022
21092
Программы которые помогут написать диплом, реферат или курсовую работу
Чтобы дипломы, курсовые и рефераты были выполнены в соответствии с требованиями ГОСТ и методическими рекомендациями вуза, автору рекомендуется использовать соответствующие текстовые редакторы для набора и редактирования текста. 5 лучших текстовых редакторов для написания дипломов, курсовых, рефе
 Полезные материалы
9
мин
12.11.2024
70741
Введение к курсовой работе: как начать писать и как оформить
Введение – это одна из основных структурных единиц курсовой работы. В этом разделе автору необходимо раскрыть основополагающие идеи научного труда, обосновать актуальность, правильно аргументировать цель и задачи, выявить объект и предмет исследования, рассказать о теоретической важности и мет
 Полезные материалы
11
мин
28.12.2022
30372
Структура диплома. Как правильно составить структуру
Структура дипломной работы выстраивается с учетом логики проведенного исследования, разработанного для решения поставленных задач по теме ВКР. Строгая последовательность структурных элементов в дипломе регламентирована требованиями ГОСТ и, в ряде случаев, методическими рекомендациями учебного заве
 Полезные материалы
5
мин
02.03.2023
25770
Оформляем правильно введение реферата
Правильное введение реферата – это краткая версия основной части работы. В этом разделе студент обобщает направление исследования, дает характеристики главного вопроса/рассматриваемой проблемы. Основная задача автора реферата в данном случае: научиться правильно излагать собственные суждения и
 Полезные материалы
11
мин
27.02.2026
1
Как студенту собрать научное портфолио (CV, публикации, проекты) для магистратуры, PhD и грантов
Научное портфолио – это удобный способ систематизировать собственные достижения на академическом поприще: публикации исследований в журналах, участие в конференциях, проектах, оплачиваемых стажировках, получение грантовых выплат и т.д. Специалисты рекомендуют формировать портфолио с первых кур
 Полезные материалы
11
мин
28.09.2022
52761
Как подготовить речь на защиту диплома?
Речь на защиту (доклад) – это документ, состоящий из 10 структурных частей: обращение докладчика к комиссии, тема дипломной работы/проекта, вступление, краткое описание актуальности, объекта/предмета исследования, ссылки на соответствующие страницы презентации/листы наглядных пособий, выводы
Последние новости и статьи
 Полезные материалы
10
мин
03.10.2026
Почему пожилые люди особенно уязвимы к последовательным катастрофам
Человек 78 лет, диабет второго типа, начальная деменция, живёт один в небольшом городке. Лекарства принимает исправно, раз в месяц ездит к врачу, соседей знает. Ураган выбивает электричество на неделю. Инсулин надо держать в холоде, аптека затоплена, дороги перекрыты, а он не вполне понимает, что пр
 Полезные материалы
9
мин
03.10.2026
Айсберг размером с Гренландию: что физика ледовых щитов говорит о катастрофе из фильма Digger
В фильме Digger, вышедшем в 2026 году, Том Круз играет одержимого нефтяного магната, чьё бурение приводит к отколу гигантского айсберга от Гренландии. Айсберг, названный климатологами в фильме Джуди, дрейфует к Европе и угрожает Норвегии цунами. Сюжет напряжённый, но он смешивает два разных процесса
 Полезные материалы
12
мин
03.10.2026
Что снимок сетчатки может рассказать о риске фибрилляции предсердий
На OCT-снимке глазного дна видны не только общие контуры сетчатки, но и ее отдельные слои. Один из них, макулярный комплекс ганглиозных клеток и внутреннего плексиформного слоя, обозначают как mGCIPL. В исследовании двух британских когорт этот слой оказался тоньше у людей с фибрилляцией предсердий,
 Наука
3
мин
02.10.2026
В Салиш-Си описали два новых вида морских пауков
Исследователи из Университета Британской Колумбии описали два ранее неизвестных вида морских пауков, или пикногонид, в экорегионе Салиш-Си у западного побережья Канады. Статья вышла 26 августа 2026 года в журнале Organisms Diversity & Evolution. Научно-популярный журнал Nautilus назвал находку п
 ИИ в образовании
5
мин
02.10.2026
Немецкие учёные научили ИИ переносить прогноз времени удерживания между хроматографами
Исследователи Университета Фридриха Шиллера в Йене, Центра Гельмгольца в Мюнхене и Технического университета Мюнхена создали модель 2-step, которая предсказывает время выхода малых молекул из хроматографической колонки на новой измерительной системе. Статья вышла 1 октября 2026 года в Nature Methods
 Наука
3
мин
02.10.2026
Зимнее усиление грибковой инфекции изменило выпуск йосемитских жаб в природу
Исследователи Калифорнийского университета в Лос-Анджелесе и национального парка Йосемити обнаружили, что инфекция грибком Batrachochytrium dendrobatidis (Bd) сильнее всего нарастает у йосемитских жаб во время зимовки в подземных норах. О результате UCLA сообщила 1 октября 2026 года в материале, опу