


Содержание статьи
Помощь по написанию
29.10.2026
29.10.2026
7
мин
Три идентификатора и два значения иногда дают две аккуратные пары, и Python молчит. Если вы ждали три пары, результат нельзя сразу пускать в расчёт. Важно понять, где останавливается zip, что проверяет strict=True и почему равная длина ещё не доказывает, что записи соответствуют друг другу.
Пример учебный: r01, r02, r03 и баллы придуманы. В первом варианте две последовательности специально сделаны разной длины: в ids три элемента, а в values — два. Код выполнен в Python 3.12.14. Поведение функции сверено с документацией ветки 3.12. Реальную потерю ответов мы здесь не моделируем и причину не устанавливаем.
Обычный zip останавливается на коротком входе
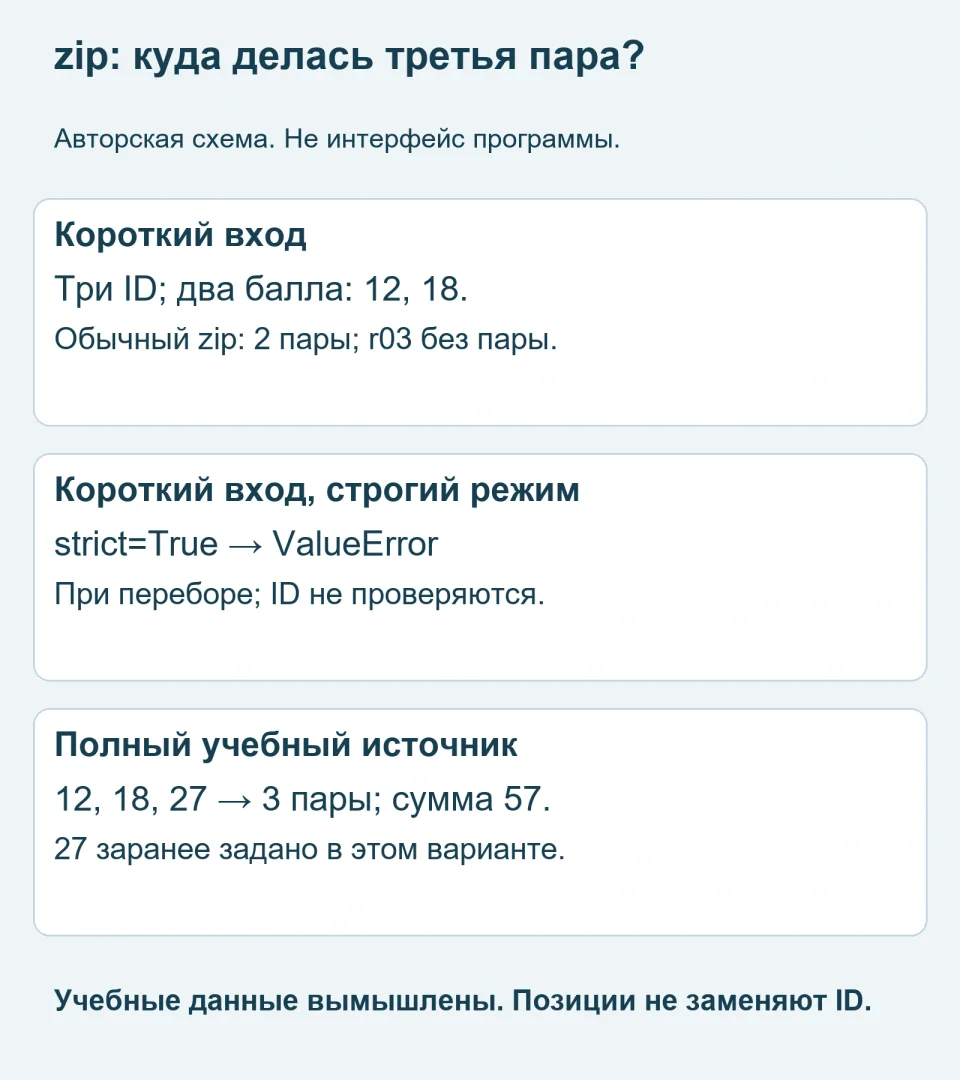
По официальному описанию zip, функция создаёт итератор кортежей: элементы соединяются по позиции. По умолчанию перебор заканчивается, как только исчерпан самый короткий вход. Оставшиеся элементы более длинного входа не входят в результат. Исходные списки при этом не укорачиваются.
| Учебный вход | Что задано |
|---|---|
| Идентификаторы | r01, r02, r03: три элемента. |
| Первый список баллов | 12, 18: два элемента. |
| Обычный результат | (r01, 12), (r02, 18): две пары; r03 без пары. |
| Полный второй вариант | 12, 18, 27: отдельный учебный источник с тремя баллами. |
В первом варианте мы знаем только то, что длины не совпали. Ни сама функция, ни число полученных пар не говорят, почему третьего значения нет. Называть r03 отказавшимся участником или ставить ему ноль нельзя. Во втором варианте 27 заранее задано в отдельном полном учебном источнике. Это не восстановление пропавшего балла из первого списка.
Полный код: короткий вход, исключение и полный вариант
Переменная default_pairs хранит обычный результат. Следующий вызов полностью перебирает строгий итератор внутри list, а ValueError перехватывается отдельно. На втором учебном наборе выходит три пары, сумма баллов равна 12 + 18 + 27 = 57. Это контрольное вычисление для показанного набора, а не показатель качества исследования.
ids = ["r01", "r02", "r03"]
values = [12, 18]
default_pairs = list(zip(ids, values))
print("default =", default_pairs)

caught = False
try:
    strict_pairs = list(zip(ids, values, strict=True))
except ValueError as exc:
    caught = True
    print("strict_error =", type(exc).__name__)

complete_values = [12, 18, 27]
complete_pairs = list(zip(ids, complete_values, strict=True))
total = sum(value for _, value in complete_pairs)
print("complete =", complete_pairs)
print("total =", total)
assert default_pairs == [("r01", 12), ("r02", 18)]
assert caught
assert complete_pairs == [("r01", 12), ("r02", 18), ("r03", 27)]
assert total == 57
assert ids == ["r01", "r02", "r03"]
assert values == [12, 18]
Фактический вывод учебного кода:
default = [('r01', 12), ('r02', 18)]
strict_error = ValueError
complete = [('r01', 12), ('r02', 18), ('r03', 27)]
total = 57
Проверки assert отдельно сверяют обе структуры, сам факт перехвата исключения, сумму и то, что исходные списки не изменились. Печатается только имя класса ValueError, без текста сообщения. В упражнении важен вид ошибки, а не совпадение формулировки с другой версией инструмента.
Когда именно срабатывает strict=True
Аргумент strict появился в Python 3.10; учебный пример в этой статье выполнен в Python 3.12.14.
zip работает лениво. Создать итератор ещё не значит обработать элементы. Документация показывает ValueError при переборе входов разной длины. Если итератор не читали вовсе или остановились раньше места несовпадения, проверка всей длины не завершена. В нашем коде list запрашивает весь результат, поэтому дело доходит до этой проверки.
Строгий режим не превращает цикл в атомарную операцию. Пока не найден короткий вход, итератор уже может выдать предыдущие пары. Если цикл сразу пишет строки во внешний файл, запись могла произойти до исключения. Обработку ошибки стоит планировать заранее. Первые правильные строки ещё не означают, что результат готов.
| Проверка | Что она подтверждает и чего не подтверждает |
|---|---|
| Обычный list(zip(...)) | Созданы пары до самого короткого входа; равенство длин не проверено. |
| Полный перебор с strict=True | Обнаруживается несовпадение длин; правильность ID и значений не устанавливается. |
| Равные длины | Количество элементов совпало; порядок и соответствие записей всё ещё нужно обосновать. |
| Сверка по ключу | Для двух самостоятельных таблиц проверяют сами ID, кратность и несовпавшие ключи. |
Как использовать результат в работе с данными
Если позиции действительно связаны правилами исходного формата, запишите это условие и проверьте длины. Для двух независимо выгруженных таблиц одинаковое число строк недостаточно: их порядок может различаться. Тогда применяют сопоставление по явному ключу, как в примере объединения таблиц по ID и проверки несовпадений. Эта статья про другую операцию и не заменяет проверку поведения zip.
- Сохраняйте исходные последовательности и правило, по которому позиции считаются соответствующими.
- Если длины должны совпадать, задайте strict=True и доведите перебор до конца.
- При исключении сохраните диагностику. Не добавляйте выдуманные значения только ради нужной длины.
- До расчёта отдельно проверьте, что означает пара, какие в ней типы и какие записи вообще включены.
В этом упражнении вывод ограничен двумя случаями. Короткий список даёт две обычные пары и ошибку при полном строгом переборе. Второй, полный список даёт три пары и сумму 57. Эти числа не описывают реальных людей и не доказывают полноту чужой выгрузки.
Если нужна помощь с подготовкой собственного набора к расчётам, можно обсудить статистический анализ. Передайте структуру файлов, смысл ключей и исследовательский вопрос, затем согласуйте объём консультации и правила обработки несовпадений.


Похожие статьи
 Помощь по написанию
25
мин
27.05.2022
13630
Как написать и оформить докторскую диссертацию?
Что такое докторская диссертация? Докторская - это фундаментальный научно-исследовательский труд, направленный на поиск решений актуальных проблем для развития выбранной отрасли знаний. Суть работы сводится к разработке/совершенствованию значимых результатов, способствующих дальнейшему техничес
 Помощь по написанию
13
мин
22.06.2022
11287
Как написать диссертацию по менеджменту?
Диссертация по менеджменту – это выпускная работа учащегося магистратуры, аспирантуры и докторантуры, отображающая способности автора разрабатывать теоретические/практические решения проблем управления на производственных мощностях, улучшать существующие социально-экономические механизмы разно
 Помощь по написанию
12
мин
27.12.2024
13598
Требования к статьям для публикации в РИНЦ
Публикация статей в РИНЦ – обязательное условие для получения объективной оценки диссертационного исследования. Зачем публиковать статьи в РИНЦ Выполнение требований РИНЦ по оформлению структуры и содержания статьи ускорит публикацию в системе. Высокий рейтинг выбранного журнала, на
 Помощь по написанию
5
мин
08.06.2024
23595
Как составить план научной работы?
Научно-исследовательская работа связана со сбором необходимых материалов, анализом литературных источников и проведением экспериментов, целью которых является получение важных для науки выводов. Зачем нужен план научной работы Чтобы деятельность ученого или аспиранта дала положительный результ
 Помощь по написанию
17
мин
24.12.2023
11637
Антиплагиат диссертаций
Написание диссертации — колоссальный труд, требующий больших временных затрат и усилий от соискателя. Доработка готового текста может отнять многие дни, поскольку к научному труду предъявляются высокие требования, касающиеся уникальности. Что такое проверка на антиплагиат? Пр
Последние новости и статьи
 Наука
4
мин
29.10.2026
Гибкая накладка на стопу позволила прыгающему роботу Hopcopter лучше двигаться по песку и льду
Инженеры Университета Торонто 28 октября 2026 года показали гибкую накладку на единственную ногу Hopcopter, робота, который передвигается прыжками. С ней машина перестала проваливаться в песок и буксовать на льду. Ошибка взлёта снизилась максимум на 66%, эффективность выросла максимум на 64%, а разн
 Наука
4
мин
29.10.2026
Сотаглифлозин снизил активацию тромбоцитов в лабораторных экспериментах
14 октября 2026 года в журнале Journal of Clinical Investigation вышла статья исследователей Мичиганского университета. В опытах с кровью доноров и на мышах сотаглифлозин подавлял активацию тромбоцитов и образование тромба. Эмпаглифлозин в тех же условиях почти не действовал. Оба препарата относятся
 Вузы
6
мин
29.10.2026
Университет Провиденс в Монтане закроется в августе 2027 года
Совет попечителей Университета Провиденс в Грейт-Фолсе, штат Монтана, проголосовал за прекращение образовательной деятельности. Голосование прошло во вторник 27 октября 2026 года в 8:45 утра. Последний день занятий назначен на 20 августа 2027 года. После него часть академической и административной р
 Диссертации по темам
6
мин
29.10.2026
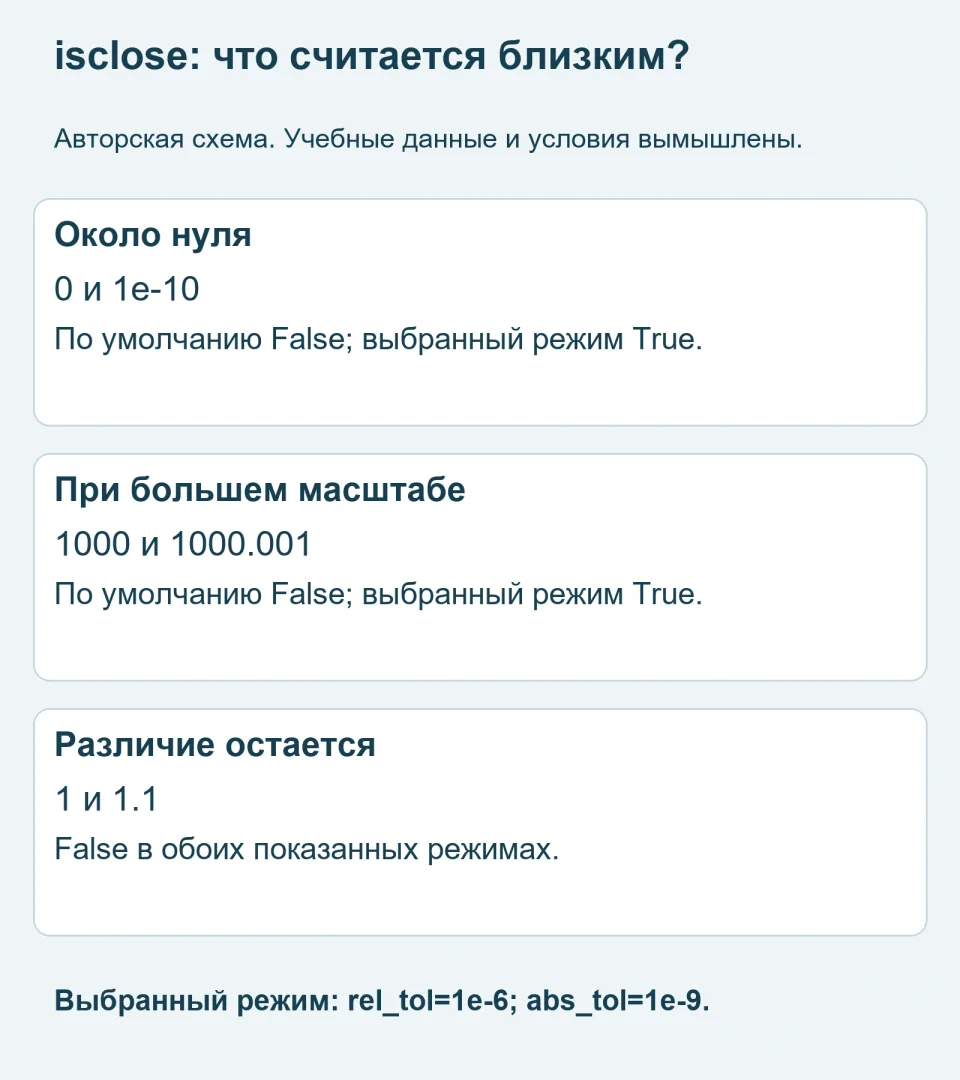
math.isclose около нуля: зачем задавать абсолютный допуск
Два очень маленьких числа кажутся одинаковыми для задачи, но math.isclose возвращает False. Обычно дело не в том, что Python «сломался», а в том, какой допуск указан в вызове. На трех учебных парах разберем разницу между относительным и абсолютным допуском и проверим, почему сравнение с нулем требуе
 Дипломы
7
мин
29.10.2026
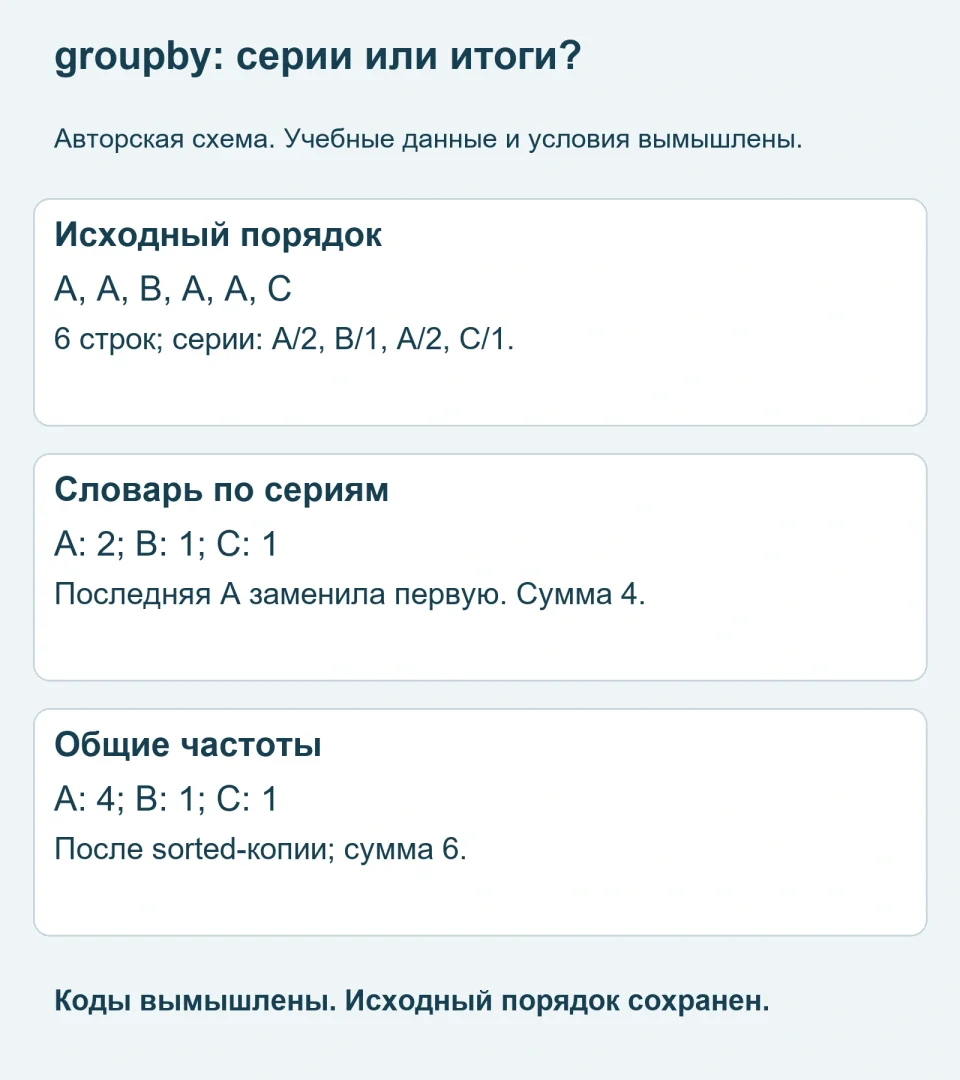
itertools.groupby: почему одинаковые коды попадают в разные группы
В учебной последовательности шесть строк: A, A, B, A, A, C. Если превратить размеры соседних серий в словарь с ключом-кодом, сумма его значений окажется равна четырём: ранняя серия A будет заменена поздней. Строки не исчезли из исходного файла: ошибочным оказался переход от соседних серий к общим ча
 Полезные материалы
13
мин
29.10.2026
22697
Перечень рецензируемых научных журналов ВАК
Перечень ВАК помогает проверить, подходит ли научное издание для публикации результатов диссертации. Одного знакомого названия недостаточно: сопоставляют ISSN, научную специальность, отрасль науки и даты в официальных документах. Категорию журнала и требования к своему виду диссертации проверяют отд