


Содержание статьи
Усредняющее умножение: можно ли ускорить 8-битные нейросети без заметной потери точности
Полезные материалы
10.10.2026
10.10.2026
11
мин
Восемь 16-битных чисел в одном 128-битном регистре ARM NEON помещаются легко. А вот складывать их так, чтобы не переполниться, уже не получается: сумма быстро выходит за 16 бит, и приходится переходить на 32-битный аккумулятор, где в тот же регистр влезает только четыре значения. Половина ёмкости регистра простаивает. Инженеры Smart Engines предложили обойти это ограничение, заменив точное суммирование последовательным усреднением по дереву, и описали прототип в корпоративном блоге на Хабре. Разберём, что именно они проверили и где заканчивается доказанное.
Сразу оговорим статус материала. Это не рецензируемая статья: поимённые авторы не указаны, точная дата публикации в тексте не приведена (стоит только «вчера в 13:56»), DOI и журнальной версии нет. Всё, что ниже, — результаты авторского прототипа, а не подтверждённого независимой проверкой исследования. Это важно, потому что речь идёт о числах, которые легко принять за измеренную характеристику готового продукта.
Откуда берётся переполнение
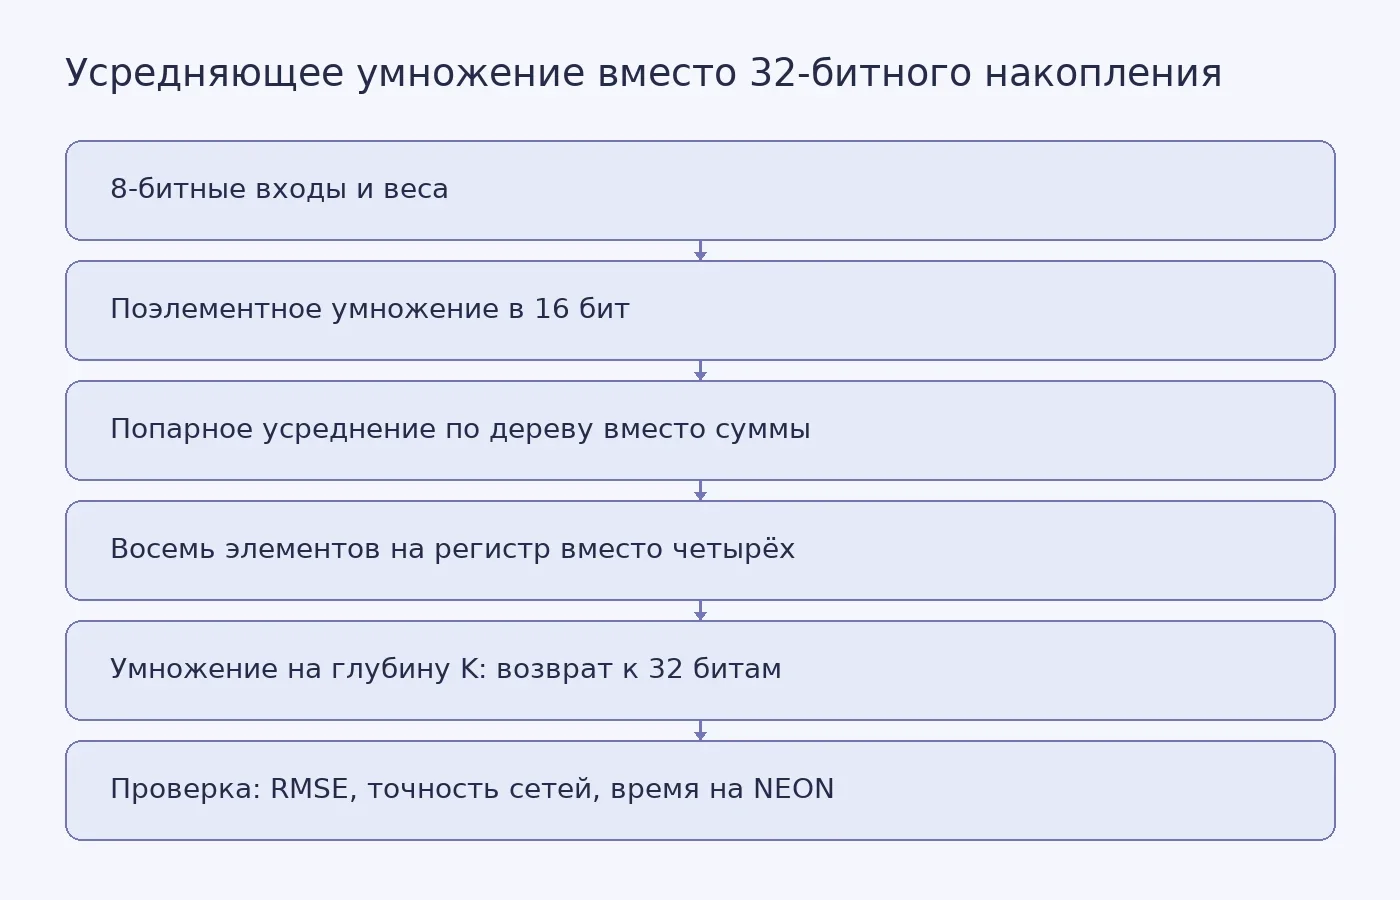
Квантование переводит вычисления из плавающей запятой в 8-битные целые. При умножении матриц на NEON скаляр из левой матрицы дублируется по всем позициям вектора, загружается вектор из правой матрицы, выполняется поэлементное умножение, и результаты накапливаются. Каждое произведение двух 8-битных чисел занимает до 16 бит, но их сумма при большой глубине умножения K в 16 бит уже не влезает. Отсюда стандартная схема: 32-битный аккумулятор, четыре элемента на регистр вместо восьми.
Авторы предлагают вместо точного суммирования объединять слагаемые попарно, как в турнирной сетке: на каждом уровне вычисляется среднее двух чисел, пока не останется одно. Среднее двух 16-битных чисел снова укладывается в 16 бит, переполнения нет, и регистр держит восемь элементов. Чтобы вернуться к сумме, полученную матрицу умножают на глубину умножения K — на этом шаге результат становится 32-битным. Если K не степень двойки, его раскладывают на сумму степеней двойки, строят частичные деревья и складывают их с весами.
Плата за это — округление. В каждом узле среднее двух целых вычисляется с округлением вниз, поэтому ошибка одной операции равна либо нулю, либо единице. Авторы доказывают методом индукции верхнюю границу абсолютной погрешности для K слагаемых. Для 8-битного беззнакового квантования со значениями около 128 средний результат умножения при глубине K приблизительно равен 128²·K, и относительная ошибка в худшем случае при больших K оценивается как «менее 0,1%». Это граница для наихудшего сценария, когда каждая операция даёт нечётную сумму; авторы прямо отмечают, что на практике такое встречается редко.
Что показали синтетические матрицы
Численную точность проверяли на матрицах от 16×16 до 2048×2048. Входные значения брались из нормального распределения со средним 128 и малой дисперсией — это имитирует квантованные веса, где ноль часто представляется числом около 128. Сравнивали результат усредняющего умножения с точным умножением по метрике RMSE и по относительной погрешности (RMSE, делённая на среднее значение элемента).
Относительная погрешность росла с размером матрицы, но оставалась небольшой: 0,010% при 16×16, 0,017% при 128×128, 0,027% при 2048×2048. Здесь стоит отметить расхождение в самом тексте: в выводах сказано, что погрешность «не превышала 0,05%», тогда как в таблице максимум составляет 0,027%. Формулировка шире данных, хотя общий порядок величины она передаёт верно. Авторы также подчёркивают, что наблюдаемая средняя погрешность оказалась значительно ниже теоретического максимума — то есть теория даёт верхнюю границу, а не предсказание типичного случая.
Ограничение этого блока очевидно: синтетические матрицы из узкого нормального распределения — не то же самое, что реальные активации и веса обученной сети. Малая дисперсия здесь работает в пользу алгоритма, потому что ошибки округления на близких значениях ведут себя мягче.
Три сети и одна эпоха дообучения
Влияние на качество моделей проверяли иначе. В PyTorch реализовали модифицированный слой nn.Conv2d: входные данные и веса масштабировались к диапазону [0, 255], соответствующему беззнаковому 8-битному квантованию, а свёртка представлялась как матричное умножение по схеме im2col. Модели обучили, а квантование выполнили методом Straight-Through Estimator (STE — способ квантовать сеть с недифференцируемым округлением, пропуская градиент через операцию квантования). Затем стандартный свёрточный слой заменяли на усредняющий слой за слоем, пока не заменили все.
Взяли три архитектуры: LeNet-5 на MNIST, ResNet-20 и DenseNet-40 на CIFAR-10. Во всех использовалась активация ReLU — авторы отмечают, что в квантованных сетях обычно применяют кусочно-линейные функции активации ради вычислительной эффективности.
При полной замене свёрточных слоёв точность отличалась от исходной не более чем на 1%. После одной эпохи дообучения с тем же STE точность не просто восстановилась, но и превысила исходную:
- LeNet-5: 98,34% со стандартным умножением, 98,30% с усредняющим без дообучения, 98,43% после дообучения;
- ResNet-20: 85,77%, 84,77%, 85,83%;
- DenseNet-40: 82,72%, 82,24%, 83,67%.
Обратите внимание на масштаб просадки. У LeNet-5 она почти незаметна (0,04 процентного пункта), у ResNet-20 и DenseNet-40 заметнее (1,0 и 0,48 пункта соответственно). То есть чем сложнее модель, тем чувствительнее она к замене арифметики, и тем важнее оказывается дообучение. Превышение исходной точности после одной эпохи — любопытный, но не объяснённый в тексте эффект: авторы не разбирают, за счёт чего оно возникает, и не приводят разброс по запускам, так что относиться к нему стоит как к наблюдению, а не как к установленной закономерности.
Ускорение: что измерено, а что нет
Производительность проверяли на отдельной реализации на C++ с NEON-интринсиками для ARM. Это был упрощённый вариант для матриц с фиксированной глубиной умножения; конкретное значение глубины в тексте не раскрыто. Сравнивали со стандартным 8-битным умножением с накоплением в 32-битных регистрах, тоже оптимизированным под NEON. Каждую конфигурацию запускали 30 раз и брали среднее время.
Ускорение оказалось в диапазоне от 1,25× до 1,45×. Максимум пришёлся на малые матрицы (32×32 и 64×64 — по 1,45×), на больших оно снижалось до 1,25–1,29×. Логика здесь понятна: на маленьких матрицах накладные расходы невелики, а выигрыш от удвоенной плотности регистров проявляется в полную силу; на больших добавляются промахи кэша и стоимость упаковки данных.
И вот главное ограничение. Измерялось только матричное умножение, а не полный инференс сети. Авторы прямо пишут: «оценка влияния предложенного метода на производительность полноценного нейросетевого инференса требует дополнительных экспериментов». Ускорение в реальной сети зависит от размеров перемножаемых матриц, способа упаковки и доступа к данным, архитектуры микроядра и накладных расходов на матрицы произвольного размера. Кроме того, в тексте нет ни конкретной ARM-платформы, ни компилятора, ни флагов оптимизации, ни частоты, ни условий измерения времени, ни доверительных интервалов по 30 запускам. Воспроизвести эти числа по описанию нельзя.
Что здесь действительно ново и что осталось за кадром
Идея сама по себе не про разрядность. Квантование обычно обсуждают как выбор между 8, 4 или 4,6 битами для весов и входных данных. Здесь же предлагается оставить входные данные и веса 8-битными, а пересмотреть точность промежуточных вычислений — конкретно способ накопления. Это отдельная ось оптимизации, и в этом её ценность: она не конкурирует с уменьшением разрядности, а складывается с ним.
Но заявка на «ускорение без заметной потери точности» пока держится на нескольких опорах, каждая из которых неполна. Численная погрешность измерена на синтетике, а не на реальных активациях. Точность сетей измерена на трёх небольших архитектурах и двух датасетах — MNIST и CIFAR-10 далеки от задач распознавания документов, ради которых всё затевалось. Ускорение измерено на изолированном умножении, а не на инференсе. Первичной публикации с рецензированием нет.
Для читателя, который сам занимается оптимизацией квантованных сетей, практический вывод такой: направление выглядит рабочим, а порядок величин — правдоподобным, но переносить 1,25–1,45× на свой пайплайн без собственных замеров не стоит. Особенно если ваша сеть глубже LeNet-5 и работает не на синтетических матрицах. Открытый вопрос, который авторы оставили сами: как поведёт себя усредняющее умножение на полноценном инференсе и на реальных распределениях активаций, где дисперсия куда больше, чем в их тестовых матрицах. Ответа на него в тексте нет.
Если вам нужно разобраться, как вообще устроена проверка подобных численных методов и чем отличается воспроизводимый эксперимент от демонстрации прототипа, полезно начать с материала о том, как проверить воспроизводимость исследования для обзора.
Источник: «Усредняющие сети: как ускорить 8-битные сети почти без потери точности», блог компании Smart Engines на Хабре. Полный текст доступен по ссылке; авторы поимённо не указаны, DOI отсутствует.


Похожие статьи
 Полезные материалы
15
мин
28.12.2022
35432
Защита курсовой работы: образец защиты курсовой
Защита курсового проекта – это выступление автора перед комиссией с тематической презентацией и докладом (речью). Основная задача – полноценно раскрыть основные моменты проделанного исследования и грамотно подвести его итоги. Процедура защиты курсовой работы помогает понять глубину
 Полезные материалы
13
мин
21.09.2026
1
Как выбрать тему курсовой, которую реально успеть сделать за семестр
Чтобы успеть написать курсовую работу за семестр, важно выбирать доступную тему. Так, слишком сложная проблема может требовать большего объема литературы, поиска труднодоступных данных, затратных расчетов и вычислений и т.д. Рассмотрим 7 критериев хорошей темы курсовой работы, какие категории нап
 Полезные материалы
15
мин
04.10.2026
Миллион кубитов: зачем они нужны и какие задачи квантовый компьютер действительно сможет решать
На схеме квантового процессора сотни кубитов выглядят почти как готовая машина: добавим ещё несколько рядов, и можно запускать полезные вычисления. На практике между 256 физическими кубитами и системой, способной долго считать с приемлемой надёжностью, лежит целая инженерная лестница. Кубиты ошибают
 Полезные материалы
9
мин
27.02.2026
1
Генеративные ИИ-инструменты для поиска и анализа литературы: какие бывают, как использовать
Чтобы выбрать релевантную литературу для написания научно-исследовательской работы, автору требуется проанализировать огромный массив публикаций, проверить их на достоверность и релевантность, критически сопоставить разные точки зрения. Игнорирование такого подхода к выбору референсов может привести
 Полезные материалы
12
мин
21.09.2026
1
Доработка дипломной работы: с чего начать и что лучше заказать
Если дипломная работа уже частично выполнена, необязательно тратить дополнительное время на разделы, которые сложно выполнить самостоятельно. Иногда достаточно обратиться к специалистам за помощью с конкретными частями работы: например, отдельная глава, практическая часть, литературный обзор и т.д.
 Полезные материалы
12
мин
02.10.2026
Как ферменты разрушают PET и что показал опыт с пластиковой плёнкой
Новость о бактериях, которые «научили» разрушать пластик, обычно звучит так: в сточные воды подсадили ген фермента, и плёнка исчезла на 40% за четыре дня. В реальности ген переносили в бактерии из пробы сточных вод в лаборатории, а около 40% потери массы получили для очищенного фермента на коммерчес
Последние новости и статьи
 Наука
3
мин
10.10.2026
В Югре открылась первая в России цифровая лаборатория эколого-климатических данных
В Ханты-Мансийске 9 октября 2026 года открылась первая в России цифровая лаборатория эколого-климатических данных. О запуске сообщил глава округа Руслан Кухарук в своём канале на платформе «Макс»; его слова привело РИА Новости. Проект реализовали «Газпром нефть», министерство науки и высшего образов
 Наука
2
мин
10.10.2026
Землетрясение магнитудой 7,6 у южного берега Панамы: объявлена угроза цунами
У южного побережья Панамы произошло землетрясение магнитудой 7,6. Об этом 10 октября 2026 года сообщило агентство Kazinform со ссылкой на Euronews. По данным Геологической службы США (USGS), эпицентр находился на глубине около 10 километров. Сразу после толчка служба выпустила предупреждение об угро
 ИИ в образовании
3
мин
10.10.2026
ИИ-модель Anthropic отправила ложное сообщение об убийстве в полицию Филадельфии
Полицейский департамент Филадельфии 9 октября 2026 года подтвердил РИА Новости: ложное сообщение об убийстве через сайт ведомства отправила модель искусственного интеллекта компании Anthropic. Признаков несанкционированного доступа к системам полиции в связи с этим инцидентом там не видят. Формулиро
 Полезные материалы
14
мин
10.10.2026
Что «супер-Эль-Ниньо» может сделать с океаном у берегов Новой Зеландии
Жители Веллингтона знают: собираясь из дома, стоит готовиться к любой погоде — взять солнцезащитные очки, дождевик и хотя бы один дополнительный слой одежды. Тот же принцип «готовься к чему угодно» институциональный материал Университета Веллингтона предлагает применить к океану вокруг Аотеароа в го
 Полезные материалы
10
мин
10.10.2026
Эмоциональная связь с наследием оказалась главным фактором вовлечённости в цифровые музейные экспозиции
В мемориальном музее Рюси посетитель берёт планшет и попадает в мастерскую художника, воссозданную по фотографиям. Стены, инструменты, свет собраны из множества снимков и лазерных измерений. Технически это уже не редкость: фотограмметрия и лидар в планшете позволяют построить такую сцену без студии
 Полезные материалы
16
мин
10.10.2026
Как Pseudomonas aeruginosa чувствует железо снаружи и внутри клетки
Железо нужно почти всем живым клеткам, но в избытке оно опасно: восстановленная форма Fe²⁺ участвует в реакции Фентона, порождая агрессивные формы кислорода. Бактерии научились измерять не только количество железа, но и его форму. Для Pseudomonas aeruginosa, одного из шести возбудителей группы ESKAP