


Содержание статьи
Защита работ
08.11.2026
08.11.2026
8
мин
На снимке глиняной таблички буквы легко спутать с повреждениями поверхности. Тёмная борозда может быть частью надписи, а может оказаться следом скола или копоти. Программа, которая усиливает контраст и отделяет «текст» от «фона», делает изображение удобнее для поиска, но рискует принять повреждённую глину за буквы. Настоящие штрихи тоже могут исчезнуть, если алгоритм посчитает их помехой.
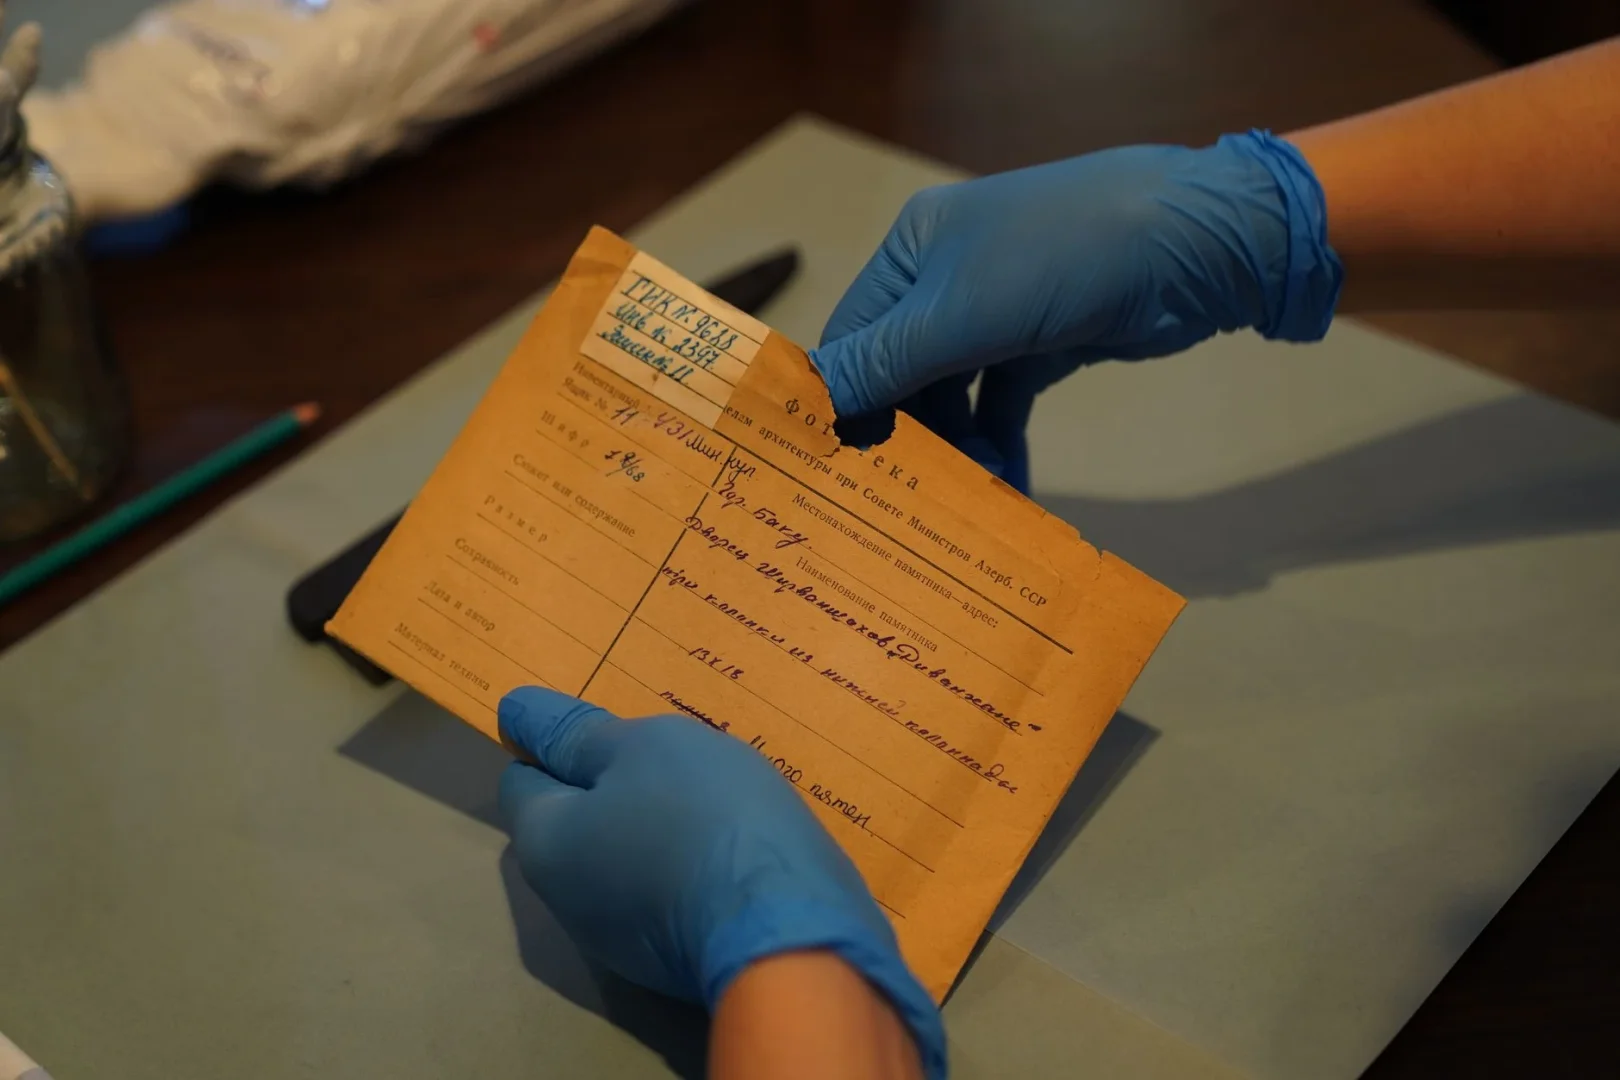
Эту проблему разбирает Яэль С. Хакохен в статье «Материальная неопределённость в вычислительном архивном процессе: последние записи Холокоста за пределами извлечения машинно-читаемого текста», опубликованной в журнале AI & Society 21 сентября 2026 года. Работа прошла рецензирование; полный текст доступен в открытом PDF издательства Springer. Автор предлагает смотреть на цифровую транскрипцию не как на прозрачное окно к документу, а как на цепочку преобразований, каждое из которых меняет то, что можно увидеть и найти.
Слова не всегда отделимы от поверхности
Хакохен называет «материальной неопределённостью» ситуацию, когда смысл текста нельзя отделить от повреждённой, нестабильной или импровизированной основы, на которой он сохранился. Для архива это значит, что пятно, складка, глубина резьбы или способ передачи документа могут быть не случайными помехами, а частью свидетельства.
Цифровая обработка обычно состоит из нескольких шагов: снимок выравнивают и усиливают, страницу делят на области, рукопись распознают, текст исправляют и переводят, затем создают метаданные и категории для поиска. Каждый шаг решает практическую задачу. Но в результате слова могут отделиться от рисунка, письмо от фактуры носителя, а вероятное прочтение от надёжно установленного.
Чтобы выяснить, где именно возникают потери, Хакохен проследила вычислительную обработку трёх объектов: иллюстрированного стихотворения Евы Шульцовой, глиняных табличек Элиэзера Хеймана и фрагмента ткани Сала Брамсона. Это не сравнительный тест систем и не оценка общей точности искусственного интеллекта. Автор изучала, что сохраняют и меняют отдельные операции, сопоставляя цифровые результаты с изображениями рукописей.
Три объекта, три разных сбоя
Шульцова написала стихотворение карандашом, когда была ребёнком и находилась в Терезине. Слова и рисунки на листе составляют единую композицию. Сегментация, то есть выделение отдельных областей изображения, помогала находить участки текста, но не сохраняла связь строк с рисунками. Метаданные могли указать, что на странице есть иллюстрации, но не объясняли, как они соотносятся со стихотворением. Сцену воображаемого праздничного угощения рядом с бараками можно было описать меткой вроде «натюрморт с едой». Для каталога она подходит, но упускает смысл, который возникает из сочетания рисунка и текста.
На глиняных табличках Хеймана надпись оказалось трудно отделить от повреждений поверхности. При обычной бинаризации, когда изображение делят на два класса, «передний план» и «фон», методы Сауволы и Оцу относили к переднему плану примерно треть поверхности глины, хотя надпись занимала намного меньшую площадь. В эту область попадали зернистость материала, отслаивающаяся охра, копоть и тени по краям. Усиление контраста делало заметнее и буквы, и повреждения. По выводу Хакохен, снимок уже не сохранял всю глубину и рельеф объекта. Последующая обработка не могла надёжно восстановить то, чего не было на цифровом изображении.
Случай Брамсона показывает другой риск. Находясь в амстердамской тюрьме, он рисовал камеру на кусках хлопковой ткани и добавлял пояснения. Фрагменты передавали его матери, пряча в воротнике среди тюремного белья. Устранение видимого переплетения ткани помогало различать отдельные отметки, но сам носитель был частью истории передачи сообщения. Рисунки и подписи направляли взгляд читателя вместе. Разделив объект на отдельные текстовые и графические области, можно получить материалы для поиска, но потерять связь между тканью, изображённым пространством, пояснениями и адресатом.
Как не выдавать вывод за прочтение
Из этих разборов Хакохен выводит практический принцип: цифровая система должна связывать каждый результат с исходным изображением и показывать, что именно изменилось. Пользователь должен видеть, какие части изображения усилили или подавили, какие слова распознала программа, что исправил человек и какие прочтения остаются предположительными. Гладкий перевод сам по себе не доказывает, что исходное слово прочитано верно.
Важно различать два источника потерь. Иногда нужная особенность не попала в цифровой снимок. Обычная фотография, например, может сгладить рельеф надписи, и тогда нужен другой способ съёмки. Для табличек Хеймана Хакохен предлагает рассмотреть съёмку при нескольких направлениях света, чтобы зафиксировать геометрию поверхности. В других случаях нужная информация видна на изображении, но исчезает при обработке. Так произошло со связью рисунков и слов у Шульцовой. Здесь нужно менять не освещение, а устройство обработки и описания.
Архивной системе стоит хранить связанные представления объекта, а не заменять их одной чистовой транскрипцией. Исходное изображение, обработанные версии, распознанный текст, перевод и метаданные должны оставаться сопоставимыми. Если чтение спорно, это нужно обозначить в записи, а не сглаживать при редактировании.
Что именно доказала статья
Выводы Хакохен относятся к конкретному типу вычислительной обработки, который извлекает текст поэтапно, выделяя области, символы и метаданные. Статья не доказывает, что любой цифровой инструмент неизбежно разрушает контекст, и не сравнивает разные модели по точности. Три объекта выбраны как намеренно неоднородные предельные случаи; анализ опирался на цифровые репродукции разного качества. Поэтому работа показывает возможные потери при обработке, но не даёт репрезентативной оценки архивов или всех систем распознавания.
Смысл работы не в отказе от поиска и транскрипции. Цифровые инструменты могут сделать рукописи доступнее тем, кто не умеет читать исходный язык или почерк. Но доступность полезна лишь тогда, когда интерфейс не превращает вероятное прочтение в установленный факт и не позволяет производному тексту вытеснить документ. О том, как распознавание рукописей помогает в повседневных задачах и где у него практические ограничения, подробнее рассказано в материале о приложениях для распознавания рукописного текста.
Источник
Yael S. Hacohen. “Material uncertainty in computational workflow in the archives: Holocaust last writings beyond machine-readable extraction.” AI & Society, опубликовано 21 сентября 2026 года. DOI: 10.1007/s00146-026-03378-y. Страница статьи у издателя, полный текст PDF.
Источники и литература
- What AI can lose when it makes Holocaust writings easier to read — пресс-релиз; доступный текст страницы
- Material uncertainty in computational workflow in the archives: Holocaust last writings beyond machine-readable extraction | AI & SOCIETY | Springer Nature Link — рецензируемая публикация; аннотация или страница публикации
- Digital technologies have made ancient manuscripts more accessible than ever, but there are risks and losses, too — тип публикации не установлен; доступный текст страницы
- Digital restoration of historical documents — тип публикации не установлен; доступный текст страницы
- Material uncertainty in computational workflow in the archives: Holocaust last writings beyond machine-readable extraction — рецензируемая публикация; полный текст PDF
Фото: Tahir Xəlfəquliyev / Pexels


Похожие статьи
 Защита работ
29
мин
04.11.2026
Как написать юридическую монографию: проблема, источники права и аргументация
Юридическую монографию удобно проектировать вокруг вопроса, на который автор сможет ответить с помощью определённого корпуса источников. Важно связать правовую проблему, применимые редакции документов, судебные материалы и собственное рассуждение. Разберём этот порядок на законченном учебном примере
 Защита работ
17
мин
29.03.2026
28869
Библиотеки и базы диссертаций
Библиотека диссертаций поможет соискателю ученой степени проверить актуальность и изученность предмета будущего исследования, ознакомиться со структурой составления текста документа и списком использованных литературных источников. Российская электронная библиотека диссертаций Вирт
 Защита работ
23
мин
05.11.2026
Монография Понасенкова о 1812 годе: разбор доступного фрагмента
Монография Евгения Николаевича Понасенкова «Первая научная история войны 1812 года» требует различать авторский тезис и его основание. Разберём официальный ознакомительный фрагмент Литрес с copyright 2020 года и один доступный довод автора о мебели для итальянской поездки Наполеона. Ниже показано, к
 Защита работ
5
мин
01.06.2023
10510
Как выбрать научного руководителя для диссертации?
Научный руководитель диссертации – это специалист с научным образованием и педагогическим опытом работы, оказывающий помощь в подготовке и написании кандидатской диссертации. Кандидатура куратора проекта должна соответствовать установленным требованиям ВАК и назначается на должность приказом р
 Защита работ
6
мин
15.02.2022
19244
Что такое академическая разница?
Академическая разница – это различие в формах аттестации, списке дисциплин, количестве часов, выделенных для изучения конкретных предметов по специальности студента при переводе из одного учебного учреждения в другое или восстановлении после отчисления. Не является задолженностью, но перенос
 Защита работ
12
мин
03.05.2026
0
Как спасти слабую работу на защите
Если ты уже знаешь, что твоя диссертация имеет массу недостатков, важно своевременно подготовиться к защите: создать ясную структуру доклада, сконцентрироваться на ключевых результатах, уверенно вести себя в процессе выступления. Дополнить образ поможет аккуратный внешний вид и спокойная манера пове
Последние новости и статьи
 Наука
2
мин
08.11.2026
Иридиевый катализатор активировал химиопрепарат рядом с опухолевыми клетками
Команда химика Томаса Уорда из Университета Базеля 3 ноября описала подход, который позволяет высвобождать противораковый препарат рядом с опухолевыми клетками. Иридиевый катализатор соединили с ингибитором белка hCA IX. Он работает как молекулярный адрес: помогает катализатору связываться с клеткам
 Наука
3
мин
08.11.2026
Модели связали Великий разрыв с подъёмом и погружением древних континентов
Сантос Дхунгана и Николас Фламан из Университета Вуллонгонга предложили объяснение Великого разрыва, одной из крупнейших лакун в геологической летописи Земли. Их исследование опубликовано 4 ноября 2026 года в журнале Nature.В некоторых районах осадочные породы кембрийского периода, возрастом около 5
 Студенческая жизнь
3
мин
08.11.2026
Во Франции 7 ноября на протестах задержали не менее 360 человек
Во Франции 7 ноября на протестах задержали не менее 360 человек, сообщило Министерство внутренних дел страны. По данным ведомства, в акциях участвовали 146 тыс. человек, включая 46 тыс. в Париже. Молодёжное межпрофсоюзное объединение оценило число участников демонстраций в 250 тыс., из них 75 тыс. в
 Диссертации по темам
23
мин
08.11.2026
Монографии по теории государства и права: маршрут чтения
Монографии по теории государства и права полезнее выбирать под исследовательский вопрос: что считать государством, как различать его типы, как соотносятся правовое устройство, социальная практика и цели публичной власти. Ниже — карта чтения по этим направлениям, сравнение конкретных прочитанных фраг
 Вопросы студентов
34
мин
08.11.2026
Монографии о праве собственности: как выбрать литературу для теории и защиты недвижимости
Монографии о праве собственности нужны для разных задач: объяснить содержание права, отделить его от владения, исследовать оборот вещей или сравнить способы защиты недвижимости. Перед подготовкой собственной научной рукописи полезно определить этот выбор: цена на монографию обсуждается применительно
 Помощь по написанию
32
мин
08.11.2026
Монография Евгении Червец о личных фондах: как читать аргумент об обособлении имущества
Монография Евгении Червец «Личные фонды на стыке права и экономики: механизмы управления частным капиталом» помогает поставить исследовательский вопрос: какую задачу решает обособление имущества и как соотносятся интересы собственника, управляющего и кредиторов. Если вы собираете материал для своей