


Содержание статьи
Вопросы студентов
26.10.2026
7
мин
Представьте: вы получили пять оценок от разных участников учебного теста. Баллы такие: 40, 10, 20, 20, 50. Задача — расставить эти значения по порядку от наименьшего к наибольшему и дать каждому участнику порядковый номер, то есть ранг. Если бы все баллы были разными, ранги просто совпали бы с номерами в отсортированном списке. Но два человека получили одинаковые 20 баллов. Как быть? Разрывать связку произвольно или назначить обоим один и тот же номер? И какой именно?
В SciPy rankdata по умолчанию используется средний ранг (метод average). Расчёт прозрачный и поддаётся проверке вручную. Разберём его по шагам на нашем примере, а потом посмотрим, чем отличаются другие соглашения.
Исходные данные
Пять наблюдений с произвольными идентификаторами:
| ID | Балл |
|---|---|
| U1 | 40 |
| U2 | 10 |
| U3 | 20 |
| U4 | 20 |
| U5 | 50 |
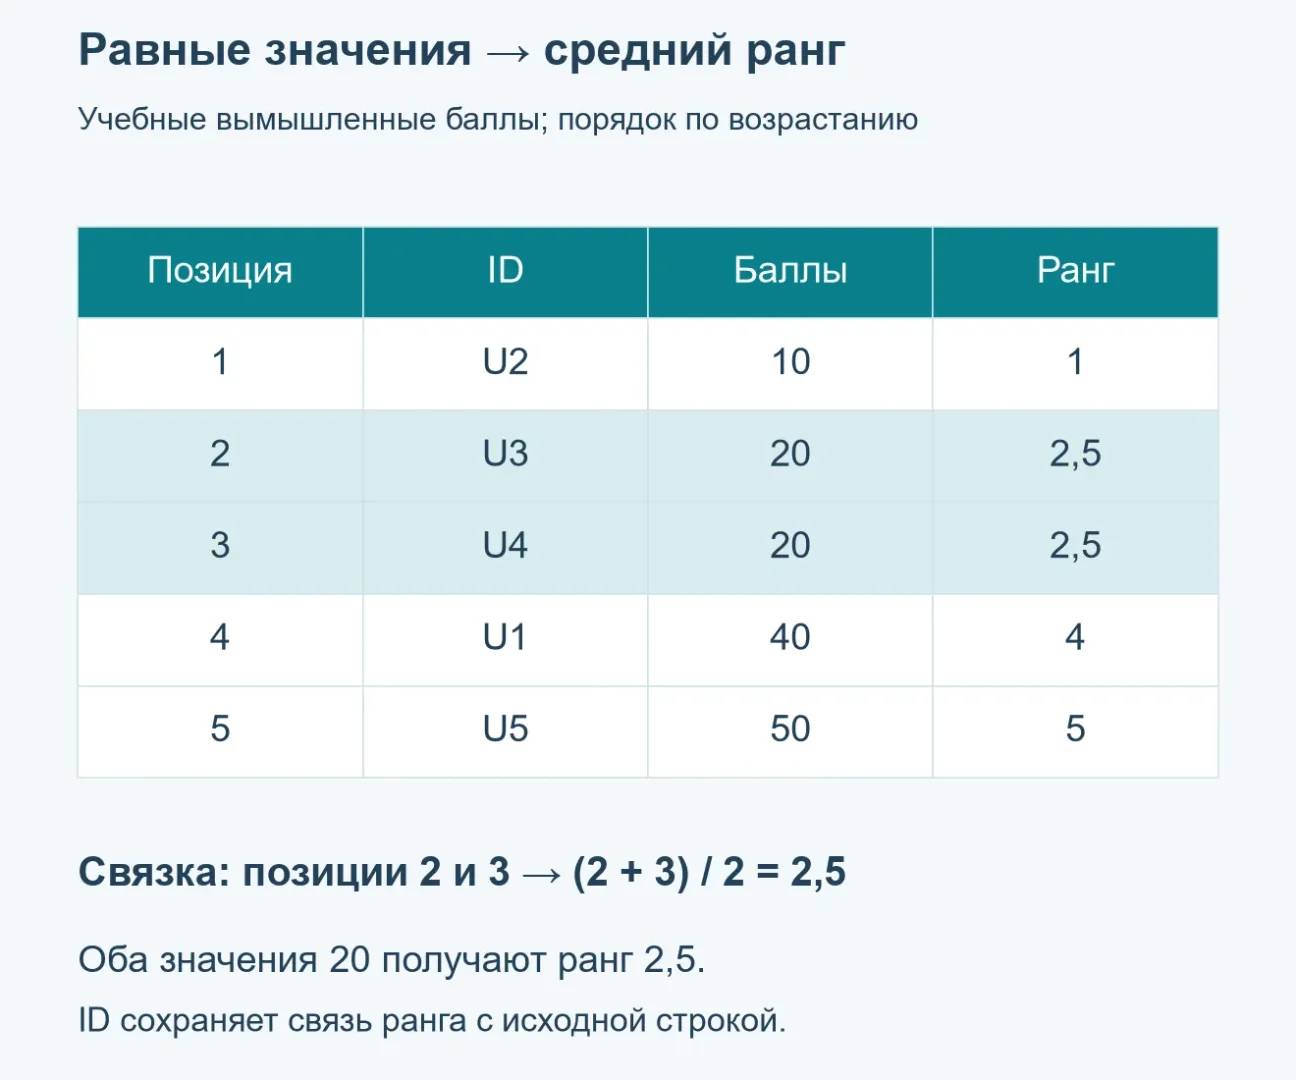
Данные вымышленные, никакого реального исследования за ними нет. Нам нужно только понять механику ранжирования.
Шаг 1. Сортировка
В этом примере выбрано возрастание: меньшему значению назначаем меньший ранг, начиная с 1. После сортировки получаем такой порядок:
- U2, балл 10
- U3, балл 20
- U4, балл 20
- U1, балл 40
- U5, балл 50
Двадцатки заняли вторую и третью позиции.
Шаг 2. Расчёт среднего ранга для связки
Поскольку оба балла равны, мы не можем решить, кто из них «второй», а кто «третий». Метод average предлагает компромисс: берём среднее арифметическое занятых позиций. (2 + 3) / 2 = 2,5. Этот ранг присваивается обоим участникам U3 и U4.
Шаг 3. Восстановление исходного порядка
Теперь записываем ранги напротив каждого ID в том порядке, в котором наблюдения были даны изначально:
| ID | Балл | Ранг (average) |
|---|---|---|
| U1 | 40 | 4 |
| U2 | 10 | 1 |
| U3 | 20 | 2,5 |
| U4 | 20 | 2,5 |
| U5 | 50 | 5 |
Проверим конкретный расчёт для average: 4 + 1 + 2,5 + 2,5 + 5 = 15. До усреднения связки сумма пяти позиций равна 1 + 2 + 3 + 4 + 5 = 15. Две позиции 2 и 3 заменены двумя рангами 2,5: 2 + 3 = 2,5 + 2,5 = 5. В этом наборе сумма сохранилась. Такая проверка арифметики сама по себе не проверяет качество измерения и не доказывает правильность каждого ранга.
Чего не делает ранг
В исходных данных U1 имеет 40 баллов, а его ранг по возрастанию равен 4. У U2 — 10 баллов и ранг 1. Разность исходных баллов равна 30, а разность рангов — 3: это разные величины. Ранг 4 не означает 40% правильных ответов. Различия между уровнями измерения рассмотрены в статье о шкалах измерения.
Другие способы обработки связок
Метод average — лишь одно из соглашений. Документация SciPy rankdata (v1.18.0) перечисляет пять методов; остановимся на трёх, которые упоминаются в этом источнике.
| Метод | Ранг для 20 (оба) | Ранг для 40 | Ранг для 50 | Особенность |
|---|---|---|---|---|
| average | 2,5 | 4 | 5 | Позиции 2 и 3 заменены средним рангом 2,5. |
| min | 2 | 4 | 5 | Каждому в связке — минимальный из их номеров. Пропуск 3. |
| dense | 2 | 3 | 4 | Как min, но следующий ранг не пропускается. |
В документации SciPy для min приведено также название competition ranking. В нашем наборе оба значения 20 получают ранг 2, а следующее значение 40 — ранг 4. При dense для того же набора ранг 40 равен 3. Это разные соглашения; выбранный способ нужно явно указать и применять последовательно.
А если ранжировать по убыванию?
Направление меняет, какое значение получает ранг 1. Если мы решим, что наибольший балл — лучший, и присвоим ему ранг 1, таблица для метода average будет выглядеть так:
| ID | Балл | Ранг (убывание, average) |
|---|---|---|
| U1 | 40 | 2 |
| U2 | 10 | 5 |
| U3 | 20 | 3,5 |
| U4 | 20 | 3,5 |
| U5 | 50 | 1 |
Сумма снова 15. Обратите внимание: для двадцаток занятые позиции — 3 и 4, их среднее 3,5. При смене направления изменились только ранги, баллы остались прежними.
Распространённые ошибки
При выбранном average нельзя назначить двум равным значениям 20 разные ранги 2 и 3: это уже другое правило. Сумма 4 + 1 + 2 + 3 + 5 всё равно равна 15, поэтому совпадения суммы недостаточно для проверки обработки связки. Проверьте и сами значения рангов. Метод ordinal в SciPy — отдельное соглашение, его не следует незаметно подменять методом average.
Описание параметра method и разных способов обработки связок доступно в официальной документации scipy.stats.rankdata. Расчёты в этой статье выполнены отдельно для пяти вымышленных наблюдений.
В исходном примере пропусков нет. Если значение отсутствует, не подставляйте вместо него ноль: это изменит сортировку. Отдельно зафиксируйте, какие наблюдения включены в ранжирование. При использовании SciPy способ обработки NaN задаётся параметром nan_policy; здесь такой расчёт не выполняется.
Ранг описывает место значения при выбранном направлении и правиле связок; он не является процентом правильных ответов.
Как проверить себя
- Убедитесь, что ранги начинаются с 1, а не с 0.
- Для каждого значения определите его позицию в отсортированном ряду.
- Для каждой связки найдите занятые ею позиции и вычислите среднее (если выбран метод average).
- Верните ранги в исходный порядок следования ID.
- Для нашего примера average сверьте сумму рангов 15 с суммой позиций 1 + 2 + 3 + 4 + 5 = 15. Не переносите эту проверку суммы на min или dense: в таблице у этих методов другие значения.
Пример можно воспроизвести вручную по исходной таблице. Для обсуждения подготовки собственных данных можно обратиться за консультацией по статистическому анализу. Заранее уточните задачу и объём консультации.
Что дальше
Для описания этого примера достаточно записать: «Пять вымышленных наблюдений ранжированы по возрастанию методом среднего ранга. Одинаковым баллам 20 присвоен ранг 2,5; соответствие рангов исходным ID сохранено». Применение статистических критериев в этом примере не рассматривается.
Источники
Фото: Andy Barbour / Pexels


Похожие статьи
 Вопросы студентов
7
мин
25.10.2026
Таблица сопряжённости: как считать проценты по строкам и столбцам
В одной ячейке таблицы сопряжённости стоит число 3, а рядом с ним могут быть три разных процента: 75%, 60% и 30%. Все они рассчитаны правильно. Меняется знаменатель, поэтому меняется и вопрос, на который отвечает процент. Разберём полностью вымышленный учебный пример. Есть 10 участников из двух груп
 Вопросы студентов
6
мин
26.10.2026
Как объединить проценты двух групп: учитываем численность и исходные ответы
Представьте, что у вас есть две учебные группы. В одной 20 человек, из них 10 ответили «Да» на опрос (50%). В другой — 100 человек, из них 30 ответили «Да» (30%). Вам нужно узнать, сколько процентов участников обеих групп вместе выбрали «Да». Просто сложить 50% и 30% и разделить на 2? Получится 40%,
 Вопросы студентов
7
мин
26.10.2026
Проценты и процентные пункты: как правильно описать изменение доли
Представьте учебный отчёт: в период А из 100 опрошенных вариант «Да» выбрали 20 человек, в период Б — 30 человек. Доля выросла с 20% до 30%. Чтобы описать этот результат точно, нужно различать два понятия: процентные пункты и относительное изменение.Например, доля выросла на 10 процентных пунктов (п
 Вопросы студентов
10
мин
25.10.2026
Шкалы измерения: номинальная, порядковая, интервальная и отношений
В таблице стоят числа 1, 2, 3, 4 и 5. Но что они означают: количество, порядок или всего лишь коды ответов? Чтобы понять, какие выводы можно сделать из данных, сначала нужно определить смысл значений переменной.Рассмотрим четыре уровня измерения на условном примере учебного проекта о просмотре запис
 Вопросы студентов
10
мин
25.10.2026
Матрица литературного обзора: шаблон, пример и переход к тексту
После чтения нескольких статей в заметках легко получить три пересказа, которые никак не разговаривают друг с другом. Матрица помогает разложить сведения по темам, увидеть, что источники действительно сопоставляют, и на этой основе написать связный абзац обзора. Различайте три инструмента. Список ли
 Вопросы студентов
8
мин
14.10.2026
Zotero для студента: как собрать источники и оформить ссылки в Word
В заметках к курсовой сохранилась точная цитата, но уже непонятно, из какого PDF она взята. Zotero помогает держать записи об источниках, прикреплённые файлы и заметки вместе, а затем вставлять ссылки и собирать библиографию в Word. Пройдём весь путь на условном примере курсовой о цифровых привычках
Последние новости и статьи
 Наука
3
мин
26.10.2026
Лабораторная плазма показала механизм нагрева солнечной короны, но загадку пока не решила
Как нагреть что-то до миллионов градусов, отходя от источника тепла? Именно этот парадокс десятилетиями мучает астрофизиков: внешняя атмосфера Солнца — корона — в тысячи раз горячее его видимой поверхности. Теперь группа из Китайского института атомной энергии под руководством Вэй Суня впервые воспр
 Наука
4
мин
26.10.2026
Переезд и пустой кошелёк после разрыва связали с неопределённостью сексуальной ориентации
Расставание выбивает из жизни не только человека, но и привычный быт: общую квартиру, совместный счёт, круг знакомых на выходные. Исследователи из Университета штата Канзас обнаружили, что именно эти материальные потери — переезд, потеря друзей, изменение доходов — оказались связаны с тем, что челов
 Наука
2
мин
26.10.2026
Молекулярные особенности ПФАС помогают проектировать сорбенты для очистки воды
Доцент Коуки Ока из Университета Тохоку вместе с коллегами собрал и проанализировал данные о том, как разные материалы захватывают из воды пер- и полифторалкильные вещества (ПФАС) — их часто называют «вечными химикатами». Исследователи предложили общие принципы, по которым можно конструировать сорбе
 Вопросы студентов
8
мин
26.10.2026
Широкий и длинный формат данных: как преобразовать таблицу и проверить результат
В учебной таблице три участника и два столбца оценок: «математика» и «история». Пять оценок известны, одна отсутствует. Для следующей операции нужна другая структура: название предмета в отдельном столбце, балл — в другом. Покажем переход из широкого формата в длинный и обратно на вымышленных данных
 Вопросы студентов
8
мин
26.10.2026
Множественный выбор в анкете: проценты от участников и от всех отметок
В вопросе с множественным выбором сумма процентов может оказаться больше 100%. Само превышение ещё не доказывает ошибку: сначала нужно проверить исходные отметки и знаменатель. Разберём авторский вымышленный пример, где 5 участников оставили 8 отметок и сумма долей участников равна 160%. Все данные
Вопросы студентов
7
мин
26.10.2026
Проценты и процентные пункты: как правильно описать изменение доли
Представьте учебный отчёт: в период А из 100 опрошенных вариант «Да» выбрали 20 человек, в период Б — 30 человек. Доля выросла с 20% до 30%. Чтобы описать этот результат точно, нужно различать два понятия: процентные пункты и относительное изменение.Например, доля выросла на 10 процентных пунктов (п