


Содержание статьи
Магистерские диссертации
05.11.2026
05.11.2026
11
мин
Представьте колоду карт, которую вы тасуете по случайному правилу. При каждом движении часть карт выцветает, потому что они касаются стола, воздуха и ваших пальцев. Через десять тасований рисунок на рубашке уже не тот, что был в начале. Вопрос не в том, испортились ли карты. Вопрос в другом: можно ли, глядя на итоговую стопку, отделить след от случайного порядка тасования и след от контакта со средой?
Примерно так Perimeter Institute описывает задачу, которую решали Мэттью Душенес и его соавторы в статье, получившей отметку Editors' Suggestion журнала Physical Review A. Работа опубликована 17 августа 2026 года. Полный текст доступен на arXiv, а на странице издателя есть аннотация и библиографические данные. Это не экспериментальный запуск квантового компьютера, а вычислительное исследование распределений результатов измерений в симулированных случайных квантовых схемах.
В квантовой механике результат измерения почти никогда не бывает предопределён. Даже у полностью известного состояния есть лишь вероятность получить тот или иной исход. Поверх этой внутренней случайности в реальных устройствах лежит ещё два слоя. Первый — навязанная случайность: исследователь сознательно выбирает случайные операции, чтобы описать сложный процесс через множество возможных схем. Второй — шум: кубиты взаимодействуют с окружением, и часть информации теряется. Работа Душенеса, Мелко, Карраскильи и Лафламма посвящена тому, как эти два слоя вместе меняют распределение ожидаемых значений измерительных операторов.
Почему смотрят на распределение, а не только на среднее
Ожидаемое значение измерительного оператора можно понимать как вероятность исхода измерения. Если состояние выбрано случайно, то и эта вероятность становится случайной величиной. Обычно исследователя интересует среднее или отдельный результат. Но среднее скрывает форму распределения: где находятся пики, насколько тяжелы хвосты, сколько мод появляется при изменении схемы.
Авторы формулируют это как два вопроса. Первый: как размер системы, глубина схемы и масштаб шума влияют на распределения ожидаемых значений для наборов общих измерительных операторов? Второй: если для глобально зашумлённых случайных систем известны аналитические распределения, существуют ли эффективные модели, которые воспроизводят поведение локально зашумлённых систем?
Для ответа они обобщают прежние выводы для чистых состояний на случай смешанных состояний с окружением переменной размерности. Смешанное состояние возникает, когда система запутана с окружением, которое нельзя полностью контролировать, и часть информации утрачена. Это реалистичнее чистого состояния, потому что любой реальный квантовый процессор частично открыт.
Что именно делали
Метод сочетает аналитику и численное моделирование. Сначала авторы вывели выражения для моментов распределений ожидаемых значений, используя комбинаторные подходы. Затем построили эмпирические распределения для случайных кирпичных схем, которые подчиняются мере Хаара, с локальным деполяризующим шумом.
Кирпичная схема названа так потому, что квантовые операции расположены слоями, как кирпичи в кладке. Между слоями унитарных операций вставлен шум. Это напоминает несовершенства современных процессоров, где ошибки накапливаются после каждой операции.
В симуляциях меняли глубину схемы k в наборе 0, 2, 4, 8, 16, 32, масштаб шума γ от 0 до 10⁻¹, число кубитов n от 4 до 10. Использовали до 128 исходных образцов. Полученные вероятности логарифмически разбивали на интервалы. Различие между эмпирической и модельной функциями распределения оценивали метрикой Колмогорова — Смирнова, то есть максимальным расхождением двух кумулятивных функций.
Эффективная модель предполагала глобальный деполяризующий шум с переменными эффективными параметрами: масштабом шума и размерностью окружения. Эти параметры подбирали по эмпирическим данным.
Пики модель ловит, хвосты упускает
Главный результат можно сформулировать коротко: модель хорошо воспроизводит пики распределений, но хуже описывает хвосты. В аннотации журнала сказано буквально: «Подогнанные эффективные распределения воспроизводят поведение пиков при разных глубинах схемы, масштабах шума и размерах системы, тогда как отклонения в хвостах возникают из-за локальных шумовых эффектов».
Это расхождение имеет два источника. Первый — ограниченное число образцов в хвостах. Второй — само устройство эффективной модели. Она заменяет локальный шум глобальным, а это приближение не может передать детали, которые возникают из-за ошибок в конкретных местах схемы. Авторы прямо пишут, что точная выборочная сложность и точность модели могут быть скрыты низким числом образцов: «Независимо от биннинга, для получения информации о хвостах распределения в логарифмическом масштабе с ростом размера системы может потребоваться экспоненциально большее число образцов».
Поэтому если кто-то увидит в такой гистограмме расхождение с простой моделью, это ещё не значит, что найдено что-то новое. Возможно, просто не хватило данных, чтобы заполнить редкие события.
Симметрия операторов меняет число пиков
Более выразительный признак появился, когда авторы сравнили разные наборы измерительных операторов. Для симметричных наборов, где все операторы имеют одинаковый спектр, распределения оказались одномодальными. Для несимметричных наборов, где спектры операторов различаются, возникли отчётливые многомодальные распределения.
Механизм объяснён в полном тексте: «В отличие от симметричного случая, где каждый из одинаковых вносящих вклад условных распределений имеет единственный общий пик, в несимметричном случае многие различные вносящие вклад условные распределения имеют различные пики. Любые различия спектров операторов в наборе напрямую дают вклад в мультимодальность распределений».
Проще говоря, итоговая гистограмма — это сумма нескольких условных распределений. Если все слагаемые имеют пик в одном месте, сумма одномодальна. Если пики слагаемых разнесены, сумма даёт несколько горбов. Число таких пиков может расти с размером системы.
Это статистический признак, который можно искать в данных: сколько пиков у распределения, где они расположены и как меняются при увеличении глубины схемы или масштаба шума. В работе также показано, что эффективные параметры модели меняются плавно и согласованно с глубиной схемы и масштабом шума. Такая плавность говорит о том, что подгонка находится в физически осмысленном локальном минимуме, хотя авторы не доказывают, что это глобальный оптимум.
Чего эти признаки не доказывают
Здесь нужна осторожность. Статья не показывает, что квантовое устройство превосходит классический компьютер. В собранных материалах нет сравнительного теста, где квантовое устройство и классический алгоритм решают одну задачу при сопоставимых ресурсах. Работа выполнена на симуляциях, а не на реальном процессоре.
Более того, авторы оставляют открытым вопрос о симулируемости многомодальных распределений. В обсуждении они пишут: «Будет важно оценить вычислительную и выборочную сложности наших многомодальных распределений. Для каких наборов операторов и распределений квантовых состояний сохраняется любое заявленное преимущество квантовых методов перед классическими?»
Это значит: многомодальность сама по себе не является доказательством квантового преимущества. Возможно, классический алгоритм тоже способен воспроизвести такое распределение, если знать свойства операторов. Или наоборот, потребуется экспоненциально много ресурсов. Ответа в статье нет.
Ограничения стоит перечислить отдельно. Исследованы только случайные кирпичные схемы с локальным деполяризующим шумом. Выводы не следует автоматически переносить на другие архитектуры, алгоритмы и модели шума. Авторы отмечают, что не изотропные модели шума могут не обладать сдвиговой и масштабной инвариантностью, на которой построена эффективная модель. Аналитические вычисления для некоторых несимметричных наборов операторов становятся численно неосуществимыми уже при умеренном размере системы. Метрика Колмогорова — Смирнова и её верхняя оценка могут завышать ошибки около резких пиков.
Ещё одно ограничение связано с конечным числом образцов. Авторы использовали до 128 исходных образцов. Этого достаточно для пиков, но хвосты в логарифмическом масштабе требуют гораздо большего числа повторений. Любая диагностика, основанная на редких событиях, будет шумной при таком объёме данных.
Что это значит для читателя
Для практической задачи «действительно ли эта квантовая система делает что-то особенное» работа даёт скорее набор предостережений, чем готовый тест. Полезно смотреть не только на среднее значение измерений, но и на всю гистограмму: число пиков, их положение, хвосты. Однако расхождение с простой моделью глобального шума может быть артефактом локальных ошибок или недостатка образцов. А многомодальность может быть следствием несимметричности измерительных операторов, а не признаком вычислительной силы.
Статья ценна другим. Она показывает, как аналитические выражения для случайных смешанных состояний можно сравнивать с реалистичными симуляциями, и где такая простая модель перестаёт работать. Это шаг к более честной диагностике шумных квантовых устройств, но именно шаг, а не финальный критерий.
Тем, кто хочет понять, какие задачи квантовый компьютер действительно сможет решать, полезно прочитать наш разбор про миллион кубитов и границы практической полезности квантовых вычислений. А если интересует, как метафоры помогают и мешают объяснять квантовую физику, стоит заглянуть в статью о языке квантовых аналогий.
Источники
Duschenes M., Melko R. G., Carrasquilla J., Laflamme R. Distributions of noisy expectation values over sets of measurement operators // Physical Review A. 2026. Vol. 114, iss. 2. Art. 022434. DOI: 10.1103/qp99-qqgy.
Полный текст препринта: arXiv:2604.05973.
Новостной материал Perimeter Institute: Finding the fingerprints of noisy distributions in random quantum systems, Phys.org, 3 ноября 2026 года.
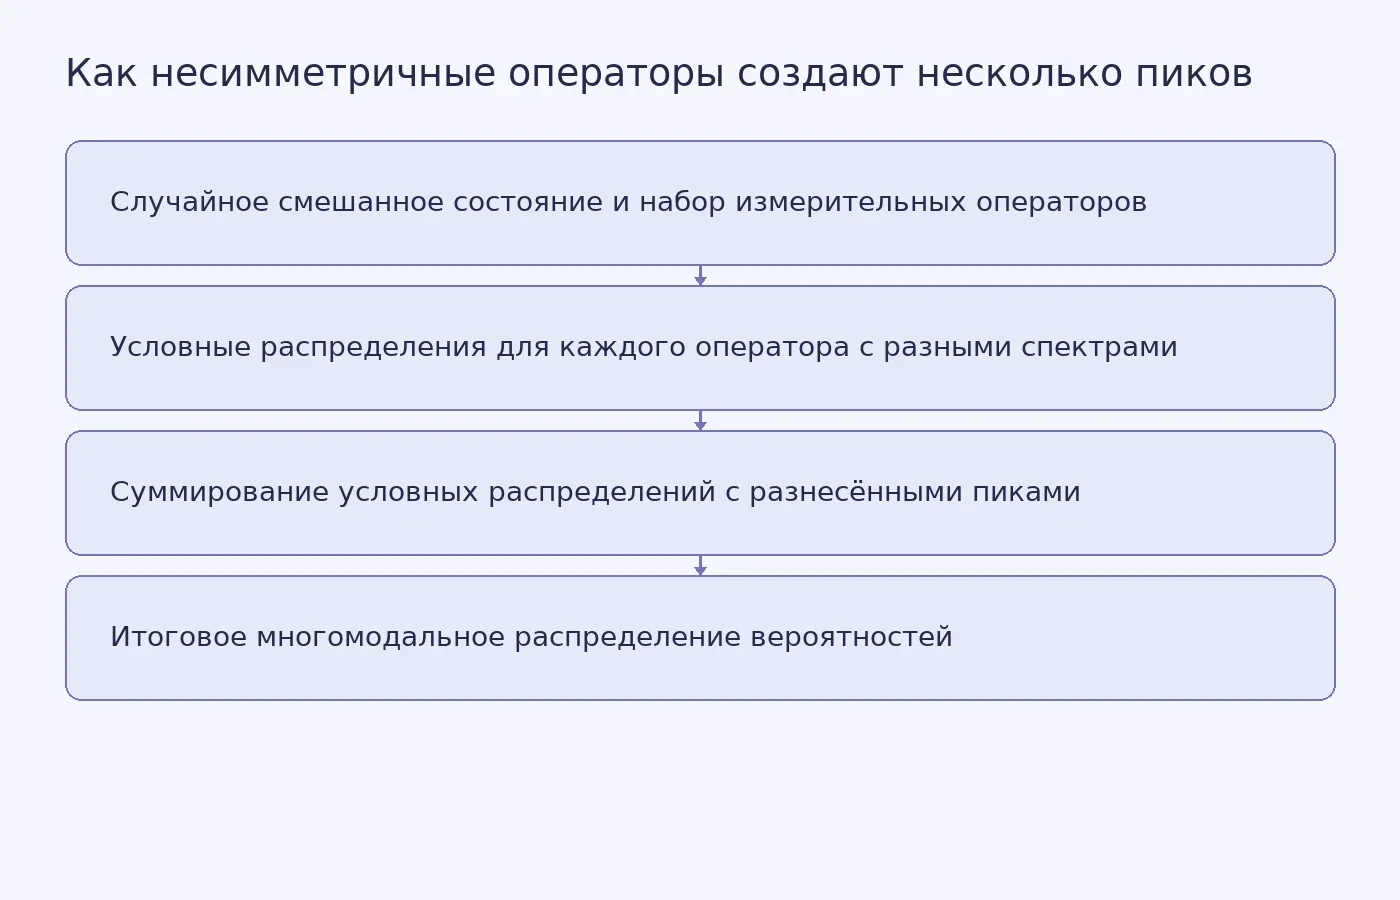
Фото: Nop Viwat / Pexels


Похожие статьи
 Магистерские диссертации
7
мин
03.11.2026
23 сигнала на тысячу: что на самом деле показал ИИ для приёмных отделений
На тысячу обращений в приёмное отделение алгоритм отметил 121 как требующее дополнительной оценки. В 23 случаях в больничных записях появлялся код, связанный с суицидальным поведением, в течение следующих 30 дней. Ещё у 98 отмеченных обращений такого кода не было. Эти числа описывают ретроспективную
 Магистерские диссертации
7
мин
03.11.2026
Гигантская глубоководная губка размером с минивэн всё ещё остаётся загадкой
В августе 2015 года дистанционно управляемый аппарат Deep Discoverer шёл над подводным хребтом к северу от поднятия Банк 9, в границах морского национального памятника Папаханаумокуакеа. На глубине 2117 метров прожекторы выхватили из темноты нечто настолько большое, что осознать его как единый орган
 Магистерские диссертации
5
мин
05.11.2026
Мотто, мантра, муза: как слова могут поддержать в трудное время
У потока, встретившего камни, появляется звук: вода огибает препятствия и журчит. С этого образа Уэнделла Берри начинается эссе психолога и автора блога Psychology Today Кита Стораса о том, как оставаться вовлечённым в трудные времена. Но сам образ поющего потока не доказывает, что короткая фраза по
 Магистерские диссертации
31
мин
20.07.2023
10159
Актуальный перечень тем магистерских диссертаций 2023 года
Предлагаем вашему вниманию перечень актуальных тем магистерских диссертаций 2023 года по популярным специальностям. Это поможет определиться с темой будущего исследования и актуальностью рассматриваемой проблемы. Темы магистерских диссертаций по праву Основные тенденции современной уголовн
 Магистерские диссертации
7
мин
13.06.2023
10266
Методы исследования в магистерской диссертации: какие бывают и как их писать
Методы исследования в магистерской диссертации — это совокупность инструментов, использующихся для сбора и анализа данных в рамках исследования. Они помогают получить общее представление о рассматриваемой проблеме, проверить истинность научной гипотезы, разработать экспериментальную базу, необ
 Магистерские диссертации
4
мин
14.10.2026
Отменят ли магистратуру в России: что известно на 14 октября 2026 года
Короткий ответ: доступные документы не подтверждают общероссийскую отмену магистратуры. В представленном тексте статьи 10 Федерального закона № 273-ФЗ она перечислена среди уровней профессионального образования. Минобрнауки сообщает о пилотном проекте и проектируемой модели, но эти сообщения сами по
Последние новости и статьи
 Вопросы студентов
33
мин
05.11.2026
10571
Лучшие приложения для студентов-медиков
10 инструментов для первого сравненияВыбирайте строку по учебной задаче. Возможности в этой таблице взяты из описаний разработчиков и карточек магазинов; это не испытание всех мобильных приложений на устройствах. Подробности и критерии проверки приведены в разделах ниже. В первом сравнении — десять
 Научные статьи
6
мин
05.11.2026
Как связка NEMO и Hydra может помочь найти оборудование в другой лаборатории
Представим: исследователю понадобился редкий микроскоп или установка для обработки образца. Он знает, что такая возможность где-то есть, но не знает, в какой лаборатории. Сегодня поиск нередко начинается с сайтов, таблиц и писем коллегам. Каждая лаборатория описывает оборудование по-своему, а сведен
Магистерские диссертации
5
мин
05.11.2026
Мотто, мантра, муза: как слова могут поддержать в трудное время
У потока, встретившего камни, появляется звук: вода огибает препятствия и журчит. С этого образа Уэнделла Берри начинается эссе психолога и автора блога Psychology Today Кита Стораса о том, как оставаться вовлечённым в трудные времена. Но сам образ поющего потока не доказывает, что короткая фраза по
 Наука
4
мин
04.11.2026
Метаболиты в крови связали ультрапереработанную пищу с риском болезней сердца и диабета
Исследователи из Университетского колледжа Лондона и Имперского колледжа Лондона обнаружили в крови два набора метаболитов, связанных с разными типами питания. В исследовании 6010 британских госслужащих эти метаболические «следы» статистически объяснили от 42,8% до 51,1% связи между употреблением ул
 Наука
3
мин
04.11.2026
Четырёхмерное нейтронное рассеяние показало, как ионы взаимодействуют в твёрдом материале
Исследователи Аргоннской национальной лаборатории и их коллеги проследили, как ионы хлора согласованно перемещаются в кристалле хлорида стронция SrCl₂. Статья с результатами вышла 14 апреля 2026 года в журнале PRX Energy; пресс-релиз лаборатории опубликовали 4 ноября. Четырёхмерный метод квазииупруг
 Наука
3
мин
04.11.2026
Как 11 летучих мышей разделяли эхолокационные сигналы без «дирижёра»
Летучие мыши могут сами разводить по частоте эхолокационные крики, чтобы сигналы меньше мешали друг другу. К такому выводу пришли исследователи из Университета Тоямы, Университета Досися, Университета Нагои и Университета Мэйдзи в Японии. В опытах с 11 восточными длиннокрылыми летучими мышами (Minio