
Содержание статьи
Полезные материалы
05.10.2026
05.10.2026
11
мин
Двое говорят одновременно — и старая схема разметки голосов ломается. Не потому, что она плохо написана, а потому, что устроена иначе: она режет запись на куски, снимает с каждого отпечаток голоса и складывает похожие отпечатки в кучки. Если в куске звучат два человека, отпечаток получается смешанным, и один из голосов исчезает. Именно на этом месте инженерный разбор Charoiteai фиксирует разницу между прежним конвейером на sherpa-onnx и моделью Nemotron 3 Diarization, которую NVIDIA выложила 23 сентября 2026 года.
Речь идёт не о рецензированной научной публикации, а об инженерной документации и авторском кейсе: репозиторий Charoite_audio, файл docs/DIARIZATION.md с результатами от 28 сентября 2026 года и две статьи на Хабре — часть 8 и часть 9. Автор один и тот же, он же владелец продукта, поэтому цифры здесь — это измерения на своём материале, а не независимая проверка. Читать их стоит именно так.
Что вообще решает диаризация
Задача звучит просто: для каждого момента записи указать, кто говорит. Классический путь, который в третьей части цикла описан как связка sherpa-onnx, состоит из двух моделей. Сегментация pyannote 3.0 находит, где вообще есть речь и где её границы. Затем эмбеддер ERes2Net выдаёт на каждый кусок речи вектор из 512 чисел — отпечаток голоса. Дальше кластеризация: близкие векторы считаются одним человеком.
Слабое место проявляется не в тишине, а в перекрытии. Когда двое говорят разом, кусок содержит смесь двух голосов, и его отпечаток не похож ни на одного из говорящих. Кластеризация либо теряет одного участника, либо склеивает нескольких в одну метку. В документе это сформулировано прямо: «Старая связка решает по отпечатку куска речи. Двое говорят разом — отпечаток общий, кто-то пропадает».
Другой принцип: восемь слотов вместо кучек
Nemotron 3 Diarization устроена как потоковый Sortformer примерно на 100 млн параметров. Вместо того чтобы собирать отпечатки и потом группировать их, модель на каждом кадре длиной 10 мс выдаёт отдельную вероятность активности для каждого из восьми голосовых слотов. Одновременная речь двух людей для неё не конфликт, а обычный ответ: активны оба слота. В документе это описано так: «для каждого 10-мс кадра она даёт каждому голосу свою вероятность активности, поэтому два голоса в одном кадре — нормальный ответ».
Отсюда следует важное: модель не «узнаёт» человека по накопленному отпечатку, а решает задачу присутствия голоса в кадре. Это меняет и характер ошибок. Кластеризация ошибается в основном путаницей говорящих, а Sortformer — пропусками коротких слов между паузами, потому что строгий эталон считает и их.
Что показали измерения
Основные числа получены на двух встречах из открытого набора AMI: четыре говорящих, английский, эталон из pyannote AMI-diarization-setup, только слова, без допуска по краям. Эталон строгий, поэтому абсолютные значения DER выше опубликованных — сравнивать между собой имеет смысл только движки, а не эти цифры с чужими таблицами.
На встрече ES2004a (17,5 минуты) производственный проход после встречи дал DER 0,606 при путанице 0,393 и трёх найденных голосах вместо четырёх. Nemotron на том же файле — 0,269 при путанице 0,004 и четырёх голосах. На встрече IS1009a (14 минут) разрыв меньше: 0,453 против 0,277. По скорости разница на порядки: RTF 0,35–0,36 у производственного прохода против 0,003 у Nemotron. Потоковый режим с задержкой 1,04 секунды дал те же 0,273 на обеих встречах при RTF 0,04.
Здесь важно не перепутать две вещи. Полный проход по файлу быстр не только из-за архитектуры, но и из-за режима вычисления: модель обрабатывает запись одним проходом, без последующей кластеризации. Потоковый режим устроен дороже — на каждом шаге он заново кодирует кэш голоса и очередь кадров до примерно 530 штук. В документе это сказано без обиняков: «Каждый шаг потока заново кодирует кэш голоса и FIFO (до ~530 кадров) для короткого нового фрагмента, поэтому секунда звука стоит намного дороже, чем при проходе по всему файлу». То есть утверждение «модель проходит запись один раз» относится к сравнению с кластеризацией и к полному проходу, а не к буквальной стоимости каждого потокового шага.
Синтетика, которая обманывает
Самое интересное в разборе — не победа на AMI, а провал на искусственных данных. На фикстуре с перекрытиями, где четыре реплики начинаются за 0,8–1,5 секунды до конца предыдущей, Nemotron почти идеальна: DER 0,039, все четыре голоса найдены, все 4,5 секунды одновременной речи на месте. На обычной фикстуре без перекрытий, где те же четыре голоса синтезатора macOS говорят по очереди, модель складывает всех в один слот: DER 0,628, а вероятность слота 0 держится около 0,9 на каждой реплике.
Автор проверил, не в длине ли дело: обрезал запись до 27 секунд и добавил 6 секунд тишины — результат тот же. Объяснение в документе такое: модель открывает нового говорящего, когда голоса пересекаются, а синтетические голоса, говорящие по очереди, выглядят для неё одним человеком. Отсюда прямой вывод, который стоит запомнить: «Судите её по реальным записям, а не по синтетике». Синтетический DER здесь — нижняя граница, а не оценка качества на совещаниях.
Русский язык и потолок в восемь голосов
Русского среди языков обучения нет: в карточке модели английский, китайский и четыре индийских языка. Диаризация зависит от языка меньше, чем распознавание речи, но это именно то, что нужно измерять, а не предполагать. В документе русская проверка названа «sanity check»: на канале собеседников двух рабочих звонков по ~20 минут производственный проход, Nemotron и его поток нашли 4 / 4 / 4 голоса в одном и 9 / 8 / 8 в другом, тогда как заметки о встрече называют 3–4 и 7–8 участников. Это не DER: независимого покадрового эталона на русских записях нет. В девятой части автор говорит об этом прямо: «Цифры ошибок на русском у меня нет. Размеченных людьми русских записей нет тоже».
Второе ограничение — жёсткий потолок. Модель различает не больше восьми голосов, и на восьми встречах из 57 она в него упёрлась. При большем числе участников несколько человек получают один слот. Это не дефект реализации, а свойство весов: в документе сказано, что веса с другим числом слотов движок отвергает.
Что это значит на практике
Для продукта Charoite вывод сформулирован как решение, а не как рекорд: на реальных встречах Nemotron обходит текущий проход после встречи с большим отрывом и за сотую долю времени, поэтому проход можно перевести на неё. В интеграции это сделано с видимым откатом: если интерпретатора нет, веса не скачаны, движок упал или не уложился в таймаут, встречу размечает sherpa, а в шапке стенограммы появляется строка о запасном движке и причине. Отдельно оговорено, что веса лежат под лицензией NVIDIA OpenMDW 1.1, а не Apache-2.0, и в репозиторий не попадают.
Есть и менее очевидный урок, который выходит за пределы этой модели. Когда движок меняется, страдают не только те, кто его вызывает напрямую. Nemotron режет реплику паузами на куски, и правило фильтра эха, рассчитанное на длинные отрезки sherpa, перестало работать: эхо поверх трёх кусков по 30% проходило как живая речь в микрофоне. На восьмиминутном звонке доля оставшейся микрофонной речи выросла с 17,5% до 69%, и только подсчёт доли по объединению всех отрезков вернул её к 17,8%. Формулировка автора: «Меняешь поставщика данных — прогони на его выходе всех, кто эти данные ест».
Остаётся открытый вопрос, который автор честно оставляет незакрытым. Русские записи не имеют независимого эталона, очные встречи в один микрофон измерены слабо, а порог, ниже которого голос считается осколком, подобран всего на пяти записях. Пока это означает, что переносить выводы на другой материал — на русскую речь, на другое железо, на другую версию библиотеки — нужно с собственной проверкой. Если вам интересно, как вообще отделять измеренный результат от интерпретации в чужой работе, об этом есть отдельный разбор — критический анализ научной статьи.
Источники и литература
- Локальный ассистент для зумов, часть 9: Nemotron от NVIDIA — почему взял и что получил / Хабр — авторское мнение; доступный текст страницы
- Локальный ассистент для зумов, часть 8: модель, ради которой я поменял диаризацию за один вечер / Хабр — авторское мнение; доступный текст страницы
- GitHub - charoiteai/Charoite_audio: Fully local AI meeting assistant: speaker diarization + self-updating knowledge graph. Nothing leaves your Mac. · GitHub — тип публикации не установлен; доступный текст страницы
- Charoite devlog | Notes from building a fully local meeting assistant for macOS: speaker diarization, on-device models, a knowledge graph that survives crashes. — тип публикации не установлен; доступный текст страницы
- Локальный ассистент для зумов, часть 3: кто это говорит — и почему я трижды ошибся, отвечая на этот вопрос / Хабр — тип публикации не установлен; доступный текст страницы
- Charoite_audio/docs/DIARIZATION.md at main · charoiteai/Charoite_audio · GitHub — первичный документ; доступный текст страницы
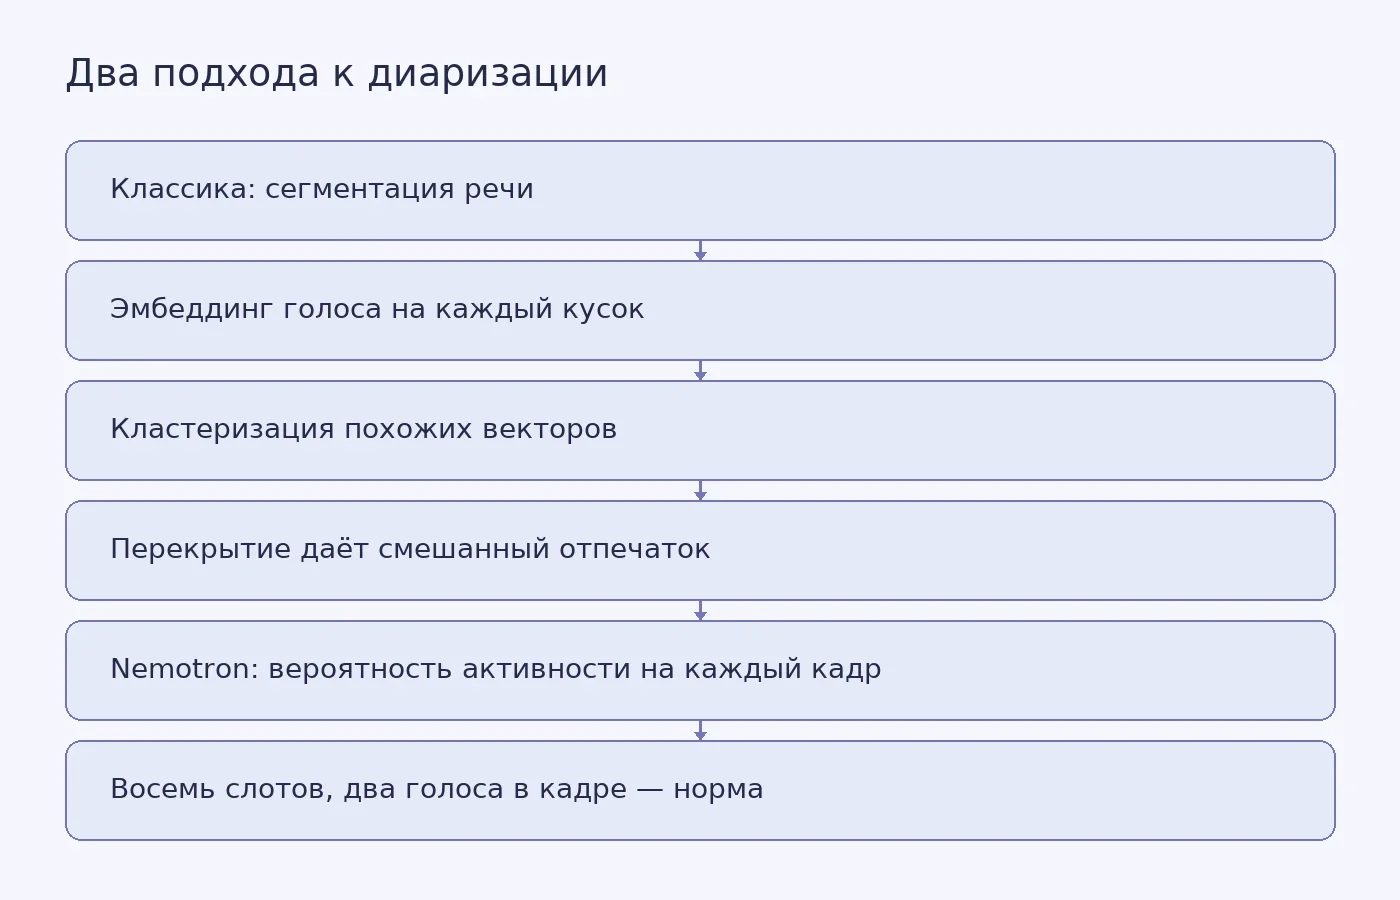
Фото: Edmond Dantès / Pexels


Похожие статьи
 Полезные материалы
10
мин
02.10.2026
Как на самом деле работала Enigma M3: детали, которые теряются в упрощённых моделях
Разбирая, как устроена Enigma M3, легко попасть в ловушку: почти любое учебное описание рисует машину, которой не было. Обычно это три ротора, фиксированный рефлектор, «одометр» вместо реального шага и коммутационная панель как необязательная вишенка. Между тем именно расхождения в этих деталях опре
 Полезные материалы
10
мин
04.10.2026
Почему гуманоид Figure перенёс бытовые навыки в 30 незнакомых домов
Представьте, что вы заходите в чужую квартиру и вас просят застелить постель. Вы не знаете высоту кровати, не видели это одеяло и не помните, где лежат подушки. Скорее всего, вы справитесь: подойдёте, поправите, подоткнёте. Именно эту человеческую способность — переносить знакомое действие в незнако
 Полезные материалы
25
мин
21.04.2023
20553
Порядок защиты кандидатской диссертации: предзащита, документы, этапы защиты
Чтобы успешно защитить кандидатскую диссертацию, соискателю ученой степени следует написать и грамотно оформить кандидатскую работу в соответствии с темой исследования, составить презентацию и речь на защиту, а также подготовиться к вопросам участников комиссии. Требования к защите кандидатской
 Полезные материалы
13
мин
03.10.2026
Когда узкий список инструментов помогает ИИ-агенту выбирать точнее
Пользователь просит ИИ-агента определить, какие устройства сейчас находятся в корпоративной сети. Роутер не находит подходящего раздела и не передаёт модели ни одного инструмента. Агент не сообщает об ограничении, а пишет: «Выполняю сканирование сети…» Затем он описывает работу, которой в действител
 Полезные материалы
12
мин
02.10.2026
Как ферменты разрушают PET и что показал опыт с пластиковой плёнкой
Новость о бактериях, которые «научили» разрушать пластик, обычно звучит так: в сточные воды подсадили ген фермента, и плёнка исчезла на 40% за четыре дня. В реальности ген переносили в бактерии из пробы сточных вод в лаборатории, а около 40% потери массы получили для очищенного фермента на коммерчес
 Полезные материалы
16
мин
04.10.2026
Как выбрать сигнал для вызова дежурного, а не просто настроить пороги
Диск заполнен на 51%, и мониторинг будит дежурного. Но свободного места хватит еще на месяц. В другом сервисе мониторинг собирает тысячи инфраструктурных метрик, но не замечает, что пользователи перестали оплачивать заказы.С этого несовпадения технического состояния и пользовательского результата на
Последние новости и статьи
 Наука
2
мин
06.10.2026
Озеро Лак-де-Брене теряет воду из-за жары, засухи и подземных трещин
Озеро Лак-де-Брене на границе Франции и Швейцарии почти высохло после жаркого лета. 1 октября 2026 года его уровень опустился до 735,34 метра над уровнем моря, на 14,66 метра ниже обычного. По данным AFP, вода убывала примерно на 20–22 сантиметра в сутки; рекорд падения, установленный в 1906 году, т
 Наука
3
мин
06.10.2026
Совместный приём пищи связали с более мягким подъёмом сахара в крови
Учёные из Еврейского университета в Иерусалиме и медицинского центра «Шиба» сравнили, как организм перерабатывает одну и ту же углеводную еду в одиночестве и рядом с близким человеком. Работа вышла в Science Advances 23 сентября 2026 года (DOI 10.1126/sciadv.aeg4937). В глюкозном эксперименте 108 уч
 Законодательство
3
мин
06.10.2026
ТулГУ: кто может взять «Ипотеку для семейного счастья»
29 сентября 2026 года ТулГУ опубликовал пресс-релиз о рабочей встрече, на которой учёным, аспирантам и сотрудникам вуза рассказали о двух вещах: конкурсе грантов правительства Тульской области в сфере науки и техники и новой региональной программе льготного ипотечного кредитования для молодых учёных
 Вопросы студентов
9
мин
06.10.2026
Исторические темы итогового сочинения 2026/2027: как готовиться
В образце комплекта ФИПИ на 2026/27 учебный год есть тема: «Память о Великой Отечественной войне – ответственность перед прошлым и будущим». Это пример, а не подсказка о том, что именно попадётся на экзамене. Закрытый банк целиком не опубликован, поэтому готовиться лучше не к одной предполагаемой фо
 Вопросы студентов
8
мин
06.10.2026
Пример итогового сочинения: полный текст и разбор по критериям
В образце комплекта тем итогового сочинения на 2026/27 учебный год есть вопрос: «Кого, по Вашему мнению, можно считать счастливым человеком?» Попробуем ответить на него и проследить, как литературный пример помогает раскрыть тезис. Текст ниже составлен для разбора, это не официальный образец ФИПИ и
 Вопросы студентов
8
мин
06.10.2026
Аргументы для итогового сочинения 2026/2027: как подобрать и связать с тезисом
В теме «Память о Великой Отечественной войне – ответственность перед прошлым и будущим» слово «память» легко приводит к пересказу знакомого произведения. Но одного пересказа недостаточно. Нужно показать, какой эпизод подтверждает вашу мысль и почему он связан именно с ответственностью перед прошлым