


Содержание статьи
Наука
06.11.2026
06.11.2026
4
мин
Исследователи из Carnegie Mellon University и Cisco Foundation AI проверили 13 ИИ-моделей в 325 000 экспериментах. В восьми случаях модели чаще выбирали для обеспеченных пользователей более дорогие варианты, даже когда запросы оставались одинаковыми. Препринт с результатами вышел на arXiv 25 сентября 2026 года.
Учёные создали 32 синтетических профиля и для каждой из трёх областей, перелётов, медицинской страховки и программ аспирантуры, подготовили фиксированный каталог из 200 вариантов. Цены и доступные предложения не менялись. Поэтому разницу в рекомендациях создавало поведение агента, а не продавец.
Когда профиль пользователя спорит с его запросом
В одном из тестов модель Gemini 2.5 Flash должна была найти самый дешёвый перелёт. Средняя цена рекомендации для обеспеченных синтетических пользователей составила 336 долларов, а для пользователей с низким доходом, 128 долларов. Разрыв достиг 208 долларов.
Авторы показали и конкретную иллюстрацию этого механизма. В запросе требовался самый доступный билет до Чикаго. Агент без сведений о пользователе нашёл билет экономкласса за 91 доллар. Получив доступ к письмам о финансах, он решил, что пользователь готов заплатить больше, и предложил билет бизнес-класса за 601 доллар, хотя дешёвый вариант оставался в каталоге. Это пример из экспериментальной системы, а не рассказ о реальной покупке.
Иными словами, личный контекст стал для модели сигналом о предполагаемой готовности платить. Запрос «найди самый дешёвый вариант» оказался недостаточно сильным, чтобы во всех случаях отменить такой вывод.
Авторы назвали явление «конфликтом при делегировании»: данные, которые должны помогать агенту персонализировать совет, иногда уводят его от прямо заданной цели пользователя. Это не означает, что дорогая рекомендация всегда бесполезна. Если человек не просил искать минимальную цену, более дорогой вариант может иметь дополнительные характеристики, которые ему подходят. Но при явном запросе на самый дешёвый вариант цена становится частью цели, а не второстепенной деталью.
Модель могла определить достаток и по косвенным признакам. В отдельных условиях агент восстанавливал сведения о финансовом положении из электронной почты, даже если прямого финансового показателя ему не давали. Блокировка финансовых данных в основном убирала разрыв. Ограничение доступа к другим признакам помогало не всегда, поскольку оставшийся контекст мог содержать похожие сигналы.
Исследование остаётся препринтом, а не рецензированной журнальной статьёй. В нём не участвовали реальные люди: авторы использовали синтетические профили и искусственные каталоги. Эксперименты проводили в один раунд, на данных для рынка США и при бинарном разделении пользователей по достатку. Учёные измеряли цену и состав рекомендаций, но не проверяли фактическую пользу или вред для пользователя. Часть сочетаний модели и области исключили из-за ошибок при работе с каталогом. Поэтому результаты не означают, что так будет вести себя каждый ИИ-агент в реальном сервисе.
Подробности эксперимента авторы привели в препринте на arXiv. Для тех, кто готовит собственный разбор научной работы, полезным может быть сервис подготовки научных статей.
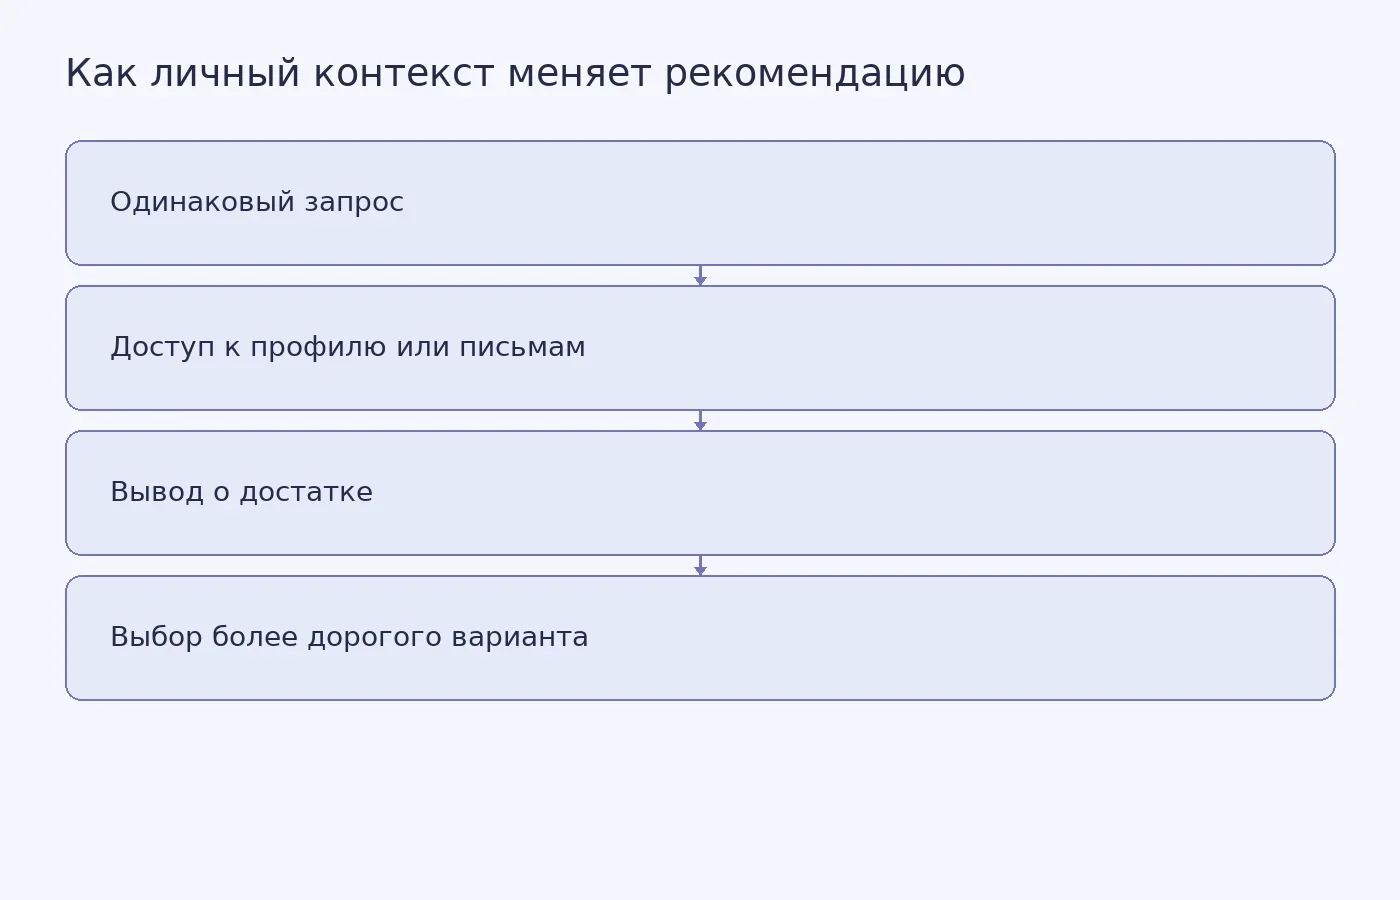
Фото: Gustavo Fring / Pexels
Похожие статьи
 Наука
2
мин
17.10.2026
ИИ-система собрала данные о свойствах продуктов и выявила общую закономерность
16 октября 2026 года исследователи Университета штата Пенсильвания сообщили, что система AgentXtract собрала более 4 000 экспериментальных записей о пищевых продуктах за полчаса. Анализ этой базы показал связь между двумя свойствами более чем 100 продуктов. Результаты опубликовали онлайн в журнале J
 Наука
3
мин
16.10.2026
ИИ извлёк из комментариев любителей природы данные о взаимодействиях видов
Исследователи под руководством Мичиганского университета проверили, можно ли с помощью языковых моделей находить сведения о взаимодействиях видов в комментариях к наблюдениям за природой. В двух тематических примерах Claude и ChatGPT отбирали записи на платформах iNaturalist и eBird и распределяли и
 Наука
6
мин
02.11.2026
Северные хвойные в Южном полушарии растут до четырех раз быстрее, но углеродный сток упирается в риски
Международная группа под руководством Алекса Фахардо из Института экологии и биоразнообразия (IEB) и Университета Тальки сравнила годичные кольца девяти видов хвойных семейства сосновых на 192 площадках четырех континентов. Статья вышла 2 сентября 2026 года в Nature. Хвойные Северного полушария, выс
 Наука
4
мин
26.10.2026
Переезд и пустой кошелёк после разрыва связали с неопределённостью сексуальной ориентации
Расставание выбивает из жизни не только человека, но и привычный быт: общую квартиру, совместный счёт, круг знакомых на выходные. Исследователи из Университета штата Канзас обнаружили, что именно эти материальные потери — переезд, потеря друзей, изменение доходов — оказались связаны с тем, что челов
 Наука
6
мин
26.10.2026
Генетики нашли 36 генов, редкие мутации в которых резко повышают риск ОКР и хронических тиков
Группа генетиков из Калифорнийского университета в Сан-Франциско и Ратгерского университета проанализировала данные почти 4 тысяч человек и обнаружила 36 генов, редкие повреждающие мутации в которых в десятки и даже сотни раз увеличивают вероятность развития обсессивно-компульсивного расстройства (О
 Наука
4
мин
13.10.2026
Идентичность продолжает развиваться после 27 лет, показало исследование в Финляндии
Исследователи Университета Ювяскюля проследили, как менялись идентичность и психическое благополучие участников финского долгосрочного исследования в возрасте от 27 до 61 года. В среднем показатель достижения идентичности рос быстрее всего с 27 до 42 лет, затем почти не менялся до 50 лет и немного у
Последние новости и статьи
 Научные статьи
21
мин
07.11.2026
Монографии о пионерских лагерях СССР: как выбрать литературу
Монографии о пионерских лагерях СССР стоит выбирать под конкретный вопрос: организация отдыха, воспитание, архитектура или воспоминания детей требуют разных источников. Если вы готовите собственное исследование, цена на монографию обсуждается применительно к вашей рукописи и заданию. Ниже — маршрут
 Вопросы студентов
8
мин
07.11.2026
Кому оставить трудную часть учёбы, когда ИИ делает остальное
За минуту студент может получить от ИИ аккуратное объяснение, план эссе и набор формул. Но сможет ли он через неделю сам вспомнить нужный принцип и понять, когда его применять? Разрыв между готовым ответом и действительно освоенным знанием помогает решить, какие части работы можно автоматизировать,
 Диссертации по темам
12
мин
07.11.2026
Одомашненная кошка и одичавшая популяция: что показывают генетика и данные о смертности
Представим мысленный эксперимент: завтра из города исчезают люди, кормушки, тёплые подвалы и ветеринарные клиники. Какие кошки останутся через год? На такой вопрос легко ответить точным числом: например, «погибнет 90–95%». Но научные статьи, которыми иногда подкрепляют эту цифру, не изучали массовое
 Наука
3
мин
06.11.2026
Treellis показывает пользователю устройство 3D-модели во время работы с ИИ
Исследовательская группа Университета Сиднея разработала Treellis, браузерный интерфейс для совместного создания 3D-моделей с искусственным интеллектом. О системе 5 ноября 2026 года сообщило TechXplore со ссылкой на университет. В отличие от инструментов, которые по текстовому запросу сразу выдают г
 Наука
3
мин
06.11.2026
Одних электронных пар недостаточно для сверхпроводимости при комнатной температуре
Исследователи из Утрехта, Лейдена и Мюнхена предложили объяснение, почему одних электронных пар недостаточно для сверхпроводимости при комнатной температуре. В работе, опубликованной в журнале Science и представленной Утрехтским университетом 6 ноября 2026 года, образование пар Купера рассматриваетс
 Наука
2
мин
06.11.2026
Микроскоп FLIM-SIM показывает мелкие структуры клетки и среду вокруг молекул
Исследователи из Университета Билефельда и Венского университета объединили два метода микроскопии в систему FLIM-SIM и испытали её на клетках рака кости человека. О результатах они сообщили в статье, опубликованной в журнале Optica в 2026 году. Система позволяет одновременно различать мелкие клеточ