


Содержание статьи
Наука
23.10.2026
3
мин
Исследователи из Университета Иллинойса в Урбане-Шампейне 21 октября 2026 года сообщили, что алгоритм CARL сохранил преимущество, полученное в симуляции, во время испытаний на трёх физических роботах. Метод объединил обучение с подкреплением и теорию сокращения, повысив точность отслеживания траектории максимум на 15% по сравнению с методами, использованными для сравнения.
Как CARL удерживает робота возле заданного маршрута
CARL расшифровывается как обучение с подкреплением с учётом сокращения. При обычном обучении с подкреплением алгоритм пробует разные действия и получает награду за удачное поведение. В этой работе исследователи добавили математическое описание того, как должна уменьшаться ошибка движения.
CARL одновременно обучает политику управления, то есть правило выбора действий робота, и метрику управления сокращением. Эта метрика задаёт пространство, в котором ошибка отслеживания должна сжиматься. Исследователи встроили её непосредственно в функцию награды. В репозитории проекта метод описан как алгоритм PPO, дополненный наградой, сформированной с помощью этой метрики. PPO, или оптимизация политики близкими обновлениями, применяют для обучения поведения робота.
Теория сокращения не исключает небольших отклонений от маршрута. Она задаёт математические пределы их роста. Поэтому обучение с подкреплением ищет эффективное поведение, а теория управления ограничивает, насколько далеко система может отклониться от устойчивого движения.
Представим, что робот должен ехать по линии, а в симуляции его масса составляет 1 кг. Настоящее устройство может весить 1,2 кг, и та же команда управления даст немного другой результат. CARL должен не просто повторить действия, найденные в виртуальной модели, а выбирать их так, чтобы ошибка оставалась в пределах, заданных метрикой. Это условный пример механизма, а не отдельный эксперимент исследователей.
Сначала авторы проверили CARL в симуляции, затем перенесли его на реальные устройства. Испытания прошли на колёсном TurboBot 3 Burger, летающем дроне с машущими крыльями и шестиногом роботе Jethexa. По сообщению университета, в этом наборе экспериментов метод опередил предыдущие алгоритмы максимум на 15%. Преимущество, полученное в симуляции, сохранилось и на физических роботах, несмотря на различия между моделью и реальными устройствами.
Результат указывает, что CARL лучше справлялся с описанным авторами разрывом между симуляцией и реальностью. Но он не доказывает, что алгоритм будет так же работать на любых роботах и в любых условиях. В доступных материалах нет числа запусков, точных ошибок для каждого устройства и подробностей статистического анализа. Полный экспериментальный раздел статьи также недоступен. Работа опубликована в журнале IEEE Transactions on Robotics, DOI: 10.1109/TRO.2026.3727138.
Открытый код и описание метода могут быть полезны тем, кто готовит научную статью по робототехнике, но репозиторий сам по себе не заменяет полного описания рецензируемого эксперимента.
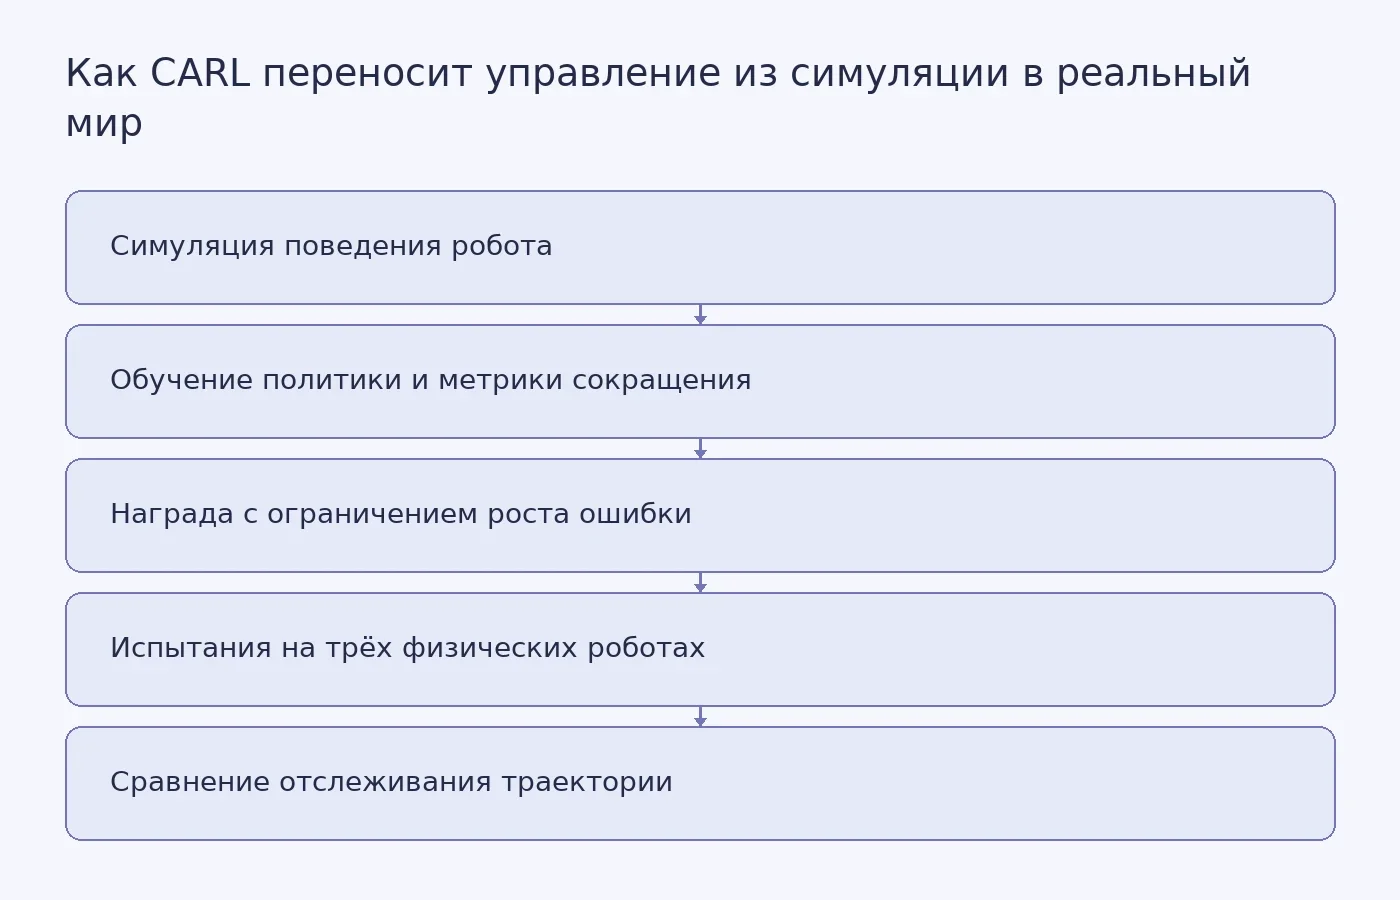
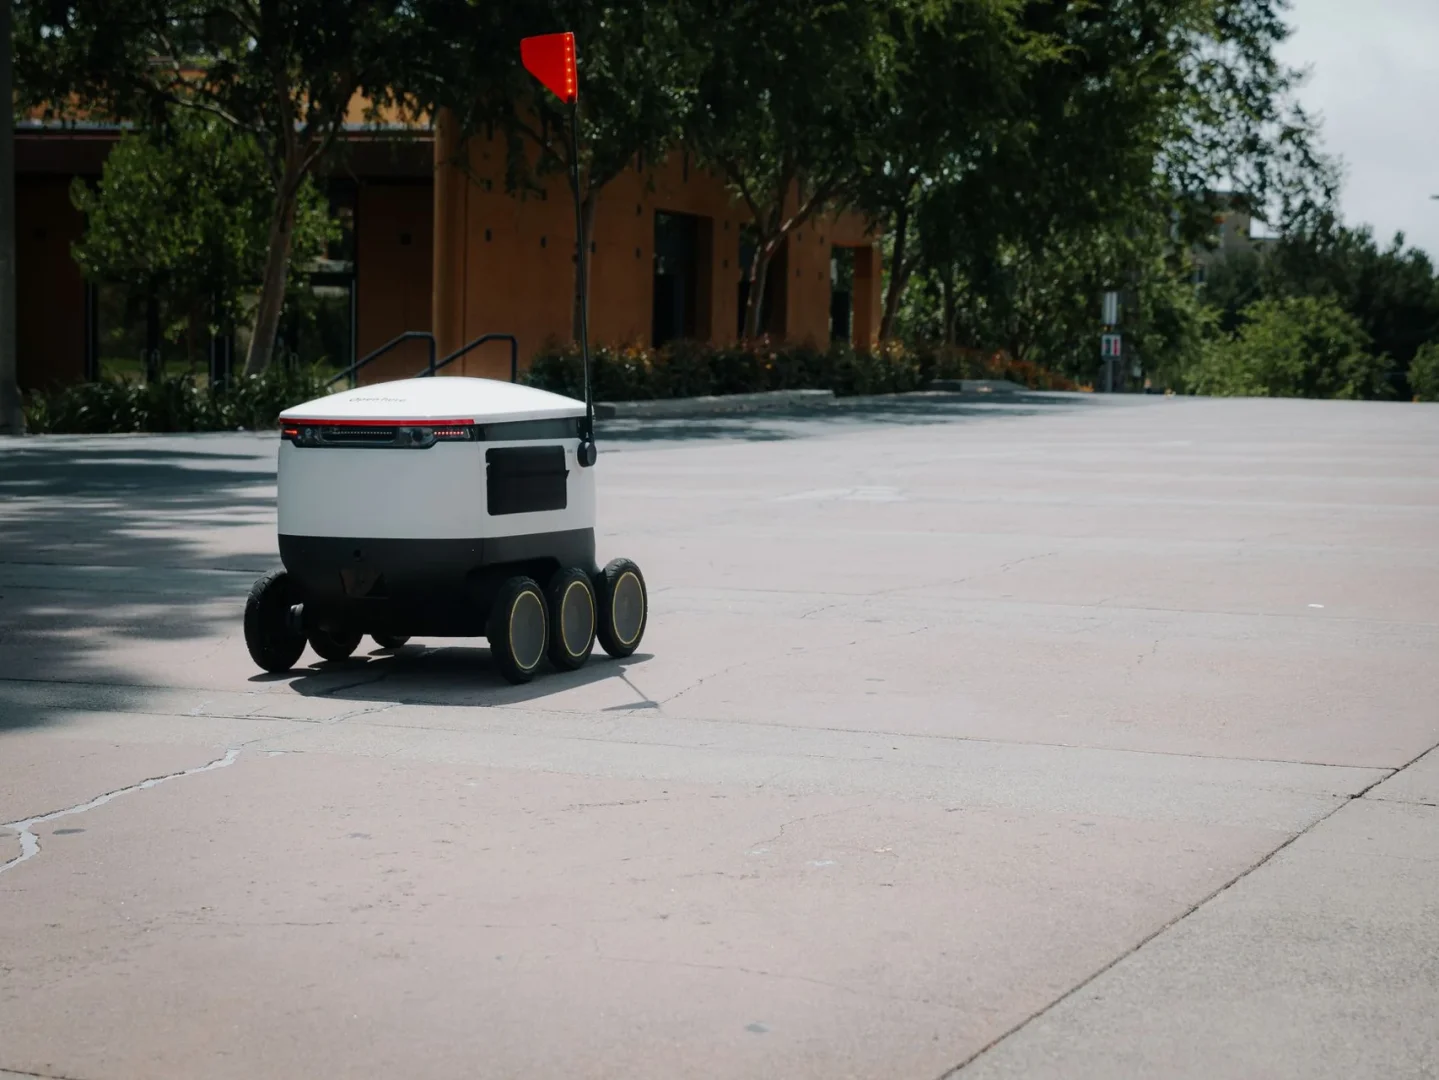
Фото: Kindel Media / Pexels
Похожие статьи
 Наука
3
мин
05.10.2026
Лесная подстилка помогает удерживать углерод в почве после рубки
На 12 лесных участках в Британской Колумбии за 20 лет наблюдений сохранение лесной подстилки помогло удержать углерод в почве после рубки. О результатах исследования Wallace и коллег сообщил научный журнал Eos 5 октября 2026 года. Работа опубликована в Journal of Geophysical Research: Biogeosciences
 Наука
4
мин
03.10.2026
Облачная платформа помогла находить задержки в ПО беспилотных автомобилей
Исследовательская группа Сайтамского университета во главе с профессором Такуей Адзуми вместе с Astemo проверила систему сквозной трассировки CART в облачной среде для разработки беспилотных автомобилей. О результатах Сайтамский университет сообщил 3 октября 2026 года. Облака точек из симулятора CAR
 Наука
4
мин
11.10.2026
Алгоритм RAP использовал прошлые состояния Арктики для прогноза площади льда на девять месяцев вперёд
Исследователи Нью-Йоркского университета в Абу-Даби разработали алгоритм RAP, который по историческим данным прогнозирует площадь арктического морского льда на срок до девяти месяцев. Результаты опубликованы 5 октября 2026 года в журнале Scientific Reports. В ретропрогнозах, то есть проверках на про
 Наука
5
мин
09.10.2026
Как предсказать исход системы, если в начале он неразличим для алгоритма
Физики из Университета Иллинойса показали, как детерминированная система может оставаться практически непредсказуемой в начале и становиться понятнее по мере развития. В работе, опубликованной 11 сентября 2026 года в журнале Nature Communications, исследователи нашли в клеточном автомате топологичес
 Наука
3
мин
13.10.2026
Водяная «шапка» tau помогает белку присоединяться к растущей фибрилле
Исследователи Северо-Западного университета США вместе с учёными Калифорнийского университета в Санта-Барбаре описали механизм, который помогает белку tau вовлекать новые молекулы в рост патологических фибрилл. Результаты опубликовали 12 октября 2026 года в журнале Proceedings of the National Academ
 Наука
3
мин
06.10.2026
Как липидный сигнал помогает клеткам справляться с повреждением мембраны
Исследователи Университета Дзюнтендо в Японии описали, как эпителиальные клетки реагируют на повреждение мембраны бактериальными токсинами. В сообщении университета, опубликованном Phys.org 5 октября 2026 года, говорится: после того как через поры в клетку проникает кальций, образуется липид 12-HHT.
Последние новости и статьи
 Наука
4
мин
23.10.2026
Модифицированный пористый материал извлёк редкоземельные элементы из воды с избытком железа
22 октября 2026 года Университет Райса сообщил о лабораторных испытаниях пористого материала: он извлекал неодим, гадолиний и диспрозий из воды, даже когда железа было в сто раз больше. Исследование опубликовано в журнале ACS Applied Materials & Interfaces. На каждый грамм сорбента приходилось д
 Наука
3
мин
23.10.2026
Согласование мембраны и электрода удвоило выпуск водорода в электролизёре
Исследователи Университета Гронингена сообщили, что согласованное сочетание материалов в протонном керамическом электролизёре удвоило выпуск водорода при том же потреблении электричества. Устройство проработало стабильно не менее 500 часов. Результаты исследования опубликовали 14 октября 2026 года в
 Наука
2
мин
23.10.2026
Сенсорный экран вплели в рукав: что выдержал текстильный дисплей из Сингапура
Исследователи Национального университета Сингапура встроили сенсорный экран в рукав одежды. В статье, опубликованной 21 октября 2026 года в журнале Nature, они описали прототип размером 168 × 105 мм. Он показывает изображения и видео, реагирует на прикосновения и передаёт данные по Bluetooth.Пятьдес
 Полезные материалы
6
мин
23.10.2026
Почему сельскохозяйственные животные всё-таки эволюционируют
Куры, которых разводят ради большого количества яиц, и коровы, от которых получают много молока, не перестают эволюционировать. Меняется другое: в хозяйстве люди часто решают, какие животные станут родителями следующего поколения. В дикой популяции такого решения нет, но человеческое воздействие всё
 Полезные материалы
12
мин
23.10.2026
Автомобиль как смартфон: что цифровые функции меняют в покупке и вождении
На экране автомобиля можно включить музыку, построить маршрут, принять звонок и изменить настройки салона. Для водителя это удобный пульт управления, а для покупателя всё чаще часть самого продукта. Машину начинают оценивать не только по двигателю, батарее, цене и запасу хода, но и по скорости интер
 Полезные материалы
13
мин
23.10.2026
Корень не выбирает один сценарий: как ABA меняет долю клеток в состоянии ответа на засуху
Если смотреть на верхушку корня как на карту, всё выглядит достаточно строго: покровная ткань, кора, проводящие элементы, меристема. Клетки возникают из определённых линий и постепенно дифференцируются. Но одноклеточный анализ показал, что у этой карты есть ещё один слой. В большинстве клеточных лин