


Содержание статьи
Полезные материалы
13.10.2026
13.10.2026
7
мин
На реконструкции торт превратился в стопку из трёх бутербродов. Собака в ванне стала похожей по цвету козой. Такие ошибки показывают, что модель не достаёт из мозга готовую фотографию. Она строит изображение по неполному сигналу и может убедительно заполнить то, чего в этом сигнале не хватает.
Так работает Brain-IT, система для восстановления изображений по данным функциональной магнитно-резонансной томографии (фМРТ). Её автор Michal Irani представила работу на Международной конференции по обучению представлений ICLR в 2026 году. Статья прошла рецензирование; доступны страница статьи и аннотация. Авторы заявляют, что метод улучшает качество реконструкций, а для нового участника ему требуется около часа фМРТ-данных вместо примерно 40 часов, характерных для прежних методов.
Задача здесь узкая: участник смотрит на изображения в сканере, а модель пытается восстановить увиденное. Чтобы понять, почему это не равнозначно чтению мыслей, полезно проследить путь от измерения до картинки.
Что показывает снимок мозга
ФМРТ отслеживает изменения кровотока, связанные с активностью нервной ткани. Она не записывает мысли и не делает снимок изображения, которое человек видит. Сканер фиксирует сигнал вокселями, объёмными элементами изображения. В обычных сканерах один воксель может охватывать около 3 мм³; в использованных авторами наборах с более высоким разрешением он составлял около 1 мм³.
Воксель отражает смешанный сигнал от множества нейронов, а не активность отдельной клетки или готовую метку вроде «торт». Модель ищет связи между распределённым сигналом и признаками увиденной сцены. Как и в других исследованиях, важно различать то, что именно измеряли, и то, как интерпретируют результат. Об этом подробнее говорится в материале о методологии исследования и границах научного вывода.
От мозгового сигнала к изображению
В Brain-IT декодер восстанавливает изображение по сигналу фМРТ. Кодировщик работает в обратном направлении: по картинке предсказывает, каким мог бы быть сигнал мозга, если бы человек её увидел. Совместное обучение этих моделей позволяет использовать изображения, которым не соответствуют реальные записи фМРТ. По данным редакционного материала MIT Technology Review, около 70% обучающих изображений не были изначально связаны с такими записями.
Сам декодер предсказывает два вида признаков. Семантические помогают задать содержание сцены, например наличие животного или еды. Структурные описывают её грубую композицию: расположение объектов, светлых и тёмных участков. Затем диффузионная модель, начиная с шума, формирует картинку, согласованную с этими признаками.
Это похоже на попытку восстановить снимок по двум неполным подсказкам: что на нём изображено и где примерно находятся основные цветовые области. Подсказки сужают выбор, но не задают единственный точный вариант. Если мозговой сигнал неоднозначен, генератор может сохранить общий контекст или цвет, но подменить объект. Так торт становится бутербродами, а собака в ванне — козой.
Авторы Brain-IT сообщают, что их подход превосходит предыдущие методы по визуальному качеству и стандартным объективным метрикам. В аннотации также указано, что результаты при одном часе данных нового участника сопоставимы с результатами прежних методов, обученных на полных 40-часовых записях. Однако доступное описание не даёт достаточных сведений о тестовой выборке, разделении данных, точных значениях метрик и статистической неопределённости. Поэтому эти результаты корректно приводить как вывод авторов, а не как независимую проверку.
Почему требуется калибровка
Сигналы разных людей не совпадают автоматически: различаются мозговая анатомия и индивидуальные реакции. Поэтому модель, обученная на одних участниках, нуждается в настройке на данных нового человека.
В исходной подготовке, описанной MIT Technology Review, использовали данные восьми человек. Каждому показывали около 9000 изображений в сканере фМРТ с высоким разрешением. Авторы Brain-IT заявляют, что примерно часа данных нового участника хватает для результатов, сопоставимых с прежними методами на 40-часовых записях. Это сокращает время настройки, но не устраняет её.
Родственный проект той же группы, представленный на конференции Cognitive Computational Neuroscience в виде постера, посвящён универсальному кодировщику. Его обучают на данных разных людей, наборов и сканеров, а затем проверяют перенос на нового участника. Постер описывает направление и заявленные возможности, но сам по себе не даёт оснований утверждать, что система одинаково работает во всех условиях.
Сокращение сканирования может уменьшить время и расходы на исследования. MIT Technology Review приводит оценку стоимости фМРТ в 600–1000 долларов за час. Но практический смысл результата ограничен заявленным уменьшением времени калибровки: индивидуальные данные всё ещё нужны.
Почему это не чтение любых мыслей
В описанном эксперименте человек видит визуальные стимулы во время сканирования, а модель заранее обучена связывать изображения с мозговой активностью. Речь идёт о восстановлении предъявленной картинки в экспериментальных условиях, а не о распознавании любого намерения, воспоминания или мысли.
Доступные материалы не показывают, что Brain-IT восстанавливает содержание, которое участник не видел, или получает сигнал без его участия. Для процедуры человек должен находиться в сканере и выполнять исследовательскую задачу. Само по себе это не доказывает невозможность иных способов декодирования, но описанная работа их не демонстрирует.
Авторы пока не показали реконструкцию воображаемых образов или сновидений. В редакционном материале MIT Technology Review такие задачи названы возможными направлениями дальнейшей работы. Переход к электроэнцефалографии (ЭЭГ) также обсуждается как перспектива, а не как результат Brain-IT.
Убедительно выглядящая реконструкция не обязательно точна: генератор дополняет ограниченный сигнал закономерностями, усвоенными при обучении. Пока авторы сообщают о более качественном восстановлении увиденных изображений и меньшем времени настройки для нового участника. Насколько хорошо результат переносится на другие группы людей, сканеры и задачи, по доступному описанию оценить нельзя.
Источники
- Michal Irani. Brain-IT: Image Reconstruction from fMRI via Brain-Interaction Transformer. ICLR, 2026. Страница статьи и аннотация. Рецензированная конференционная публикация, открытый доступ.
- Jessica Hamzelou. An AI “mind-reading” tool can reconstruct what you’re looking at based on a brain scan. MIT Technology Review, 1 октября 2026 года. Редакционный материал, не первичная научная публикация.
- Roman Beliy, Navve Wasserman, Amit Zalcher, Michal Irani. The Wisdom of a Crowd of Brains: A Universal Brain Encoder. Постер, Cognitive Computational Neuroscience, 2026. Текст постера.
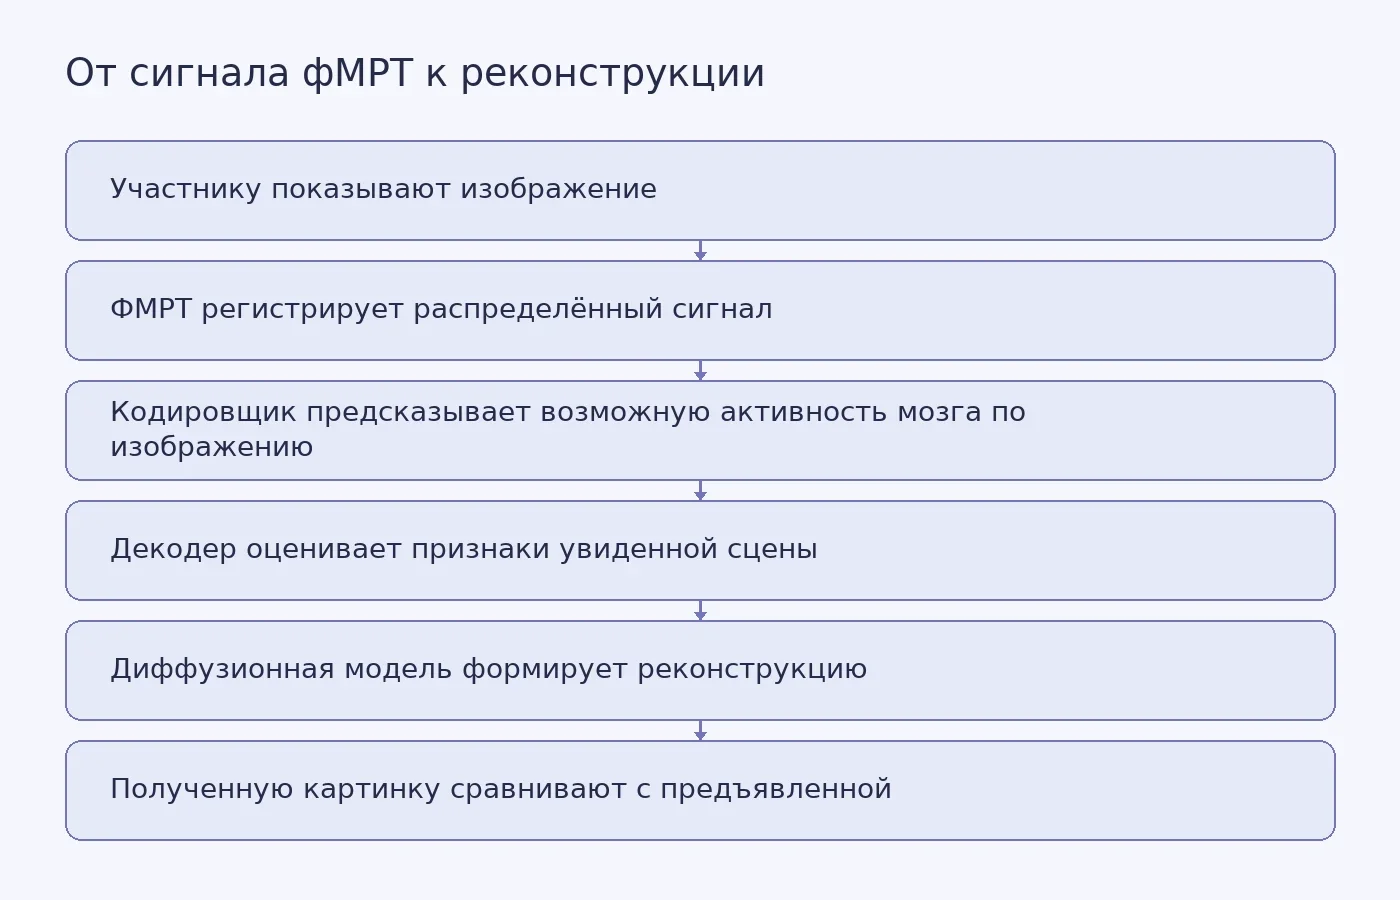
Фото: MART PRODUCTION / Pexels


Похожие статьи
 Полезные материалы
8
мин
07.10.2026
Ночная очистка мозга: что сон и глимфатическая система могут рассказать о болезни Альцгеймера
Мозг не выключается, когда человек засыпает. Среди процессов, которые меняются во время сна, учёные изучают движение жидкости вокруг сосудов и перенос растворённых веществ в мозговой ткани. Эту предполагаемую сеть путей называют глимфатической системой: название отсылает к глиальным клеткам и лимфат
 Полезные материалы
12
мин
03.10.2026
Что снимок сетчатки может рассказать о риске фибрилляции предсердий
На OCT-снимке глазного дна видны не только общие контуры сетчатки, но и ее отдельные слои. Один из них, макулярный комплекс ганглиозных клеток и внутреннего плексиформного слоя, обозначают как mGCIPL. В исследовании двух британских когорт этот слой оказался тоньше у людей с фибрилляцией предсердий,
 Полезные материалы
25
мин
11.10.2026
Синтез речи на длинной дистанции: что ломается при чтении целого романа
Четырнадцать фраз, нарочно набитых самыми трудными звуками крымскотатарского — къ, гъ, нъ, дж, — выглядят как честный экзамен для синтезатора речи. На них удобно сравнивать версии модели между собой. Но между этим экзаменом и чтением романа вслух лежит пропасть, и автор проекта «Ана юрт» показал её
 Полезные материалы
6
мин
12.01.2023
10731
Как подготовить стендовый доклад для конференции?
Презентация в форме стендового доклада является эффективным способом подачи текстовой информации, значительно упрощая ее восприятие слушателями. Особенности стендового доклада и его отличия от устной презентации Стендовый доклад – это краткое, тезисное изложение диссертационного исследо
 Полезные материалы
13
мин
07.10.2026
Как вымышленные ИИ-эксперты попадают в научную литературу
У записи есть авторы, название журнала и DOI. Поиск находит её за секунду. Но подтверждает ли DOI, что автор существует, журнал действительно выходит, а статью рецензировали?Нет. DOI указывает на цифровой объект и помогает его найти, но сам по себе не удостоверяет личность автора, существование журн
 Полезные материалы
8
мин
08.10.2026
Печати княгини Марии Всеволжей: как находка во Владимире связала её с княжеским двором
Документы, которые когда-то скрепляли найденные во Владимире свинцовые печати, не сохранились. На двух буллах остались изображения святой Марии и святого Дмитрия. Археологи связывают их с Марией Всеволжей, женой князя Всеволода Большое Гнездо. Атрибуция позволяет спросить, участвовала ли княгиня в о
Последние новости и статьи
 Полезные материалы
9
мин
13.10.2026
Кефир и мышцы: что известно о связи кишечника с восстановлением
После тренировки легко представить простую цепочку: съесть белковый продукт, переварить его, восстановить мышцы. Ферментация добавляет в эту схему несколько возможных звеньев. Микроорганизмы меняют белковую структуру, образуют пептиды и метаболиты, а в некоторых продуктах сохраняются сами микроорган
 Полезные материалы
16
мин
13.10.2026
Поведенческий тренинг при СДВГ и аутизме: что действительно показали рандомизированные испытания
Одна и та же рекомендация может означать разные вещи. В кабинете родителям предлагают коротко сформулировать просьбу, заметить подходящее поведение и потренировать новый навык. Дома под «поведенческим методом» иногда понимают таблицу наград, наказания и требование подчиняться любой ценой. Автоматиче
 Полезные материалы
7
мин
13.10.2026
Пеленг есть, координат ещё нет: как испытывали акустический поиск пожаров в угольном пласте
Два чувствительных элемента стоят в одной точке, но ориентированы по-разному. К ним приходит акустический импульс. Если сравнить первые колебания, можно оценить, с какой стороны пришла волна. Но расстояние до источника из одного направления не следует: неизвестной остаётся вся линия, а не одна точка
 Наука
3
мин
12.10.2026
Математики заявили о сильном трёхмерном монотайле Chair44
Ioannis Tsiokos 16 сентября 2026 года разместил на arXiv препринт о Chair44, одной трёхмерной фигуре, копиями которой, согласно заявленному доказательству, можно заполнить всё пространство без пробелов и пересечений, но нельзя получить узор с периодическим повторением. 29 сентября Felix Flicker опуб
 Наука
3
мин
12.10.2026
В Латвии изучили захоронение шести семигалльцев эпохи викингов
Археологи исследовали могилу шести человек на кладбище Чункани-Дренгери возле Рижского залива. Радиоуглеродная датировка отнесла её ко второй половине IX века, к раннему периоду эпохи викингов. В захоронении нашли останки четырёх мужчин, мальчика и девочки. Генетические данные и особенности обряда у
 Образование
2
мин
12.10.2026
ПетрГУ открыл новый сезон проекта «Уик-энд по-французски»
Петрозаводский государственный университет 12 октября 2026 года сообщил о начале нового сезона муниципального проекта «Уик-энд по-французски». В нём участвуют младшие школьники из разных школ Петрозаводска. Знание французского языка для этого не требуется, а следующая встреча назначена на 24 октября