


Содержание статьи
Научные статьи
28.10.2026
6
мин
При проверке выгрузки легко посчитать переводы строки и объявить число участников. Но комментарий в одной ячейке CSV может занимать несколько физических строк. Поэтому сначала разберите файл с его разделителем и правилами кавычек, а затем считайте записи данных.
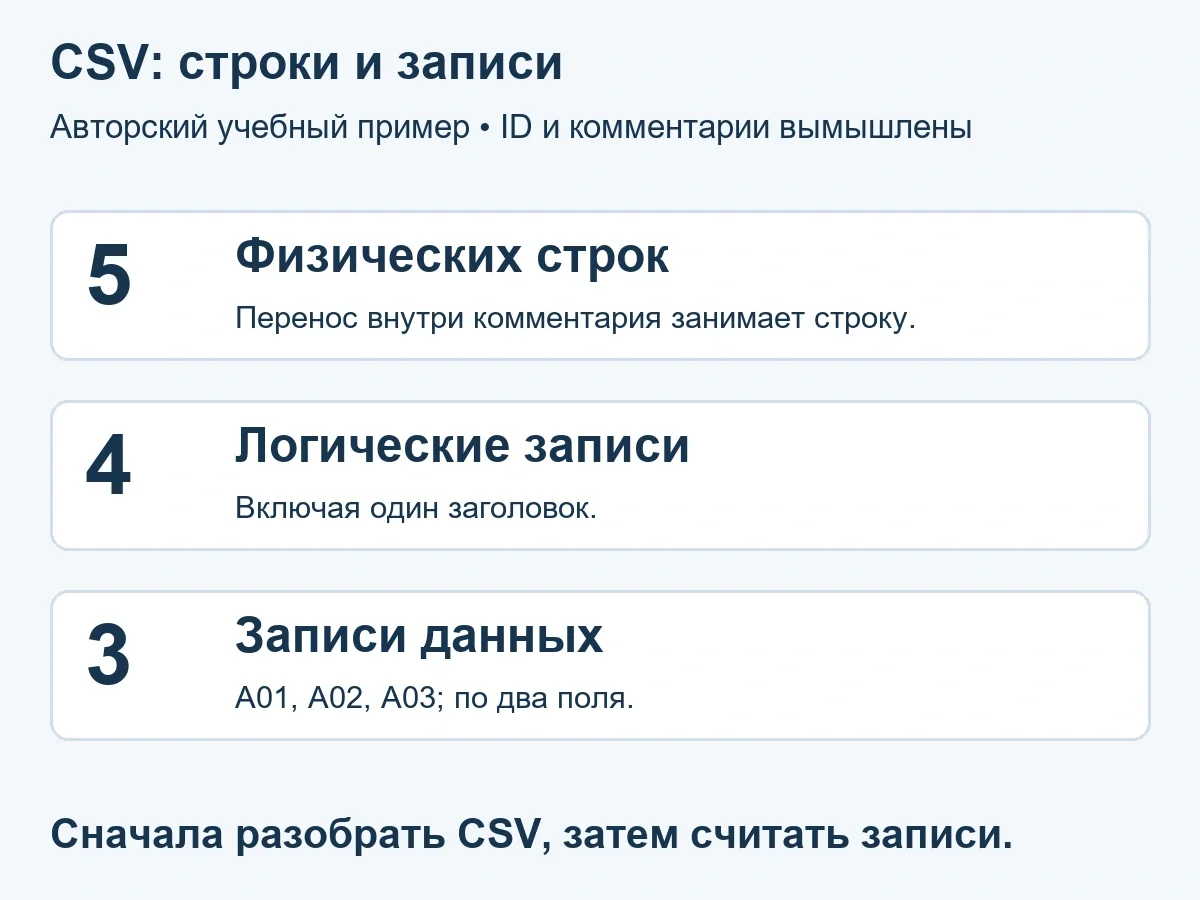
Ниже специально созданный учебный текст с тремя вымышленными идентификаторами A01, A02, A03 и комментариями. Опрос не проводился. В нём выбран разделитель «;», двойная кавычка ограничивает поле, а удвоенная кавычка внутри такого поля передаёт одну кавычку. Заголовок состоит из двух имён: id и comment.
Полный CSV: перенос является частью первого комментария
id;comment
A01;"первая строка
вторая строка"
A02;"значение; с точкой"
A03;"он сказал ""да"""
Фрагмент показан целиком. Между словами «строка» и «вторая» стоит перевод строки внутри кавычек. В показанном тексте после A03 стоит ровно один завершающий перевод строки LF. Он завершает эту запись; дополнительной пустой строки в нашем примере нет. Точка с запятой внутри второго комментария относится к значению comment, а не создаёт третий столбец.
Что считаем | Результат в этом примере |
|---|---|
Физические строки текста | 5: заголовок, две строки первого комментария и ещё две записи. |
Логические записи вместе с заголовком | 4: один заголовок и три записи данных. |
Записи данных | 3: A01, A02, A03. |
Поля в каждой записи | 2: id и comment; перенос внутри comment не добавляет поле. |
Прочитайте CSV целиком одним парсером
В документации Python csv объяснено, что строка результата reader может охватывать несколько строк источника, а line_num учитывает прочитанные строки, не число записей. Для файлового объекта документация рекомендует newline="". Ниже для самодостаточного примера используется StringIO; при чтении с диска задайте также фактическую кодировку файла.
import csv
import io

text = ('id;comment\n'
        'A01;"первая строка\nвторая строка"\n'
        'A02;"значение; с точкой"\n'
        'A03;"он сказал ""да"""\n')
reader = csv.reader(io.StringIO(text, newline=""),
                    delimiter=";", strict=True)
rows = list(reader)
header, data = rows[0], rows[1:]
assert len(header) == 2
assert header == ["id", "comment"]
assert all(len(row) == 2 for row in data)
assert len(data) == 3
assert data[0][1] == "первая строка\nвторая строка"
assert data[1][1] == "значение; с точкой"
assert data[2][1] == 'он сказал "да"'
print("physical_lines =", reader.line_num)
print("records_with_header =", len(rows))
print("data_records =", len(data))
for row in data:
    print(row[0], repr(row[1]))
assert reader.line_num == 5
Ожидаемый вывод для приведённого учебного примера:
physical_lines = 5
records_with_header = 4
data_records = 3
A01 'первая строка\nвторая строка'
A02 'значение; с точкой'
A03 'он сказал "да"'
В repr первого комментария символы \n показывают один перевод строки внутри значения. Это представление строки Python: обратная косая черта и буква n не были отдельным текстом исходной ячейки. В последнем комментарии удвоенные кавычки исходного CSV прочитаны как обычные кавычки вокруг слова «да».
Почему split по строкам и разделителю здесь не подходит
Наивная операция | Что она исказит |
|---|---|
Считать каждую физическую строку участником | Первая запись будет ошибочно разделена на две. |
Разделять каждую строку по «;» | Внутренняя точка с запятой в A02 станет лишним полем. |
Удалить все кавычки до чтения | Исчезнут границы сложных полей и способ записи кавычки. |
Считать строку заголовка наблюдением | К трём учебным ID добавится строка с именами полей. |
strict=True заставляет парсер возбуждать исключение csv.Error при некорректном CSV по правилам этого парсера. Это не проверка научной корректности, уникальности ID и всех ограничений вашей схемы. Поэтому после разбора код отдельно проверяет два поля и точные имена заголовка, два поля каждой записи данных и учебные значения. Для чужого файла сначала определите диалект и ожидаемые столбцы, а не переносите настройки «;» и два поля автоматически.
Что записать в журнал проверки
- Какой файл и какая его версия прочитаны; исходник сохранён.
- Какие кодировка, разделитель и правила кавычек заданы.
- Отдельно указаны физические строки, записи с заголовком и записи данных.
- Проверено число полей и сохранение многострочного комментария.
- Число записей не объявлено числом людей без проверки единицы наблюдения и ID.
Для нашего файла итог: пять физических строк, четыре логические записи вместе с заголовком и три записи данных. Количество строк в текстовом редакторе не заменяет разбор структуры. После него типы полей, ведущие нули и пропуски проверяются отдельно — как в статье об импорте CSV с сохранением ID и десятичных дробей.
Если требуется подготовить собственную выгрузку к исследовательскому расчёту, можно обсудить консультацию по статистическому анализу. Заранее согласуйте исследовательский вопрос, структуру исходного файла и объём помощи. Успешное чтение файла само по себе не подтверждает достоверность измерений.


Похожие статьи
.jpg) Научные статьи
11
мин
07.11.2023
3520
Как правильно оформить научную статью: пример
Грамотное оформление научной статьи упрощает публикацию исследования в выбранном журнале. Соблюдение стандартов к научным публикациям, а также требований и рекомендаций издания являются одними из основополагающих критериев качества публикуемой работы. Требования ГОСТ к оформлению научной статьи
 Научные статьи
7
мин
27.10.2026
Почему bool("False") даёт True: как разобрать текстовые «да» и «нет»
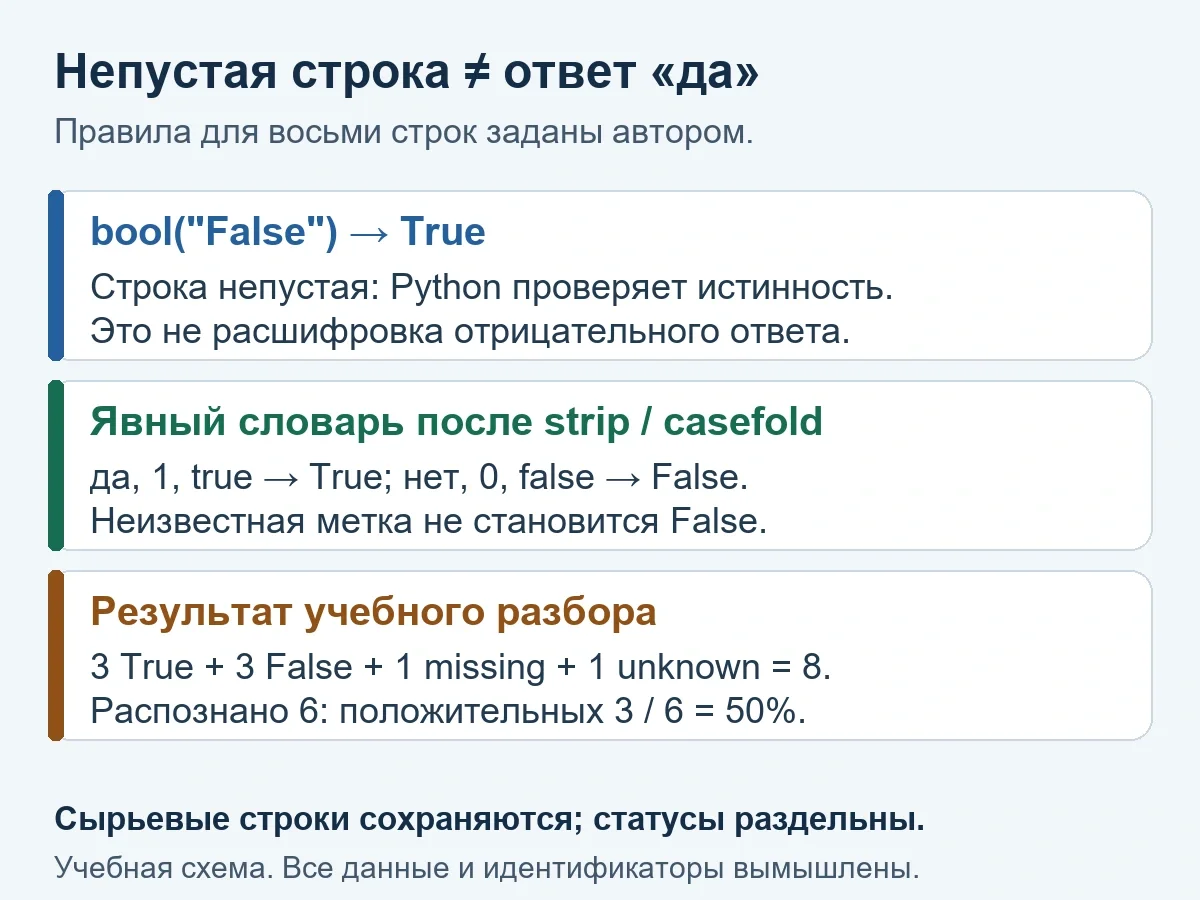
Вы загружаете файл и видите в столбце с опросами слова «Да», «нет», «1», «0», «False». Вы хотите превратить это в логический тип, чтобы посчитать доли или отфильтровать анкеты. Пишете bool("False") — интерпретатор возвращает True. Python не читает написанное слово, он проверяет истинность самого объ
 Научные статьи
8
мин
14.10.2026
Как ответить рецензенту научного журнала: шаблон письма
В отзыве может быть одно короткое замечание о методе, а за ним несколько страниц комментариев. Чтобы редактору не приходилось сопоставлять их с рукописью самостоятельно, ответьте на каждый пункт отдельно: приведите исходный комментарий, объясните, что сделали, и укажите, где найти изменение. Такое п
 Научные статьи
5
мин
14.10.2026
Что такое DOI и как проверить его в списке литературы
В списке литературы после названия статьи может стоять короткий код, например 10.1000/182. Если открыть его через doi.org, браузер перейдёт на связанную страницу. Такой код называется DOI, цифровым идентификатором объекта. Что обозначает DOI DOI помогает однозначно обозначить объект и найти связанну
 Научные статьи
10
мин
13.12.2023
986
Критический анализ статьи: план написания + пример
Критический анализ научной статьи помогает выявить положительные и отрицательные стороны материала, последовательность и грамотность изложения текста, общее качество работы и соответствие научной статьи стандартных требованиям. План критического анализа статьи: что сюда входит План критическог
Последние новости и статьи
 Оформление работ
23
мин
28.10.2026
40395
Оформление списка литературы в диссертации по ГОСТ
Список литературы в диссертации должен помогать найти именно тот документ, который использовал исследователь: нужное издание книги, статью, редакцию нормативного акта или версию электронного материала. Начните с проверки источников и связи с текстом, затем выберите порядок записей и только после это
 Наука
3
мин
28.10.2026
Инулин снизил боль при остеоартрите колена в шестинедельном испытании
Испытание INSPIRE провели исследователи Университета Ноттингема. 117 взрослых с остеоартритом колена шесть недель либо принимали инулин, либо занимались по цифровой программе физиотерапии, либо сочетали оба подхода, либо получали плацебо. Пресс-релиз университета появился 12 марта 2026 года, материа
 Образование
2
мин
28.10.2026
СПбГУТ и китайская корпорация ТАН обсудили онлайн-курсы и цифровые проекты
28 октября 2026 года в Пекине делегация Санкт-Петербургского государственного университета телекоммуникаций имени профессора М. А. Бонч-Бруевича (СПбГУТ) провела переговоры с китайской корпорацией ТАН. Стороны обсудили совместные образовательные программы и проекты в телекоммуникациях, информационны
 Магистерские диссертации
6
мин
28.10.2026
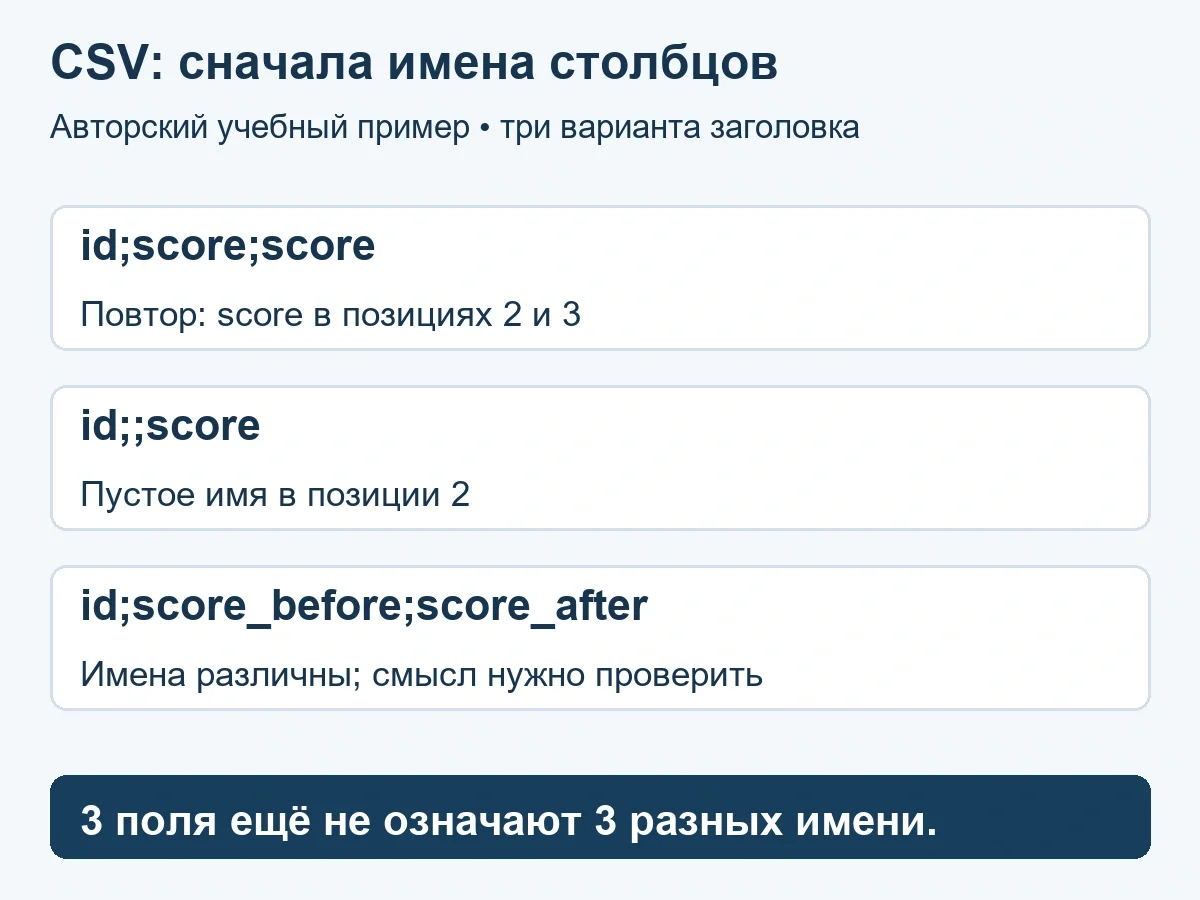
Повторяющиеся и пустые заголовки CSV: проверьте имена до DictReader
В первом учебном CSV ниже три столбца: id, score и score. После чтения его строки через DictReader в показанном коде словарь содержит два ключа: id и score. В этом примере причина в повторяющемся заголовке: одному имени нельзя одновременно сопоставить два независимых значения в обычном словаре Pytho
 Кандидатские диссертации
5
мин
28.10.2026
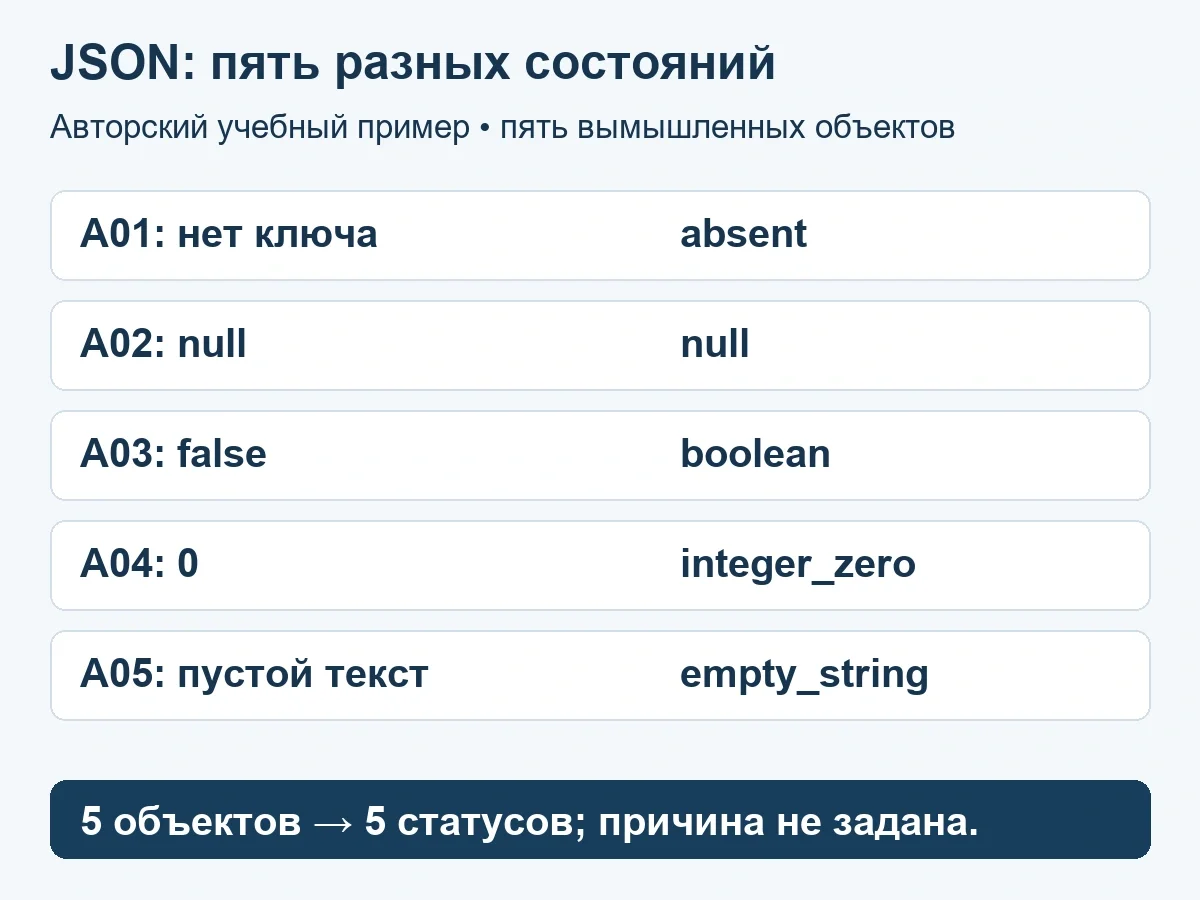
В JSON нет поля, null, false, 0 или пустая строка: как сохранить различия
После выгрузки данных пять разных записей могут оказаться в одной категории «пусто», если смотреть только на истинность значения. Для исследовательского набора это рискованно: отсутствие ключа и известный ноль обозначают разные состояния. Разберём представление, не гадая, почему ответ не был записан
 Наука
2
мин
28.10.2026
В горах Колумбии не нашли хитрид-грибок, но опасный вариант обнаружили в 20 км
Исследователи Гентского и Трирского университетов обследовали более 2 000 лягушек, жаб и саламандр в горах Сьерра-Невада-де-Санта-Марта на севере Колумбии. Признаков хитрид-грибка там не обнаружили, но примерно в 20 километрах от обследованной зоны нашли высоковирулентный вариант возбудителя. Об эти