


Содержание статьи
Защита и размещение диссертации
29.10.2026
29.10.2026
7
мин
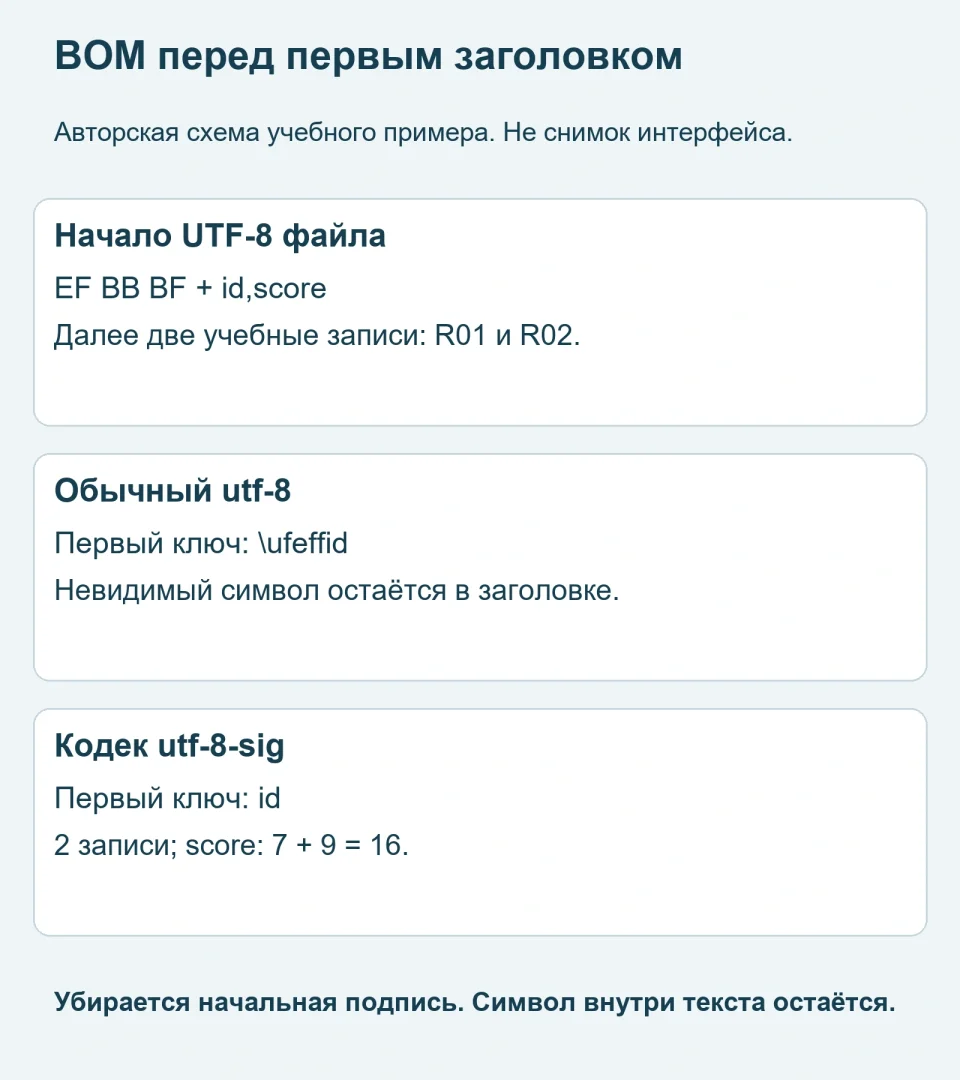
Перед вами файл, в котором первый столбец как будто называется id, но обращение к строке по ключу id не срабатывает. Одна из возможных причин: начальная подпись UTF-8, которая после обычного декодирования осталась символом U+FEFF в первом имени. Задача здесь узкая: проверить эту гипотезу на известном учебном файле, сохранить две записи и не вычищать похожие символы по всему тексту.
В вымышленном CSV есть столбцы id и score, записи R01 и R02 и условные значения 7 и 9. Это учебные числа, а не наблюдения реальных участников. Байты собраны прямо в коде, поэтому пример воспроизводится без внешнего файла. Код выполнен в Python 3.12.14 без дополнительных пакетов; реальный интерфейс табличной программы не тестировался.
Что делает utf-8-sig
По документации кодека utf_8_sig, при декодировании необязательная подпись UTF-8 в начале данных пропускается. В нашем примере первые три байта — EF BB BF. Обычный utf-8 декодирует их в U+FEFF; вариант utf-8-sig обрабатывает начальную подпись. Для UTF-8 она не выбирает порядок байтов, как можно подумать по названию BOM.
utf-8-sig не угадывает неизвестную кодировку. Отсутствие подписи не доказывает, что перед вами UTF-8; здесь кодировка известна по условию. По умолчанию некорректные последовательности UTF-8 вызывают ошибку, а не исчезают молча. Не добавляйте errors="ignore" только ради успешного чтения, если данные важно сохранить.
| Путь чтения | Что получено в учебном примере |
|---|---|
| Декодирование utf-8 | Первый ключ содержит U+FEFF перед id |
| Декодирование utf-8-sig | Имена ровно id и score |
| Число записей после csv.DictReader | 2 записи, ID R01 и R02 сохранены |
| Сумма score для этих строк | 7 + 9 = 16 |
Законченный пример: байты, имена и две записи
Код csv.DictReader использует первую строку как имена полей, если они не переданы отдельно. Поэтому проверять нужно не только картинку таблицы, но и фактическое содержимое fieldnames. Обозначения plain_keys и sig_keys в выводе — имена после двух способов декодирования; rows — прочитанные строки, sum_score — сумма учебных значений.
Ниже полный код учебного примера и фактически полученный вывод. Обозначения в выводе объяснены рядом с примером.
import csv
from io import StringIO

raw = b"\xef\xbb\xbfid,score\nR01,7\nR02,9\n"
plain_text = raw.decode("utf-8")
sig_text = raw.decode("utf-8-sig")
plain_reader = csv.DictReader(StringIO(plain_text, newline=""))
sig_reader = csv.DictReader(StringIO(sig_text, newline=""))
print("plain_keys =", repr(plain_reader.fieldnames))
print("sig_keys =", repr(sig_reader.fieldnames))
rows = list(sig_reader)
print("rows =", rows)
print("sum_score =", sum(int(row["score"]) for row in rows))
interior = "A\ufeffB"
print("interior_kept =", interior.encode("utf-8").decode("utf-8-sig") == interior)
assert plain_reader.fieldnames == ["\ufeffid", "score"]
assert sig_reader.fieldnames == ["id", "score"]
assert [row["id"] for row in rows] == ["R01", "R02"]
assert len(rows) == 2
plain_keys = ['\ufeffid', 'score']
sig_keys = ['id', 'score']
rows = [{'id': 'R01', 'score': '7'}, {'id': 'R02', 'score': '9'}]
sum_score = 16
interior_kept = TrueЗапись с обратной косой чертой в repr помогает заметить невидимый символ: имя с U+FEFF перед id отличается от обычного id. Assert подтверждает точные имена, два ID и число записей. Преобразование score в int подходит только потому, что в этом маленьком наборе заранее заданы корректные целые значения; полноценная проверка произвольного столбца здесь не реализована.
Почему нельзя просто удалить U+FEFF везде
Начальная подпись и символ внутри текстового поля находятся в разных местах. Проверка interior_kept означает «внутренний символ сохранён»: строка A с U+FEFF между A и B после выбранного декодирования остаётся той же. Это не рекомендация оставлять любой невидимый символ без анализа, а демонстрация границ действия кодека. Решение о содержимом поля требует отдельного правила.
- Сначала сохраните исходные байты и сведения об ожидаемой кодировке. Работайте с копией, а не перезаписывайте источник ради первого удачного чтения.
- Затем посмотрите repr первого имени и список fieldnames. Различайте начальную подпись, пробелы, повторяющиеся заголовки и действительно пустое имя.
- Для самого чтения применяйте utf-8-sig к известному UTF-8 с возможной начальной подписью. Если читаете CSV из файла, указывайте подходящую кодировку и newline=""; в примере используется строковый поток.
- После чтения проверьте имена, количество записей и сохранность ID. Устранение подписи не проверяет схему, диапазоны значений и научный смысл данных.
Контрольная запись для своего импорта
| Что проверить | Что сохранить в журнале |
|---|---|
| Кодировка и начало файла | Ожидаемая кодировка, наличие или отсутствие начальной подписи |
| Заголовки | Фактические имена и согласованный ожидаемый набор |
| Записи | Количество прочитанных строк и контрольные ID |
| Граница проверки | Другие невидимые символы и ошибки значений не исправлялись автоматически |
Если имена действительно повторяются или пусты, нужен другой контроль — проверка заголовков до DictReader. Более общий сценарий с ведущими нулями в идентификаторах разобран в статье об импорте CSV. Подпись UTF-8 не объясняет автоматически любой сбой этих этапов.
Если после проверки импорта нужна консультация по дальнейшим расчётам, можно обсудить статистический анализ вашего набора данных. Передайте исходный файл, описание переменных и вопрос исследования. Успешно прочитанный CSV сам по себе не доказывает пригодность выборки или корректность статистического вывода.


Последние новости и статьи
 Дипломы
18
мин
29.10.2026
50433
Защита дипломной работы. Сроки. Как проходит
Защита дипломной работы начинается не с выхода к экрану, а с проверки допуска, графика и правил своей программы. Дата защиты, срок загрузки текста и время доклада — разные контрольные точки. Если перепутать их, хорошо подготовленное выступление не устранит пропущенный срок представления ВКР. Ниже —
 Диссертации по темам
7
мин
29.10.2026
Почему «виртуальная клетка» пока не заменяет эксперимент
Представим, что исследователь хочет заранее выяснить, как опухолевая клетка ответит на лекарство. «Виртуальная клетка» обещает превратить этот вопрос в вычисление: дать модели описание клетки и вмешательства и получить прогноз. Но клетка не сводится к набору показателей. Гены связаны регуляторными с
 Оформление работ
7
мин
29.10.2026
Список в аргументе по умолчанию Python: почему данные переходят между вызовами
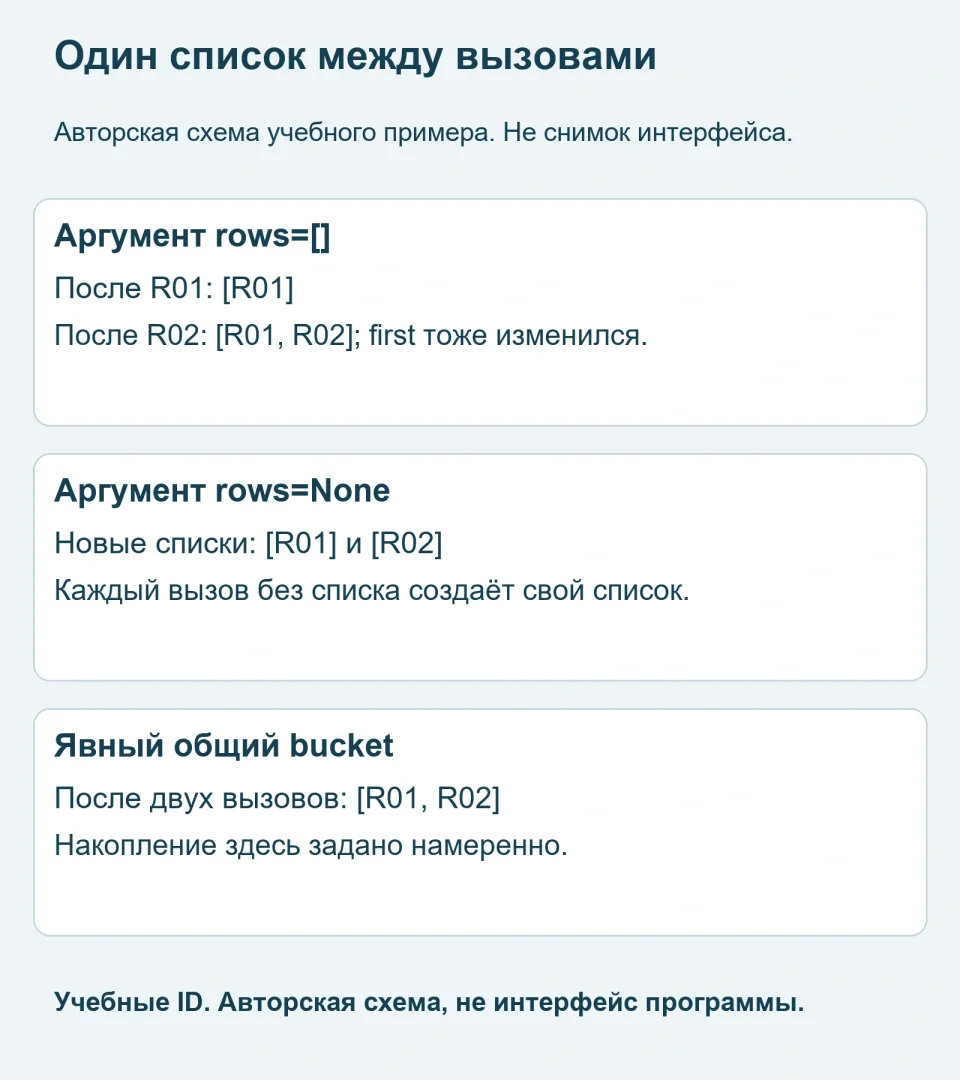
Функция собирает ID для одной порции данных, но во втором вызове неожиданно появляется ID из первой. Причина может быть не в файле и не в повторяющихся строках: изменяемый список, заданный аргументом по умолчанию, сохраняется между вызовами этой функции. Разберём, как это обнаружить и как отдельно в
 Наука
3
мин
29.10.2026
Математическая модель объяснила, как моллюски воспроизводят форму раковин
Инженеры из Калифорнийского технологического института Каушик Бхаттачарья и Хуан Лю описали математический закон, который связывает рост края раковины с формой всей конструкции. Статья вышла 23 октября 2026 года в Proceedings of the National Academy of Sciences. По сообщению Caltech, модель воспроиз
 Наука
5
мин
29.10.2026
Дым пожара Eaton содержал в 50 раз больше свинца, чем дым лесного пожара
Пожар Eaton прошёл по Лос-Анджелесу в январе 2025 года. Погибли 19 человек, больше 100 тысяч жителей эвакуировали, огонь уничтожил свыше 9 тысяч строений, а дым вдыхали миллионы. 28 октября 2026 года в Science Advances вышла статья (DOI: 10.1126/sciadv.aei4455), где этот дым сравнили с дымом пожара,
 Вузы
3
мин
29.10.2026
СКФУ и Хэйлунцзянский университет науки и технологий согласуют планы совместного института
Делегация Хэйлунцзянского университета науки и технологий во главе с ректором Мэн Шанзцю приехала в Северо-Кавказский федеральный университет 28 октября 2026 года. Пресс-служба СКФУ так описала задачу визита: согласовать учебные планы, методику преподавания и механизмы академической мобильности для