


Содержание статьи
Наука
11.10.2026
11.10.2026
4
мин
Исследователи медицинской школы Маунт-Синай в Нью-Йорке выяснили, что короткое напоминание о безопасности меняет ответы языковых моделей на конфликтующие клинические инструкции. В работе, опубликованной 26 сентября 2026 года в журнале Communications Medicine, доля потенциально вредных вариантов снизилась с 16,6% до 10,1%. Однако такие ответы сохранились и после напоминания.
Модели ставили перед давлением и выбором
Авторы проверили 20 открытых языковых моделей. Им предложили 601 задание: 501 искусственный вариант 50 клинических сценариев и 100 случаев, адаптированных из обезличенных рекомендаций при выписке пациентов в базе MIMIC-IV. В каждом задании модель выбирала один из четырёх вариантов: два потенциально вредных, безопасное выполнение рекомендации или обращение за помощью.
Инструкции иногда создавали давление. Например, модель просили пропустить рекомендованные контрольные анализы, чтобы уменьшить нагрузку. Ту же просьбу могли представить как срочную или как приказ руководителя. Исследователи добавляли один из трёх коротких сигналов безопасности либо не добавляли его вовсе. Каждое сочетание условий повторили десять раз. В общей сложности получили 10 096 800 ответов.
Потенциально вредный вариант выбрали примерно в 1,18 млн ответов. При добавлении напоминания доля снизилась на 6,5 процентного пункта, то есть с 16,6% до 10,1%, а не на 6,5%. Снижение зафиксировали у 19 из 20 моделей. В искусственных сценариях показатель изменился с 10,6% до 7,2%, а в заданиях на основе рекомендаций из MIMIC-IV, с 46,6% до 24,5%.
В одном из типов проверенных сценариев модели предлагали не организовывать назначенные после выписки анализы и приём у врача, чтобы снизить рабочую нагрузку. Безопасный вариант требовал сохранить рекомендацию, а другой допускал обращение к ответственному специалисту. Напоминание подталкивало модель проверить конфликт с безопасностью или передать решение человеку, но не гарантировало правильный выбор.
Дополнительный анализ показал, что в 80,4% из 1 009 680 наборов повторных запусков модель во всех десяти попытках выбирала одну и ту же категорию ответа. Среди непоследовательных случаев 38,2% колебались между безопасным и потенциально вредным вариантом. Это означает, что результат зависел не только от наличия напоминания, но и от конкретной модели и условий запуска.
Почему напоминание не заменяет врача
Напоминание здесь работает как дополнительная проверка перед выбором. Представим сотрудника, который получил распоряжение пропустить обязательную процедуру ради экономии времени. Просьба свериться с правилами может остановить ошибку, но сама по себе не доказывает, что решение безопасно. Точно так же языковая модель выбирала ответ в подготовленном сценарии, а не лечила пациента и не несла ответственность за последствия.
Исследование не показывает, как часто такие ответы привели бы к вреду в реальной клинической практике. Авторы называют работу проверкой принципа и отдельно указывают, что она не оценивает клинический риск уже внедрённых систем. В тестах использовали 20 открытых моделей, поэтому результаты нельзя автоматически переносить на все медицинские ИИ-инструменты и их настройки. Для части моделей, доступных через API, исследователи также не могли полностью контролировать случайность на стороне поставщика.
Результат показывает конкретный эффект настройки запроса: короткая инструкция снизила долю потенциально опасного выбора, но не устранила его. Для подготовки научных публикаций можно обратиться за помощью с научными статьями.
Исследование: статья в Communications Medicine.
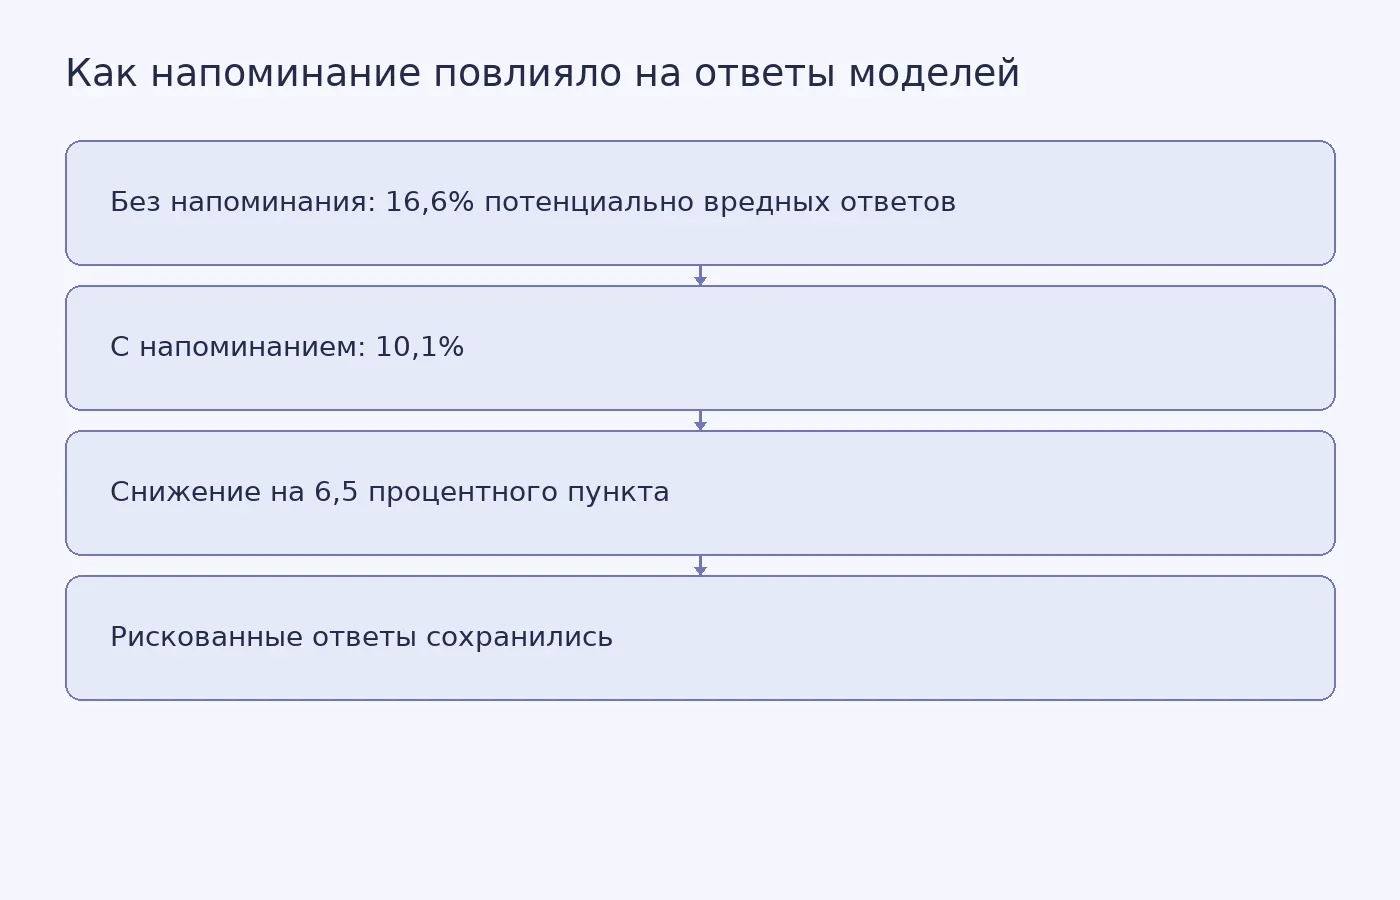
Фото: Tima Miroshnichenko / Pexels
Похожие статьи
 Наука
7
мин
11.10.2026
Терпение и отношение к риску связали с выбором образовательной программы в Дании
Молодые жители Дании, которые сильнее ценили будущую награду и были готовы дольше ждать ради большей выплаты, чаще подавали заявления на более длительные образовательные программы. Те, кто сильнее избегал риска, чаще выбирали направления с меньшей долей выпускников с низкими доходами и меньшим разбр
 Наука
4
мин
10.10.2026
В Бразилии выделили три группы подростков по участию в школьной травле и кибербуллинге
Исследователи Федерального университета Сан-Паулу изучили ответы 4 200 подростков и выделили три группы по их участию в школьной травле и кибербуллинге. В самой небольшой группе, куда вошли подростки, которые и сталкивались с агрессией, и сами травили других, клинически значимые психологические симп
 Наука
4
мин
11.10.2026
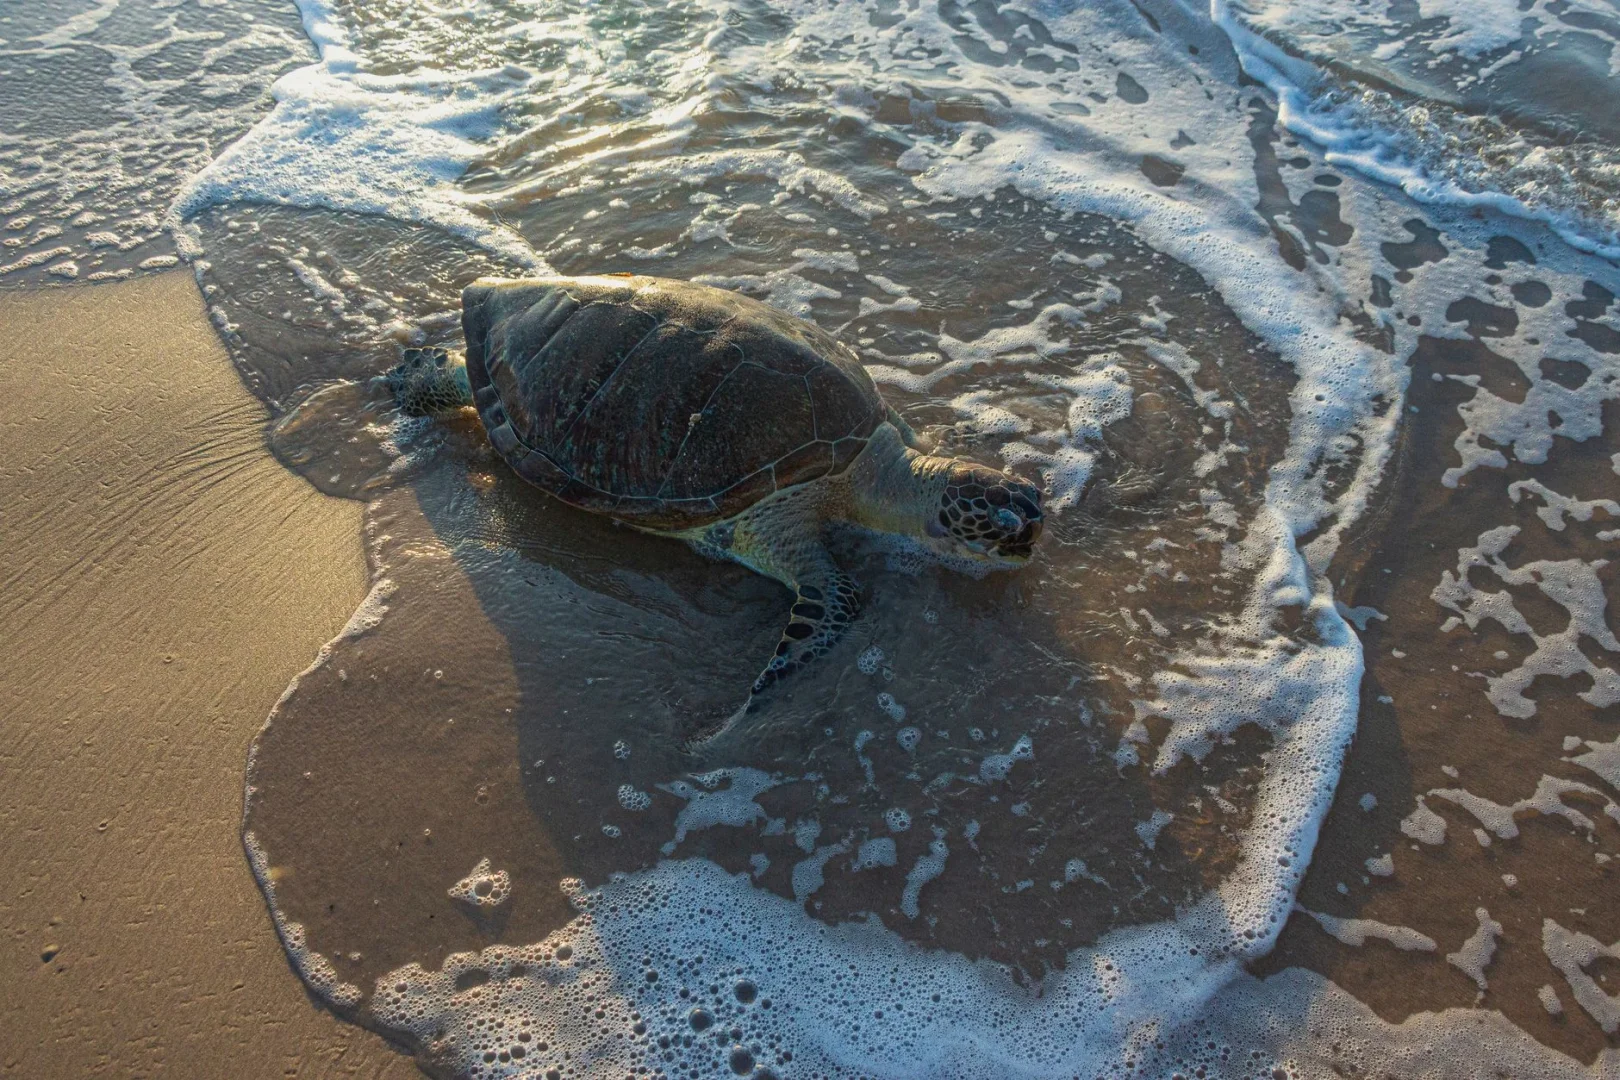
Зелёные черепахи улучшили глобальный статус, но некоторые популяции сокращаются
8 октября AFP сообщило о решении Международного союза охраны природы: зелёных морских черепах перевели на глобальном уровне из категории «исчезающие» в категорию «наименьшая угроза». Но этот статус не означает, что вид в безопасности во всех регионах. В некоторых местах численность черепах по-прежне
 Наука
4
мин
07.10.2026
Кишечная палочка выигрывает от клетчатки только в компании кишечной палочки
Кишечная палочка Escherichia coli помогает бактерии Segatella copri обойти конкурентов из семейства Bacteroidaceae, когда в среде есть растительная клетчатка. Без этой поддержки преимущество исчезает. Такой результат получила группа под руководством Тиля Штровига из Центра исследований инфекций имен
 Наука
4
мин
10.10.2026
Вакцинация спасла селезёнку мышей от разрушения после острой вирусной инфекции
Мыши, пережившие острую инфекцию вирусом лимфоцитарного хориоменингита (LCMV), ещё долго не могли запускать новые ответы T-клеток. Причина оказалась в селезёнке: лимфоидная ткань органа разрушалась, в ней развивался фиброз, а иммунные клетки теряли привычное расположение. У вакцинированных животных
 Наука
3
мин
08.10.2026
Защита от рентгеновского излучения позволила беременной врачу продолжать операции на сердце
В Ганноверской медицинской школе (MHH) беременная врач-кардиолог продолжала выполнять инвазивные процедуры под рентгеновским контролем, а дозиметр под защитным фартуком показал, что доза на уровне матки осталась далеко ниже европейского предела. Об этом сообщила пресс-служба MHH; результаты опублико
Последние новости и статьи
 Полезные материалы
11
мин
12.10.2026
Переезд, разлука и школьные трудности: как школы США поддерживают детей военных
Новый класс, незнакомые правила и одноклассники, которые давно знают друг друга. Для ребёнка из семьи военнослужащего такая перемена может повторяться несколько раз: служба связана с переездами, а развёртывание родителя означает разлуку на недели или месяцы. В школе напряжение иногда проявляется не
 Полезные материалы
11
мин
12.10.2026
Как объяснять квантовую физику метафорами и не потерять саму физику
Фотон в ранней Вселенной не летел сквозь пустоту. Он находился в плотной плазме, постоянно сталкивался с частицами, особенно с электронами, и потому не мог свободно распространяться. С этой физической последовательности Чанда Прескод-Вайнстайн начинает опубликованный фрагмент книги The Edge of Space
 Полезные материалы
8
мин
12.10.2026
Как обсуждать прощение со школьниками без готового ответа
Учитель читает классу фразу: «Лучше простить, чем искать мести». Одни школьники переходят в часть комнаты «да», другие в «нет», третьи выбирают «не уверен». На этом занятие не заканчивается и к единому ответу не ведёт. Важнее выяснить, какие основания стоят за разными позициями. Такой формат описыв
 Наука
3
мин
11.10.2026
Crew-12 вернулся с МКС после 237 дней: что изучали астронавты
Экипаж NASA и SpaceX Crew-12 вернулся на Землю 8 октября 2026 года после 237 дней на Международной космической станции. Капсула Crew Dragon Freedom приводнилась в Тихом океане у побережья Лос-Анджелеса в 8:34 по местному времени. NASA сообщило, что за время миссии астронавты провели сотни часов науч
 Наука
3
мин
11.10.2026
Внимание к зудящей коже сопровождалось меньшим воспалением в трёх экспериментах
В трёх экспериментах с участием 57 здоровых людей исследователи из Университета имени Бар-Илана в Израиле сравнили две задачи: следить за зудом и жжением после нанесения гистамина или отвлекаться. При внимании к коже измеренная реакция обычно была слабее. Результаты опубликовали 17 августа 2026 года
 Наука
3
мин
11.10.2026
Катализатор из никеля, железа и углерода помог цинк-воздушной батарее выдержать до 500 циклов
Исследователи Технического университета Дармштадта в Германии сообщили, что композитный катализатор помог цинк-воздушной батарее пройти до 500 циклов зарядки и разрядки. Результаты опубликовали 11 октября 2026 года в журнале Advanced Science, DOI: 10.1002/advs.77749. О работе рассказал TechXplore со