


Содержание статьи
Полезные материалы
20.10.2026
20.10.2026
9
мин
Пять задач, пять максимальных оценок. На первый взгляд агент справился безупречно. Но при разборе действий выяснилось: с эталоном совпали только 2 из 13 шагов. В другом прогоне заглушка, не вызвавшая ни одного инструмента, получила 34% награды.
Эти результаты описал автор Хабра под псевдонимом Lhody. Он проверял собственную экспериментальную систему ELM на задачах бронирования авиабилетов из tau2-bench. Это личный технический разбор, а не рецензированная статья и не независимая проверка бенчмарка. Поэтому его цифры нельзя превращать в доказательство того, что tau2-bench неисправен. Но они хорошо показывают методологическую проблему: итоговый балл и выполненные действия могут измерять разные вещи.
Что именно засчитывает награда
В описанном режиме код предлагает возможные действия, модель выбирает их, а цикл исполнения вызывает инструменты и хранит состояние базы бронирований. Метрика pass¹ показывает долю задач, за которые система получила награду 1 после одного запуска.
По словам автора, награда проверяет конечное состояние базы и условия общения. Сам путь к этому состоянию в показатель не входит. Если база изначально уже соответствует цели, задачу можно засчитать без изменений. В полном наборе таких задач было 24 из 50, а все пять задач первой пробы ELM не требовали записи в базу.
Отсюда и первый неожиданный результат. В первой пробе ELM получила pass¹ = 1,000: все пять задач были засчитаны. При этом с эталонными совпали только 2 из 13 действий. Автор формулирует проблему коротко: «Пять из пяти пришлось перечитать».
Эталонные действия автор считал отдельно, сопоставляя имя инструмента и его аргументы с действиями в трассе агента. Это полезная диагностика, но не универсальное определение правильности. В конкретной задаче может существовать другой корректный путь к цели.
Что показала заглушка без инструментов
Для проверки автор написал noop_agent. Заглушка начинала диалог, задавала уточняющий вопрос и продолжала его до остановки симуляции или предела ходов. Вызовов инструментов она не делала.
На 50 задачах noop_agent получила pass¹ = 0,340 при 0 из 142 ожидаемых действий. На отладочном наборе из 30 задач результат составил 0,400, хотя ожидаемых действий заглушка также не выполнила.
Это не означает автоматически, что проверка бенчмарка ошибочна. Из 24 задач, где не требовалось менять базу, заглушка прошла 17. Шесть раз диалог остановился из-за предела ходов, один раз система не прошла коммуникационную проверку. Некоторые задачи действительно могут допускать справочный ответ или корректный отказ без записи в базу.
Поэтому ненулевой pass¹ здесь означает только то, что система удовлетворила правилам конкретного судьи. Он не показывает, вызывал ли агент нужные инструменты и проходил ли ожидаемую последовательность действий.
ELM и контрольная заглушка
На 30 задачах отладочного набора ELM получила pass¹ = 0,333 и выполнила 23 из 84 ожидаемых действий. Заглушка набрала 0,400 и не выполнила ни одного. По одному только pass¹ заглушка выглядела лучше, хотя по числу действий она ничего не сделала.
Автор не считает это доказательством превосходства ELM или недостатка tau2-bench. В прогоне ELM было 460 вызовов, из которых 411 оказались повторами. Один вызов повторился 100 раз. Награда не отражала ни этих повторов, ни 713 ходов диалога.
Есть и техническая оговорка. Прогон ELM на 50 задачах был остановлен операционной системой после 41-й задачи. Поэтому его нельзя напрямую сравнивать с завершённым прогоном заглушки на всех 50 задачах.
Одна модель в двух циклах исполнения
Затем Lhody поместил одну и ту же модель DeepSeek в два разных цикла исполнения: референсный цикл tau2-bench и собственный, который автор называет харнессом. Пользовательская симуляция и три задачи были одинаковыми, менялся способ взаимодействия модели с инструментами.
В референсном цикле модель выполнила 5 из 5 действий за 22 хода. В первой пробе собственного цикла она не выполнила ни одного действия за 31 ход. Локальный пик потребления памяти при этом составил 11 592,2 МБ против 407,0 МБ в референсном цикле.
В ходе десяти проб автор обнаружил ошибки в собственном коде: повторные вызовы раздували ответы, разбор числового ответа с пояснением завершался исключением, а часть задач терялась. После исправлений потери задач удалось убрать, но длина диалога осталась большой. В лучшей поздней пробе агент выполнил 3 из 5 действий за 136 ходов, в последней тоже выполнил 3 из 5, но сделал 206 ходов.
При этом pass¹ в этих двух пробах различался: 1,000 в лучшей и 0,333 в последней. Это не противоречащие друг другу измерения, а результаты разных запусков. Они показывают, что число совпавших действий и итоговая награда могут расходиться даже на одном наборе задач.
Три задачи слишком малочисленны для оценки общего качества модели или собственного цикла исполнения. Сам автор использовал сравнение прежде всего для поиска ошибок в харнессе, а не для доказательства превосходства одного решателя.
Что можно заключить из этого разбора
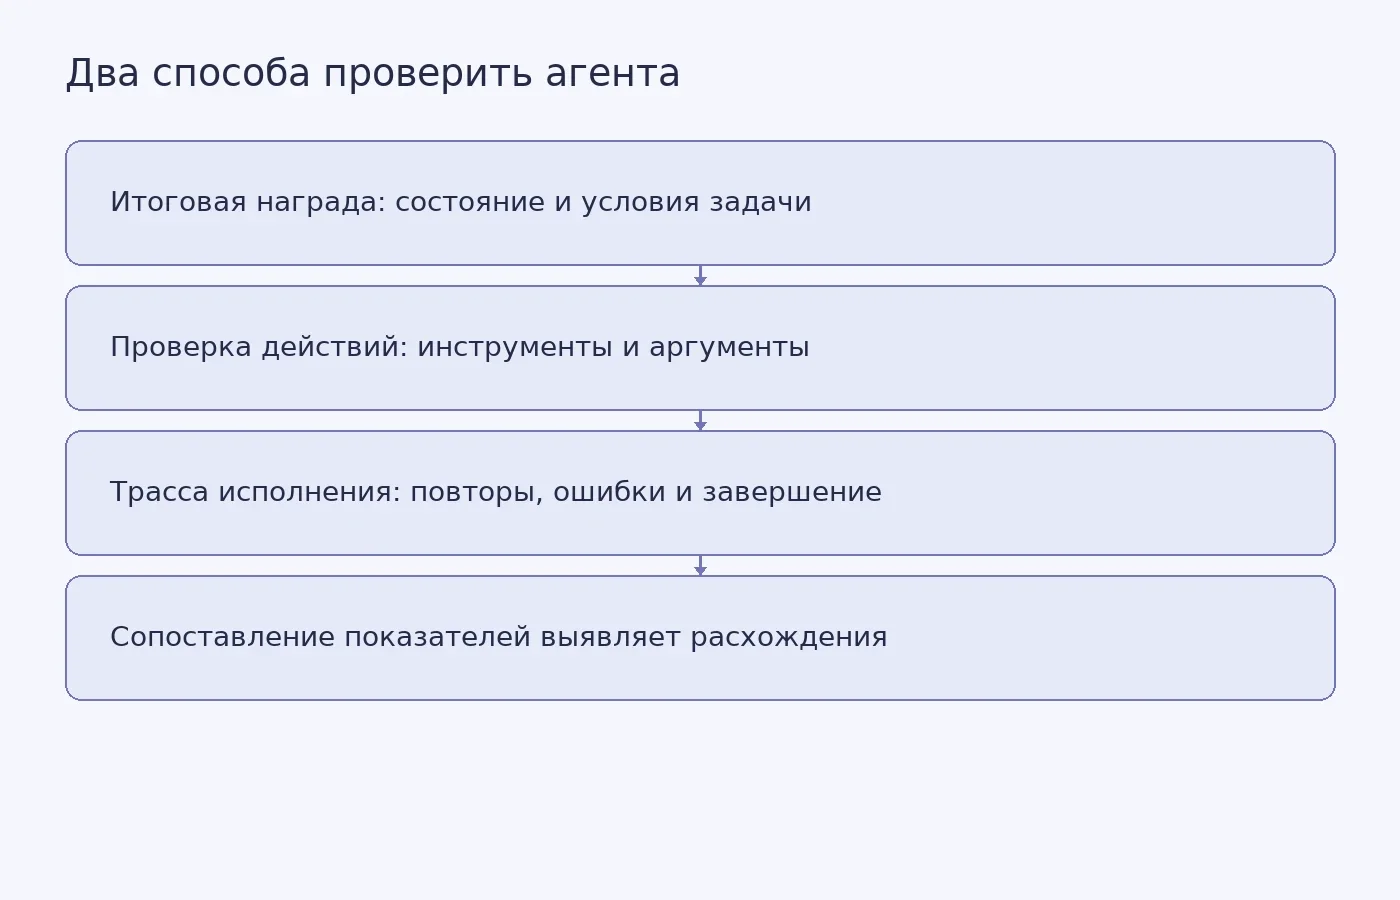
Вывод автора практический: если важно знать не только конечное состояние, но и способ его достижения, одной награды недостаточно. Рядом с pass¹ нужно смотреть трассу диалога, вызовы инструментов, аргументы, повторы, отказы, ошибки исполнения и завершение каждой задачи.
Наша интерпретация чуть осторожнее. Счёт совпадений с эталоном полезен как диагностический слой, но сам не должен становиться единственной заменой награде. Эталонная последовательность может быть одной из нескольких допустимых. Для каждой задачи нужно отдельно определить цель, обязательные ограничения и допустимые альтернативные пути.
Именно поэтому полезно сопоставить этот случай с разбором того, что именно измеряют бенчмарки ИИ. Высокий показатель имеет смысл только в пределах тех свойств, которые действительно попали в процедуру проверки.
Почему результат пока нельзя обобщать
У описания есть существенные ограничения. Работа Lhody опубликована на Хабре 19 октября 2026 года как личная техническая статья. Это не рецензированное исследование. Указанный автором репозиторий с кодом на момент подготовки материала был недоступен, поэтому нельзя независимо проверить счётчики, реализацию метрик и условия запусков.
Часть задач уже использовали при отладке, поэтому независимого нетронутого теста не осталось. Сравнение двух циклов основано всего на трёх задачах. Кроме того, автор не установил полную стоимость систем в одинаковых условиях: локальное потребление памяти измерялось для его машины, ресурсы удалённого судьи неизвестны, а счётчики токенов референсного цикла не охватывали все расходы.
Наконец, в разборе не проверено, насколько совпадение с эталонной последовательностью подходит для задач с несколькими корректными решениями. Это ограничивает саму диагностическую метрику, но не отменяет её пользу при поиске повторов, пропущенных действий и ошибок цикла.
Пока высокий балл расходится с выполненными действиями, он говорит лишь о том, что система прошла конкретную проверку. Чтобы понять, справился ли агент с задачей, нужно увидеть не только итоговое состояние, но и путь, которым он к нему пришёл.
Источник: Lhody, «Мой агент получил высокий балл. Проверяю, что он сделал», Хабр. Автор сообщает о личных прогонах ELM и DeepSeek на задачах airline из tau2-bench; связанный репозиторий на момент подготовки материала недоступен.


Похожие статьи
 Полезные материалы
13
мин
03.10.2026
Когда узкий список инструментов помогает ИИ-агенту выбирать точнее
Пользователь просит ИИ-агента определить, какие устройства сейчас находятся в корпоративной сети. Роутер не находит подходящего раздела и не передаёт модели ни одного инструмента. Агент не сообщает об ограничении, а пишет: «Выполняю сканирование сети…» Затем он описывает работу, которой в действител
 Полезные материалы
10
мин
02.10.2026
Почему высокая точность ИИ-модели на случайном разбиении не гарантирует находку новых аптамеров
В октябре 2026 года Центр искусственного интеллекта в химии ИТМО сообщил о выпуске AptaBench — набора данных и протокола проверки для моделей, предсказывающих связывание аптамеров с малыми молекулами. Пресс-релиз приводит конкретные числа: ROC-AUC падает с 0,95 при стандартной проверке до 0,89 на но
 Полезные материалы
16
мин
13.10.2026
Поведенческий тренинг при СДВГ и аутизме: что действительно показали рандомизированные испытания
Одна и та же рекомендация может означать разные вещи. В кабинете родителям предлагают коротко сформулировать просьбу, заметить подходящее поведение и потренировать новый навык. Дома под «поведенческим методом» иногда понимают таблицу наград, наказания и требование подчиняться любой ценой. Автоматиче
 Полезные материалы
18
мин
01.10.2026
Что на самом деле измеряют бенчмарки ИИ: конвергентная и дискриминантная валидность против посторонних навыков
Вопрос о том, измеряет ли бенчмарк предвзятость и безопасность модели или посторонний навык вроде понимания текста, в 2026 году перестал быть риторическим. Две работы переносят в оценку ИИ аппарат психометрики — науки об измерении человеческих способностей, — и показывают, что часть популярных тесто
 Полезные материалы
9
мин
18.10.2026
Почему ELM хорошо отказывается от лишнего инструмента, но хуже собирает вызов
Представим обычный запрос цифровому помощнику: «Какая завтра погода в Казани?» Если у помощника подключён прогноз погоды, он должен выбрать этот инструмент и передать ему название города. А если ни один инструмент не подходит, правильный ответ не вызов наугад, а отказ. В тесте BFCL эти способности д
 Полезные материалы
10
мин
26.02.2026
1
Студенческий цифровой арсенал: от облачных хранилищ до планировщиков задач
Чтобы студенту было комфортно планировать собственное время для успешного обучения в вузе, предлагаем ознакомиться с пользой облачных хранилищ и планировщиков задач, а также топовыми инструментами из этих категорий Облачные хранилища: польза, популярные ресурсы Основные преимущества облачных х
Последние новости и статьи
 Полезные материалы
5
мин
21.10.2026
Как сделать рабочие встречи доступнее для нейроотличных сотрудников
Совещание начинается без повестки, темы быстро сменяют друг друга, а участники не знают, когда их попросят высказаться. Один человек теряет нить разговора, другому мешают уведомления или яркий свет. Это условный пример, но составляющие его ситуации перечислены в практических рекомендациях Джейми Уай
 Полезные материалы
8
мин
21.10.2026
Пролапс после беременности: какие симптомы важны и как выбирают помощь
После долгого дня может появиться тяжесть в тазу или чувство, будто во влагалище что-то давит вниз. Такое бывает при пролапсе тазовых органов, но одной этой жалобы недостаточно для диагноза. И наоборот: при осмотре смещение органов иногда обнаруживают у женщин, которых ничего не беспокоит. Пролапс в
 Полезные материалы
7
мин
21.10.2026
Живой архив в кишечной палочке: что выдержали 100 поколений
Файл с рассказом Эрнеста Хемингуэя «Очень короткий рассказ» занимал 3288 байт. Исследователи закодировали его в 41 последовательность ДНК, собрали их в плазмиду и внесли в бактерию Escherichia coli. После выращивания бактерий до 100 поколений учёные прочитали последовательности плазмиды. В этих усло
 Наука
3
мин
20.10.2026
Модель оценила пользу скрининга рака печени при риске от 0,45%
Исследователи Mass General Brigham рассчитали, что скрининг рака печени может быть полезен людям с циррозом, связанным с алкоголем, уже при годовом риске заболевания от 0,45%. В сообщении об исследовании ориентиром для обследования назван риск выше 1%. Результаты опубликовали в журнале Clinical Gast
 Наука
3
мин
20.10.2026
Фокусированный ультразвук снизил оценку бреда в пилотном исследовании с 10 участниками
В исследовании, опубликованном 20 октября 2026 года в журнале npj Acoustics, участвовали десять амбулаторных пациентов с шизофренией или шизоаффективным расстройством. После сеанса фокусированного ультразвука их оценка выраженности бреда снизилась. Исследователи из США сравнили активную стимуляцию с
 Вузы
2
мин
20.10.2026
В Алматы проверили три вуза после сообщений о минировании
20 октября 2026 года экстренные службы обследовали три университета в разных районах Алматы после сообщений о возможном минировании. Опасных предметов не нашли, информацию об угрозе полиция не подтвердила, сообщает Informburo.kz.Что проверили службыПосле сообщений о возможном минировании экстренные