


Содержание статьи
Полезные материалы
18.10.2026
18.10.2026
9
мин
Представим обычный запрос цифровому помощнику: «Какая завтра погода в Казани?» Если у помощника подключён прогноз погоды, он должен выбрать этот инструмент и передать ему название города. А если ни один инструмент не подходит, правильный ответ не вызов наугад, а отказ.
В тесте BFCL эти способности дали противоположные результаты у двух систем. В описанном автором прогоне ELM заметно уступила Bonsai-2-27B при составлении вызовов, но лучше справилась с заданиями, где ни один инструмент не подходил. Контраст заслуживает внимания, однако он не доказывает, что ELM в целом лучше отказывает или готова к использованию в реальных агентах.
Что именно сравнивали
В публикации на Хабре автор под псевдонимом Lhody описывает собственную экспериментальную систему ELM. Надёжно установить дату публикации по доступному тексту не удалось. Это не рецензированная научная статья: автор сообщает, что препринт ещё не опубликован, а репозиторий с кодом и метаданными закрыт. При проверке ссылка на него возвращала ошибку 404.
В описанном варианте ELM код сначала готовит варианты значений аргументов. Модель выбирает функцию и подходящие значения, затем код собирает вызов. Среди вариантов ответа есть и «ни одна функция не подходит». В контрольной системе Bonsai-2-27B сама формирует вызов с помощью штатного обработчика.
Это различие важно для понимания результатов. ELM выбирает из уже подготовленных значений, а не формирует ответ целиком. Если нужного значения нет среди кандидатов, модель не сможет его добавить. Автор объясняет это на примере даты: выбрать инструмент для прогноза погоды и создать дату в нужном для него формате — разные задачи. Поэтому сравнение касается не только двух моделей, но и двух способов построения вызова.
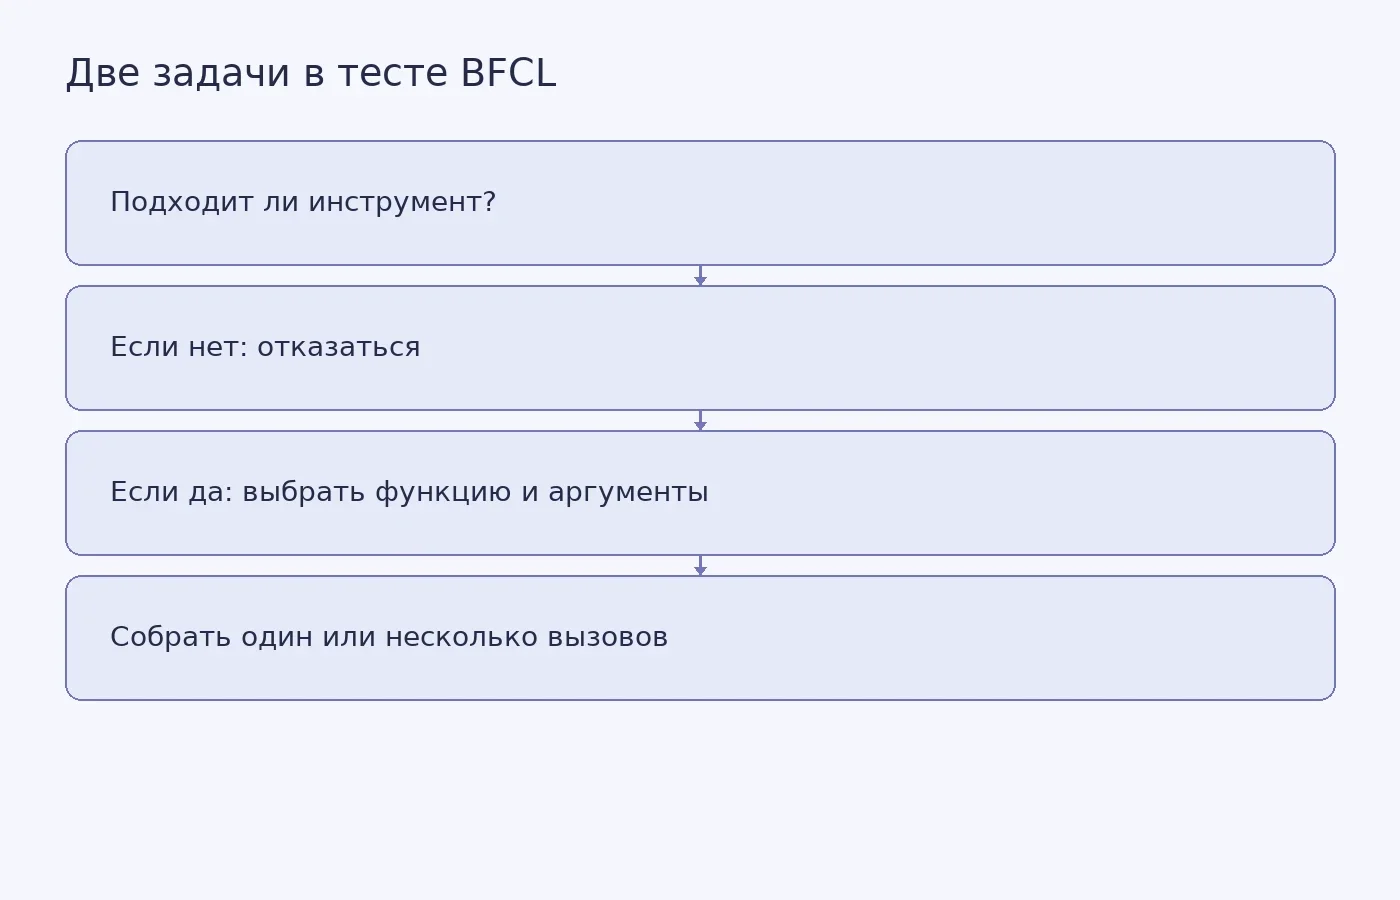
Для полного прогона автор подключил ELM к официальному средству оценки bfcl-eval версии 2026.3.23 и использовал BFCL v4. Он проверил пять однотуровых категорий на Python: simple_python, multiple, parallel, parallel_multiple и irrelevance. В них было соответственно 400, 200, 200, 200 и 240 заданий, всего 1240. Первые четыре категории требуют выбрать функцию и составить один или несколько вызовов. В irrelevance проверяется, распознаёт ли система ситуацию, когда ни один инструмент не подходит.
Каждая система прошла весь набор один раз. Компьютер, программа запуска, набор данных и проверяющая программа были одинаковыми, но повторных прогонов не проводили. Значит, сравниваются результаты одного запуска, а не стабильность систем от запуска к запуску.
Средняя точность скрывает противоположные результаты
В четырёх категориях, где нужно составлять вызовы, ELM набрала 53,0% в simple_python, 56,0% в multiple, 36,0% в parallel и 7,0% в parallel_multiple. Результаты Bonsai в тех же категориях составили 89,5%, 89,5%, 89,0% и 80,5%. Особенно велик разрыв в заданиях, где нужно подготовить несколько вызовов разных функций.
В irrelevance соотношение обратное: автор сообщает о 88,3% у ELM и 15,4% у Bonsai. В числе заданий это 212 правильных ответов из 240 у ELM и 37 из 240 у Bonsai. Общая точность по всем пяти категориям составила 50,2% у ELM и 73,6% у Bonsai: 622 и 913 верных ответов из 1240 соответственно.
Разница согласуется с устройством тестируемых систем. ELM отдельно решает, подходит ли функция, и может выбрать отказ. Но для успешной сборки сложного вызова нужно ещё подготовить аргументы. В параллельных категориях система должна также определить число вызовов и распределить между ними функции и значения. Ограниченный список кандидатов может упростить выбор, но становится помехой, если нужного значения в нём нет.
Это возможное объяснение результатов, а не установленная причина. В эксперименте не меняли по одному компоненту, чтобы отдельно измерить вклад генерации кандидатов, способа выбора или обучения моделей. Поэтому нельзя заключить, что именно устройство ELM обеспечило ей преимущество в заданиях на отказ или вызвало отставание при составлении вызовов.
Что проверка говорит, а чего не говорит
Автор сопоставил собственный способ подсчёта результатов с официальным скорером в трёх категориях. В simple_python официальная оценка ELM составила 53,0%, а собственная 53,5%; в multiple результаты были 56,0% и 55,5%. В irrelevance оба способа дали 88,3%. Это полезная проверка части подсчётов, но она не заменяет независимого повторения эксперимента: код, метаданные и ответы систем недоступны для внешней проверки.
Результаты также нельзя автоматически переносить на другие условия. Автор не запускал задания на Java и JavaScript или многоходовые сценарии, где нужно сохранять состояние и учитывать предыдущие действия. Проверка 2251 задания из категорий live оценивала, можно ли представить запросы в формате, который поддерживает ELM. Точность ответов на этих заданиях она не измеряла. Чтобы оценить ошибочные отказы, нужна, в частности, категория live_relevance: в ней инструмент может быть уместен, а отказ становится ошибкой.
Успех в irrelevance проверяет только одну сторону решения: умеет ли система не вызывать явно неподходящий инструмент в этих заданиях. Он не показывает, как часто агент откажется, когда инструмент нужен, и к каким последствиям это приведёт в работе. Практическая оценка должна учитывать и уместные вызовы, и уместные отказы.
Один прогон не показывает, насколько результаты меняются между запусками и чувствительны ли они к случайности. Поэтому автор не считает небольшие различия надёжными. Крупные разрывы в некоторых категориях дают основание исследовать их дальше, но сами по себе не доказывают, что результат повторится на других данных и при других настройках.
Сходный вопрос возникает и в других тестах языковых моделей: высокая точность на одном разбиении ещё не гарантирует работу на новых условиях. В статье о том, когда узкий список инструментов помогает ИИ-агенту выбирать точнее этот вопрос рассматривается на другом экспериментальном материале.
Для рабочего агента этого прогона недостаточно
В публикации приведены также оценки времени, стоимости и памяти, но их нельзя считать прямым рейтингом эффективности. Среднее время на одну запись указано как 1,15 секунды для ELM и 2,98 секунды для Bonsai. Стоимость тысячи заданий оценена в 0,0716 и 0,5051 доллара соответственно. Однако расчёты сделаны разными способами: для ELM использованы измеренное число токенов и указанная ставка, а для локальной Bonsai взят исторический прайс. Это не фактические платежи, и по этим оценкам нельзя судить о нынешних тарифах.
Оценки памяти тоже нельзя напрямую сопоставлять. Для ELM приведена нижняя оценка по памяти дочерних процессов, не менее 307,9 МБ, а для Bonsai указан размер весов: 10 695 МБ. Автору неизвестны расходы памяти и вычислений на удалённого судью ELM. Эти числа не показывают полное потребление ресурсов обеими системами.
Полный прогон 1240 заданий показывает профиль ELM в пяти однотуровых категориях BFCL v4: система намного слабее Bonsai при составлении вызовов и заметно сильнее в проверенной категории отказов. Но один запуск не устанавливает причину различий, не говорит об их устойчивости и не подтверждает, что результат сохранится на живых запросах, в других языках или в многоходовой работе. Для рабочего агента этот прогон скорее подсказывает, что проверять дальше, чем помогает выбрать систему.
Источники
- Lhody. «Проверяю выбор функций и значения аргументов в ELM». Публикация на Хабре, полный текст: habr.com/ru/articles/1095504. Личный эксперимент; доступный текст не указывает надёжную дату публикации. Препринт, по словам автора, ещё не опубликован; репозиторий заявлен как приватный.


Похожие статьи
 Полезные материалы
16
мин
04.10.2026
Как выбрать сигнал для вызова дежурного, а не просто настроить пороги
Диск заполнен на 51%, и мониторинг будит дежурного. Но свободного места хватит еще на месяц. В другом сервисе мониторинг собирает тысячи инфраструктурных метрик, но не замечает, что пользователи перестали оплачивать заказы.С этого несовпадения технического состояния и пользовательского результата на
 Полезные материалы
18
мин
01.10.2026
Что на самом деле измеряют бенчмарки ИИ: конвергентная и дискриминантная валидность против посторонних навыков
Вопрос о том, измеряет ли бенчмарк предвзятость и безопасность модели или посторонний навык вроде понимания текста, в 2026 году перестал быть риторическим. Две работы переносят в оценку ИИ аппарат психометрики — науки об измерении человеческих способностей, — и показывают, что часть популярных тесто
 Полезные материалы
13
мин
03.10.2026
Когда узкий список инструментов помогает ИИ-агенту выбирать точнее
Пользователь просит ИИ-агента определить, какие устройства сейчас находятся в корпоративной сети. Роутер не находит подходящего раздела и не передаёт модели ни одного инструмента. Агент не сообщает об ограничении, а пишет: «Выполняю сканирование сети…» Затем он описывает работу, которой в действител
 Полезные материалы
15
мин
03.10.2026
Почему подбор кодов помещений упирается в разногласия проектов, а не в метрику сходства строк
В жилом доме сотни помещений, и в модели они называются так, как привыкла мастерская: «С/у», «Кладовка», «ПУИ/Мусороудаление (К1)», «Элетрощитовая жилой части». С 2026 года архитектурно-градостроительное решение в Москве сдаётся вместе с цифровой информационной моделью в IFC, и у каждого помещения д
 Полезные материалы
7
мин
14.10.2026
Подростки пользуются ИИ, но не спешат отдавать ему авторство
Подросток может попросить чат-бота помочь с программой, а затем решить, что код быстрее написать самому. Противоречия здесь нет: попросить помощи с отдельной операцией и передать инструменту всю задачу, включая замысел и оценку результата, не одно и то же. Опрос Pew Research Center и интервью, опубл
 Полезные материалы
13
мин
26.02.2026
0
Топ-10 ИИ для написания научных работ
Нейросети на базе ИИ помогут сэкономить время на выполнении научных работ по любому направлению исследования. Таким инструментам можно делегировать разные задачи: от написания структуры и подбора литературных источников до оформления работы по требованиям ГОСТ. Предлагаем ознакомиться с преимущес
Последние новости и статьи
 Полезные материалы
7
мин
18.10.2026
Как конденсатор заменяет резистор: вскрываем фильтр Harris HF-10
На кристалле старого фильтра Harris HF-10 видна сетка из 72 одинаковых квадратных конденсаторов. Зачем аналоговой микросхеме столько маленьких ёмкостей, если ток обычно задают резисторы? На кристалле резисторы занимают много места, а их параметры трудно точно контролировать. В MF10 и совместимом с н
 Полезные материалы
8
мин
18.10.2026
Распознавание русской речи на CPU: что решил один бенчмарк и чего он не доказывает
Шесть виртуальных процессоров в тарифе хостинга звучат как хороший запас. Но в тесте русскоязычного распознавания этого ресурса хватило лишь на четыре-пять аудиодорожек. Результат зависел и от способа распараллеливания модели. На другом сервере тот же чанк обрабатывался в несколько раз быстрее. Этот
 Полезные материалы
12
мин
18.10.2026
Фукоидан из бурых водорослей: что исследования говорят о защите тканей
В новостном пересказе фукоидан уже почти готов стать медицинским материалом: вещество из бурых водорослей будто бы защищает печень, почки, кишечник и кожу, а затем может попасть даже в повязки для заживления ран. Между такой перспективой и доказанным лечением, однако, есть несколько промежуточных ст
 Наука
4
мин
17.10.2026
Почему авиационные планы не укладываются в экологические пределы
Исследователи во главе с Бастьеном Паи проверили, укладываются ли планы по сокращению выбросов мировой гражданской авиации в планетарные границы. В статье, опубликованной 13 октября 2026 года в журнале Nature Communications, они сравнили сценарии развития отрасли до 2050 года. Ни один из них не собл
 Наука
3
мин
17.10.2026
Роборука EmArm чувствует прикосновения по всей длине и меняет маршрут
Исследователи Гонконгского университета науки и технологий представили роборуку EmArm с мягкой тактильной кожей на верхней и нижней частях руки. В статье, опубликованной в журнале Nature Sensors 20 июля 2026 года, они описали, как робот определяет место и силу прикосновения, выдерживает нагрузку и м
 Наука
2
мин
17.10.2026
Как стрессовый сигнал от бурого жира может вызвать обострение артрита
Исследователи Университета Тиба и двух японских больниц изучили, как стресс может сопровождаться возвращением воспаления суставов. Результаты опубликовали 16 октября 2026 года в журнале Science Advances. Механизм проверяли на мышах, а у людей с ревматоидным артритом исследовали связь воспринимаемого