


Содержание статьи
Оформление и требования к диссертации
27.10.2026
27.10.2026
6
мин
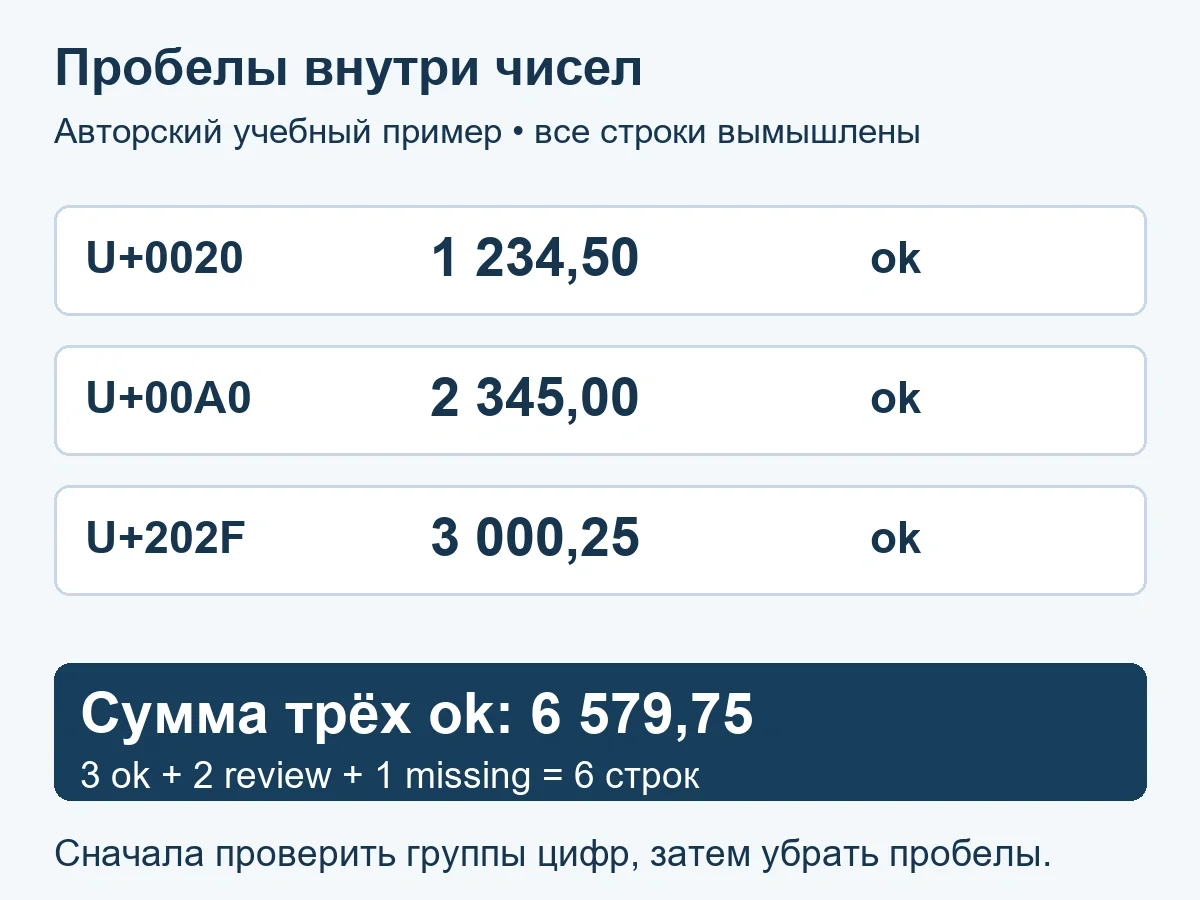
Вы открываете файл, чтобы посчитать итог, и видите значения «1 234,50», «2 345,00» и «3 000,25». Внутри стоят разные символы пробела. Если без проверки удалить из строки все разрешённые пробелы, можно скрыть ошибочную группировку. Поэтому сначала проверяют исходную строку по выбранной грамматике, сохраняют её и затем удаляют только разрешённый разделитель.
Дальше я приведу шесть вымышленных строк R01–R06 из одного числового поля, выраженных в условных единицах. Никаких реальных измерений или денег тут нет. Для упражнения я заранее выбрал правило: неотрицательное число, запятая перед ровно двумя десятичными цифрами, до девяти цифр целой части. Группы тысяч, если они есть, состоят из трёх цифр, а разделитель внутри одной строки одинаков. Знаки, экспоненты, единицы измерения и пробелы по краям в эту грамматику не попадают.
Какие символы выглядят как пробел
Обозначение | Символ в нашем наборе |
|---|---|
U+0020 | Обычный пробел, в Unicode он называется SPACE; встречается в строке R01. |
U+00A0 | Неразрывный пробел, NO-BREAK SPACE; R02. |
U+202F | Узкий неразрывный пробел, NARROW NO-BREAK SPACE; R03. |
Функция unicodedata.name возвращает назначенное имя символа; если имени нет, без аргумента default она возбуждает ValueError. В нашем наборе все три пробела имеют имена. По внешнему виду текста нельзя надёжно установить его код. В коде ниже буквальная запись \u00a0 задаёт U+00A0, а \u202f — U+202F. При выполнении каждая такая последовательность задаёт один символ строки.
Сначала проверка записи, потом удаление разделителей
Если сразу удалить все пробелы из «1 23,45», получится 123,45. На вид — нормальное число. Но исходная группа содержала две цифры вместо трёх, и операция это скрыла. Поэтому порядок действий другой: сначала проверяем, соответствует ли строка выбранной грамматике, и только потом удаляем разрешённые разделители.
ID и исходная строка | Результат по выбранному правилу |
|---|---|
R01: 1[U+0020]234,50 | 1234.50; ok |
R02: 2[U+00A0]345,00 | 2345.00; ok |
R03: 3[U+202F]000,25 | 3000.25; ok |
R04: 12,3,4 | None; review: две запятые. |
R05: 1[U+0020]23,45 | None; review: неверная длина группы. |
R06: пустая строка | None; missing: значение не задано. |
Обозначения в квадратных скобках помогают увидеть невидимые символы; в сами строки кода они не входят. None означает, что число не разобрано. Статусы review и missing мы храним отдельно: непонятная запись — это не отсутствующее значение, и ни то, ни другое не превращается в ноль.
Полный исполняемый пример Python
В документации re fullmatch проверяет соответствие всей строки. Decimal создаётся из подготовленного текста по документации decimal, без промежуточного float. Это небольшой разбор указанной грамматики, а не универсальный распознаватель всех форматов чисел.
from decimal import Decimal, localcontext
import re
raw = ["1 234,50", "2\u00a0345,00", "3\u202f000,25",
       "12,3,4", "1 23,45", ""]
pattern = re.compile(
    r"(?:[0-9]{1,9}|[0-9]{1,3}(?P<sep>[ \u00a0\u202f])"
    r"[0-9]{3}(?:(?P=sep)[0-9]{3})?),[0-9]{2}"
)
def parse_number(text):
    if text == "":
        return None, "missing"
    if pattern.fullmatch(text) is None:
        return None, "review"
    clean = text.translate({32: None, 160: None, 8239: None})
    return Decimal(clean.replace(",", ".")), "ok"

parsed = [parse_number(text) for text in raw]
for n, (value, status) in enumerate(parsed, 1):
    print(f"R{n:02d}: {value}; {status}")
with localcontext() as ctx:
    ctx.prec = 28
    total = sum((v for v, s in parsed if s == "ok"), Decimal("0"))
print("sum_ok =", total)
assert total == Decimal("6579.75")
assert [s for v, s in parsed] == ["ok", "ok", "ok", "review", "review", "missing"]
Вывод для шести строк:
R01: 1234.50; ok
R02: 2345.00; ok
R03: 3000.25; ok
R04: None; review
R05: None; review
R06: None; missing
sum_ok = 6579.75
Сверьте сумму и количество строк
Три распознанных значения дают 1234,50 + 2345,00 + 3000,25 = 6579,75 условной единицы. Это сумма только трёх корректно разобранных строк, а не всех шести исходных записей. По R04 и R05 нужно уточнение; R06 не содержит числа. Контроль статусов: 3 ok + 2 review + 1 missing = 6 строк.
Исходные строки оставляйте в поле raw, число — в value, а причину решения — в status. Проверка длины группы не доказывает, что само измерение верно: даже корректно записанное число может требовать содержательной проверки. Показанный код рассчитан только на заданные ограничения и строки; поддержку других типов, знаков и форматов нужно проектировать отдельно.
Что проверить в своём файле
- Какой знак считается десятичным и какие разделители групп допускает документация источника.
- Не являются ли значения идентификаторами, где пробел и ведущие нули могут иметь смысл.
- Сохранены ли исходные символы и все шесть записей.
- Не исправлены ли неизвестные разделители, буквы или единицы угадыванием.
- Указано ли, что сумма 6579,75 относится только к трём ok-строкам.
Эта проверка выполняется уже над текстом одного поля. Настройки чтения файла и сохранение ведущих нулей разобраны отдельно в материале об импорте CSV с десятичной запятой. Изменение разделителя полей CSV само по себе не проверяет внутренние группы тысяч в каждой ячейке.
Если для собственного исследовательского набора нужна помощь с правилами подготовки и проверкой расчёта, можно обсудить подготовку и проверку статистического анализа. Заранее согласуйте вопрос, состав исходных файлов и объём помощи. Автоматическое преобразование строк само по себе не подтверждает достоверность данных.


Похожие статьи
Последние новости и статьи
 Оформление работ
6
мин
27.10.2026
Перекрывающиеся интервалы наблюдений: как не задвоить длительность
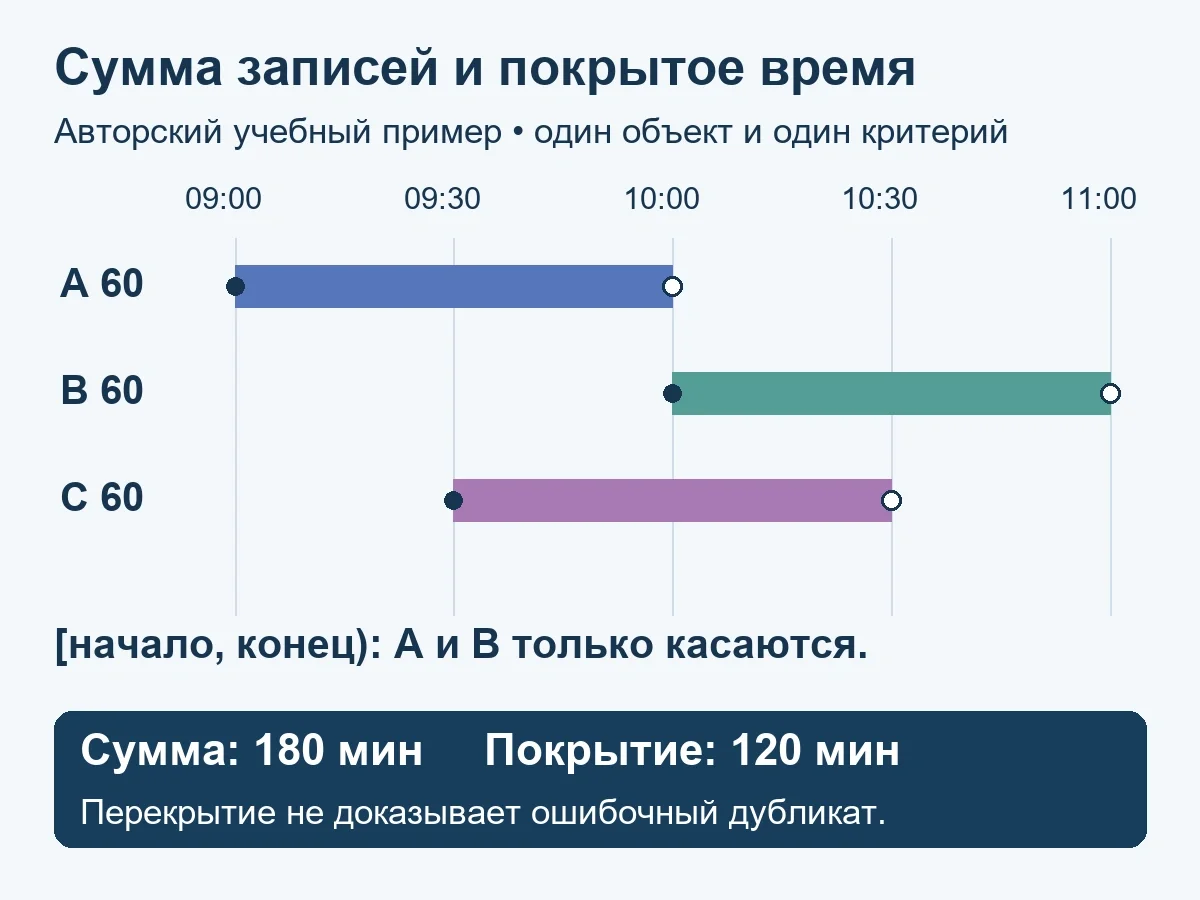
Представьте журнал, в котором три записи, каждая по часу. В сумме — 180 минут. Но на временной шкале они умещаются всего в два часа. Ошибка возникает, когда сумму длительностей строк выдают за время, в течение которого велось хотя бы одно наблюдение. Это разные показатели, и прежде всего нужно опред
 Магистерские диссертации
7
мин
27.10.2026
Одинаковые на вид ID: как проверить латинскую A и кириллическую А
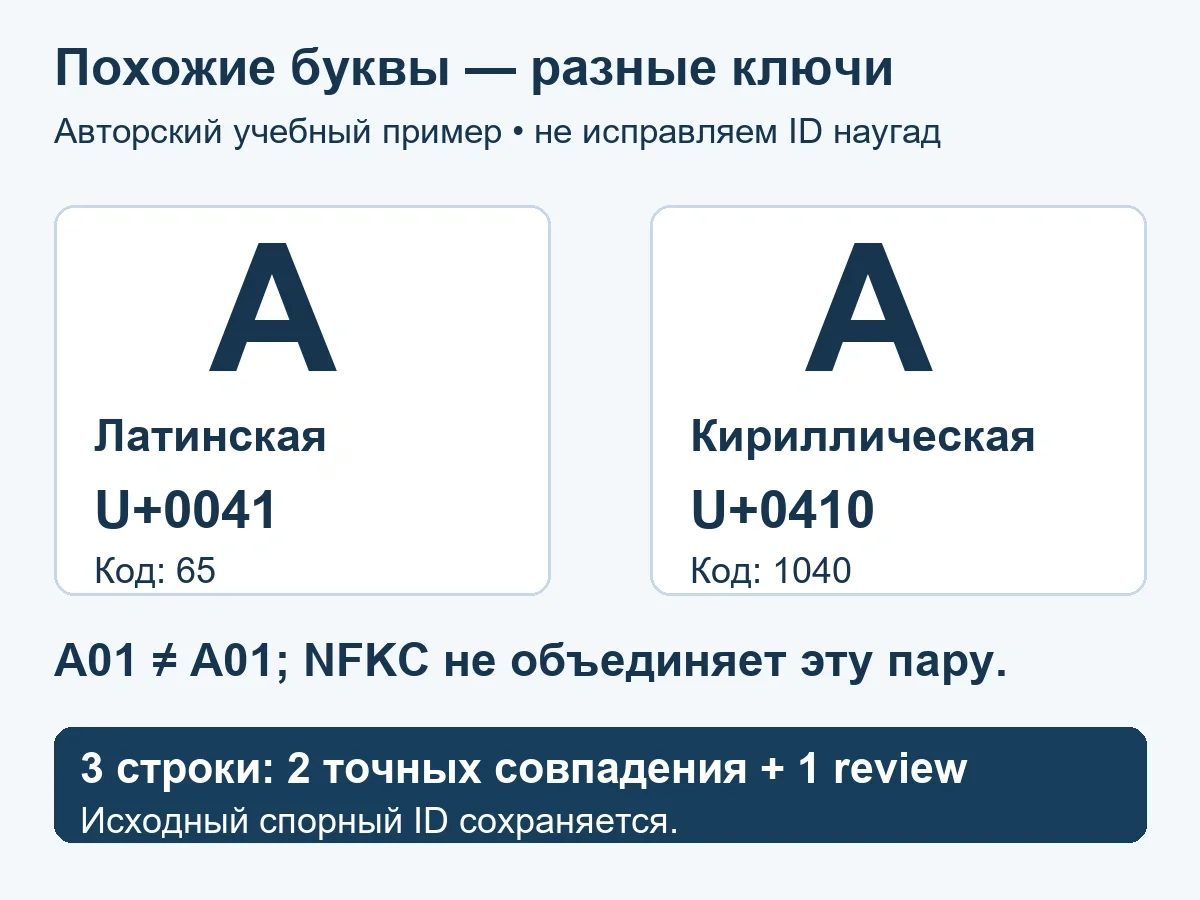
У вас есть справочник с ключами A01 и A02. На вход подано три строки, и одна из них не присоединяется к справочнику, хотя на экране выглядит такой же. Причина прячется на уровне символов: латинская A и кириллическая А записаны разными кодами. Визуальное сходство не делает строки равными и не доказыв
 Наука
3
мин
27.10.2026
Шумомер вместо судей: 30 октября в ТвГУ пройдёт «Научная битва»
Четверо учёных выйдут к публике в Твери вечером 30 октября 2026 года, но привычных лекций не будет. Каждый получит ровно десять минут, чтобы рассказать о своём исследовании так, как рассказывают захватывающую историю. Победителя назовут не судьи, а шумомер — организаторы из Тверского государственног
 Помощь по написанию
16
мин
27.10.2026
21432
Как написать литературный обзор для диссертации?
Литературный обзор для диссертации должен объяснять, что известно по исследовательскому вопросу, как соотносятся результаты разных работ и на каком основании вы формулируете собственную задачу. Библиографический список сообщает, какие документы использованы; обзор связывает их содержание в аргумент.
 Наука
7
мин
27.10.2026
Чужой страх на своей карте: гиппокамп крысы помечает опасность, увиденную со стороны
Угол тротуара, обледеневший за ночь. Вы видите, как на нём поскальзывается незнакомец, и мозг ставит жирную зарубку: здесь опасно. Сами вы не падали, но карта места обновилась. Группа нейробиологов из Нидерландского института нейронаук под руководством Фредерика Мишона Линде проследила, как именно г
 Наука
5
мин
27.10.2026
Микроскоп с металинзой переключает фокус электрическим напряжением
Навести камеру одновременно на цветок у самого объектива и на горный хребет вдалеке невозможно — что-то обязательно останется размытым. С оптическими микроскопами та же беда: свет собирается в крошечное чёткое пятно, но лишь на одной глубине. Ткань чуть выше или ниже этого слоя выглядит мутной. Южно