В файле пять временных меток: четыре со смещением UTC и одна без него. Нужно посчитать записи по дням в едином отчётном времени. Даты в исходных строках сравнивать напрямую нельзя: один момент может иметь разные календарные даты при разных смещениях.
Все записи и обстоятельства этого примера вымышлены. По учебному соглашению отчётное смещение фиксировано: UTC+03:00. Это выбранное условие проекта, а не утверждение о часовом поясе страны. Сырой файл сохраняем неизменным; в рабочей версии отдельно записываем UTC-метку, отчётную метку и статус уточнения.
Выбранное отчётное смещение и происхождение исходных меток запишите в описании пакета данных. Структуру такого описания показывает пример README для исследовательских данных.
Исходные данные и первая проверка
У нас пять исходных строк. После разбора четыре метки с явно указанным смещением дают объекты datetime типа aware. Строка E5 разбирается как naive: дата и часы есть, а смещение не определено.
ID
Исходная строка
E1
2026-10-26T22:30:00+00:00
E2
2026-10-27T01:30:00+03:00
E3
2026-10-27T00:15:00+03:00
E4
2026-10-27T00:20:00+00:00
E5
2026-10-27 01:30:00
Учебная схема, все метки вымышлены. Фиксированное +03:00 выбрано для этого примера; это не описание часового пояса страны. Совпадение момента не доказывает дубль события.
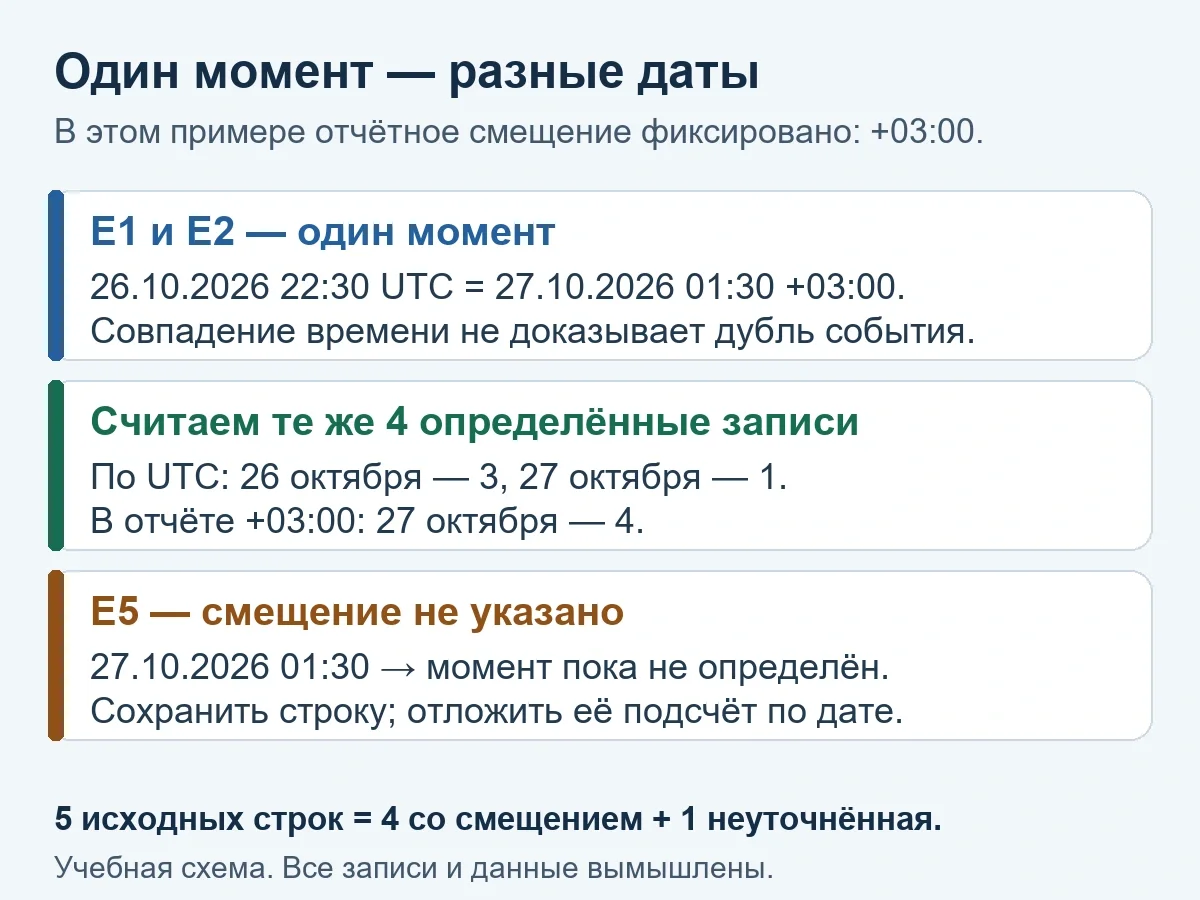
E1 и E2 обозначают один момент: 26 октября 22:30 в UTC и 27 октября 01:30 при смещении +03:00. Совпадение момента само по себе не доказывает, что строки являются копиями одной регистрации. Происхождение повторения в условии не задано; в этом примере обе строки сохранены и считаются как две записи, без вывода о числе уникальных событий.
E5 не имеет смещения. Пока это просто строка с датой и временем, которую нельзя однозначно привязать к шкале.
Переводим все определённые метки в UTC
Сначала приведём четыре строки с известным смещением к единой шкале UTC. Для этого просто вычитаем указанное смещение из местного времени.
ID
Метка UTC
E1
2026-10-26 22:30:00+00:00
E2
2026-10-26 22:30:00+00:00
E3
2026-10-26 21:15:00+00:00
E4
2026-10-27 00:20:00+00:00
E5
не определено
Подсчёт по UTC:
26 октября: E1, E2, E3 — три записи (E1 и E2 относятся к разным строкам, обе засчитываются)
27 октября: E4 — одна запись
E5 — не участвует
Итого по UTC: 3 записи 26 октября, 1 запись 27 октября, 1 запись без шкалы.
Переводим все определённые метки в отчётный UTC+03:00
Теперь ту же операцию проделаем для отчётной шкалы проекта, условно принятой за UTC+03:00 (это фиксированное смещение, не зависящее от сезонных переводов часов). Просто прибавляем три часа к UTC-моменту каждой записи.
ID
Метка в UTC+03:00
E1
2026-10-27 01:30:00+03:00
E2
2026-10-27 01:30:00+03:00
E3
2026-10-27 00:15:00+03:00
E4
2026-10-27 03:20:00+03:00
E5
не определено
Подсчёт по UTC+03:00:
26 октября: 0 записей
27 октября: E1, E2, E3, E4 — четыре записи
E5 — не участвует
Итого по UTC+03:00: 0 записей 26 октября, 4 записи 27 октября, 1 запись без шкалы.
Контрольные вопросы и типичные ошибки
Почему одни и те же четыре записи дают разное распределение по дням?
Потому что граница суток — искусственная линия, которая зависит от выбранной временной шкалы. В UTC запись E3 (26.10.2026 21:15 UTC) попадает на 26 октября, а в UTC+03:00 (27.10.2026 00:15) — уже на 27 октября. Ни одно из распределений не «правильнее» другого; они просто отвечают на разные вопросы: «когда это произошло по UTC» и «когда это произошло по нашему отчётному времени».
Что доказывает совпадение E1 и E2
Совпадение меток после перевода в UTC устанавливает равенство моментов, а не происхождение строк. Для решения об исключении записи нужны дополнительные сведения. До их получения в этом учебном подсчёте сохраняются и E1, и E2.
Что делать с E5?
Ставить её в любую из шкал без дополнительной информации — ошибка. Нельзя просто приписать E5 к UTC или к UTC+03:00, потому что без смещения мы не знаем, какой момент она обозначает. В нашем примере E5 остаётся с пометкой unknown и не участвует ни в одном из дневных подсчётов. Если в реальном проекте такие записи появляются, нужно вернуться к источнику данных и выяснить смещение.
Как это выглядит в Python и где подвох с naive
Согласно официальной документации Python, datetime является aware, когда tzinfo не равен None и utcoffset() не возвращает None. Если эти условия не выполнены, объект naive не задаёт однозначного момента. Метод astimezone() переводит определённый момент в другое смещение, сохраняя сам момент.
Для naive-объекта astimezone() предполагает системный часовой пояс. Это предположение программы, а не восстановленная информация об источнике E5. Поэтому до преобразования проверяем оба условия: dt.tzinfo is None или dt.utcoffset() is None. Такие строки откладываем для уточнения. Простая замена tzinfo через replace() также не выполняет перевод времени: без основания приписывать E5 смещение нельзя.
Ниже законченный пример для Python 3.12, проверенный на этих пяти вымышленных строках. Он отдельно учитывает ошибку разбора формата и успешно разобранную метку без смещения. Используются только модули стандартной библиотеки.
Код выводит только даты, для которых есть определённые записи: отсутствие 26 октября в словаре +03:00 означает нулевое число записей на эту дату в нашем наборе. E5 отложена как unknown. Ошибок разбора у этих пяти исходных строк нет; для иных входных данных они попадают в отдельный список invalid_format.
Что в итоге
Шкала
Подсчёт определённых записей
UTC
26 октября — 3; 27 октября — 1
+03:00
26 октября — 0; 27 октября — 4
Без смещения
E5 — 1 строка, отложена в обоих подсчётах
Количество записей по дням:
По UTC: 26 октября — 3, 27 октября — 1
По UTC+03:00: 26 октября — 0, 27 октября — 4
Неопределённых: 1 (E5)
Перед подсчётом зафиксируйте отчётное смещение, сохраните исходные метки и отдельно отметьте строки, требующие уточнения. Причину решения для E5 можно записать в журнале очистки данных. При подготовке собственного набора к исследованию можно обсудить помощь со статистическим анализом: заранее согласуйте исследовательский вопрос, состав файлов и объём консультации.