Четырнадцать фраз, нарочно набитых самыми трудными звуками крымскотатарского — къ, гъ, нъ, дж, — выглядят как честный экзамен для синтезатора речи. На них удобно сравнивать версии модели между собой. Но между этим экзаменом и чтением романа вслух лежит пропасть, и автор проекта «Ана юрт» показал её на числах: на проверочных фразах ошибка по буквам составила около 14 %, на обычной прозе первой главы — меньше 2 %. Модель за ночь лучше не стала. Изменился материал.
Об этом стоит поговорить отдельно, потому что вопрос здесь методический, а не новостной. Речь не о том, «что показал эксперимент», а о том, почему короткий тест в принципе не видит то, что проявляется на длинном тексте, и почему большинство найденных сбоев оказалось не в нейросети, а в обвязке вокруг неё.
Что это за работа и в каком она статусе
Первичный источник — авторский технический разбор на Хабре (автор под ником servinosm) и его более простая версия на сайте проекта «Ана юрт» от 9 октября 2026 года. Это третья статья серии. Первая, от 11 сентября, — общий замысел проекта и речевые технологии для крымскотатарского; вторая, от 23 сентября, — распознавание речи. Рецензирования здесь нет, DOI тоже нет, названия моделей, источники данных и внутренние скрипты автор сознательно не раскрывает. Так что перед нами не статья в журнале, а подробный инженерный отчёт с воспроизводимой методикой, но без возможности независимо повторить замеры по публикации.
Материал — роман Шамиля Алядина «Merdiven» («Лестница»): 16 глав, 15 444 слова, 1 час 58 минут звучания. Голос синтезированный, тембр взят из семисекундного образца записи. Текст книги подлинный.
Как устроен прибор и в чём его слепые пятна
Основной измеритель — обратная вычитка. Предложение синтезируется, полученный звук прогоняется через собственную систему распознавания речи, а результат сравнивается с текстом, который подавался на вход синтезу. Считается CER — доля правок на символ эталона. Важная деталь: по главе CER корпусный, то есть сумма правок делится на сумму символов эталона, а не усредняется по клипам. Это защищает от ситуации, когда одна короткая реплика с абсурдным числом ошибок перекашивает всю оценку.
Слепые пятна прибора автор называет заранее: он не слышит ударения и вдохи, не умеет проверять числа, и сам является моделью, у которой бывают сбои. Всё это приходилось закрывать живым прослушиванием.
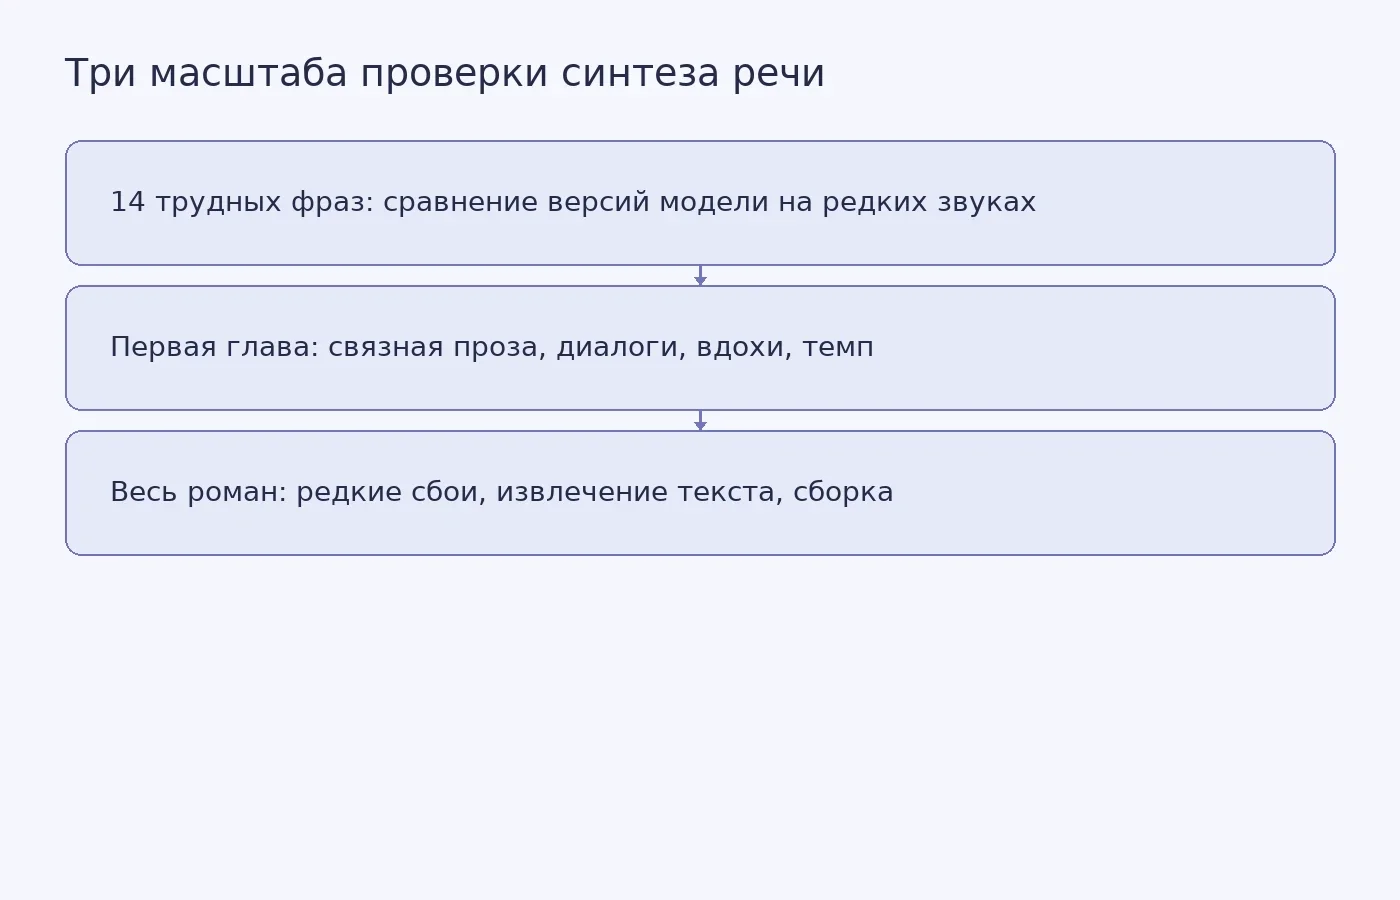
Проверка шла на трёх масштабах, и каждый рассчитан на свой класс ошибок. Четырнадцать специально подобранных трудных фраз показывают разницу между версиями модели на редких звуках. Первая глава — 1 608 слов, 195 предложений, около 12,3 минуты — показывает связную прозу: диалоги, короткие реплики, вдохи, темп. Весь роман — 16 глав, 15 444 слова, 118,4 минуты — показывает редкие сбои, извлечение текста из файла книги, сборку и устойчивость от главы к главе.
Отдельно автор проверил, не попал ли текст книги в обучающие материалы. Сравнивались словные 6-граммы, обе стороны перед сравнением сводились к общему грубому латинскому представлению. Первая глава: ноль совпадений из 1 545 шестисловных цепочек против примерно 1,38 млн слов учебного корпуса. Позже ту же проверку прошла вся книга: ноль из 14 656. Такая свёртка теряет различия только в сторону лишних совпадений, поэтому ноль у неё честный — но это проверка по одной конкретной процедуре, а не независимый аудит данных.
Почему 14 фраз не предсказывают поведение на романе
Причина не в том, что короткий тест плохой. Он годился для сравнения версий на трудных звуках. Проблема в том, чего он не проверяет вообще: связный текст, обработку коротких реплик, извлечение структуры книги, сборку аудио и разметку времени. Все эти слои просто отсутствуют в наборе из 14 фраз.
Самый наглядный случай — история с буквой дж. В первой статье серии автор рассказывал, как «нидже» машина прочитала как «ниже»: правило переписывания алфавита заодно превращало дж в ж, и модели буквально подавали русское слово. Чтобы починить, он сравнил пять способов записать этот звук. На 14 проверочных фразах два лучших варианта — обычное дж и татарская буква җ — были неразличимы: оба исправляли слово в трёх рендерах из трёх.
Тогда решение приняли на целой главе. Все 195 предложений переозвучили с каждым кандидатом и сравнили на сырых файлах, до обрезки, чтобы отличалось только написание. Результат: у дж 43 предложения стали лучше, 39 хуже, 113 не изменились — это шум, и от правки, которая чинит одно слово, большего не требуется. А җ исправлял злополучное слово и портил всю остальную главу: плюс 10 % относительных по WER и плюс 27 % по CER. Если бы решение принималось на проверочном наборе, автор с равной вероятностью выбрал бы любой из двух вариантов.
Это и есть ответ на вопрос о предсказательности: короткий тест проверяет модель, а длинный текст проверяет весь конвейер. Ошибка, которая выглядит как дефект модели на фразах, на романе может оказаться следствием того, как текст нарезан, склеен или записан.
Что именно ломалось и где это сидело
Склейка коротких предложений. Логика казалась железной: самые короткие клипы в учебных записях длились 2,94 секунды, значит, реплику короче 43 кириллических букв лучше приклеить к соседней. Допущение не проверялось. В первом прогоне из 147 фрагментов 38 содержали больше одного предложения, и на них модель начала выбрасывать целые предложения. Пример из публикации: «Men yañılğanım. O, oca degil eken» («Я ошибся. Он, оказывается, не учитель») превратилось в «O, oca degil eken» («Он, оказывается, не учитель»). Склеенные фрагменты занимали 25 % символов главы и давали 43 % ошибок.
Когда допущение наконец проверили, обрыва на 43 буквах не оказалось: корзины 0–24 и 25–42 букв дали одинаковый CER, а улучшение шло примерно до 70 букв. Граница склейки была проведена не там, где проходит настоящий порог. И цена двух зол разная: штраф за короткие реплики стоит около 2 процентных пунктов CER на 15 % текста, а склейка стоила 3,3 пункта на 25 % текста и вдобавок теряла целые предложения.
Обрезка вдохов. Синтез иногда начинает фразу со вдоха, и автор написал обрезку, которая искала первый звонкий кадр, а глухие согласные до него считала вдохом. В результате срезалось начало слова: «Çañ qaqıldı» превращалось в «Qaqıldı». В 111 предложениях из 147 срез приходился внутрь первого слова. Новая обрезка смотрит на громкость: согласный тихий, но намного громче паузы перед ним.
Здесь важна не сама починка, а способ её проверки. Автор прогнал обе конфигурации текста со всеми тремя вариантами обрезки крест-накрест. CER первой главы: со склейкой и без обрезки — 2,13 %, со старой обрезкой — 2,57 %, с новой — 2,06 %; без склейки и без обрезки — 1,92 %, со старой — 2,41 %, с новой — 1,84 %. Старая обрезка хуже, чем никакой, в обоих режимах; новая лучше, чем никакой, тоже в обоих; отказ от склейки выигрывает в каждом столбце. Ни одна из двух починок не маскирует другую, и это видно только потому, что они мерились вместе, а не по очереди.
Вдохи, которых не было. Первая проверка сообщила, что вдохом начинается 131 предложение из 147, то есть 89 %. Цифра пугала, пока не выяснилось, что это обрезка отчитывалась сама о себе: вдохом она считала всё до первого звонкого кадра, то есть те же глухие согласные. Когда вдох определили как устойчивый слышимый шум перед словом и померили по уровню, их осталось 30 из 147 — один на пять предложений. Зато сканирование всей волны нашло вдохи между словами в 76 предложениях из 195, ровно там, куда ни один детектор до этого не смотрел. Их приглушили до уровня фона, не сдвигая ни одной отметки времени: 68 из 76 изменённых предложений распознаются байт в байт так же, как до приглушения.
Темп и паузы. Машина читает быстрее живого диктора: 17,4 кириллической буквы в секунду против 14,5. Глава, которую автор ждал на 14,9 минуты, уложилась в 12,3. Паузы между фразами он не придумывал, а померил у живого диктора на десяти минутах чтения: 129 пауз, медиана 288 мс, и только три за все десять минут длиннее 0,6 секунды. Отсюда 300 мс между предложениями, чуть больше при смене говорящего и ещё чуть больше между абзацами. Это фактические паузы, а не вставки: у каждого клипа по краям уже есть своя тишина, поэтому сборщик меряет её у обоих соседей и добивает только разницу.
Итог по первой главе: CER 1,84 % вместо 2,56 % в первом прогоне. Модель та же самая. Изменилось только то, что ей подавали, и то, что делали со звуком после.
Что нашлось только на масштабе книги
Остальные пятнадцать глав шли через тот же конвейер, по главе за раз: синтез, сборка, чистка вдохов, разметка слов по времени, выборочная проверка отметок с контролем, полная обратная вычитка и упаковка для читалки. Целая книга нашла то, чего не нашла одна глава, и всё это оказалось в извлечении текста.
Три звёздочки, которыми в книге разделены сцены, уходили модели как текст, и она их честно «читала». Последний абзац романа, авторскую дату «1940 s.», фильтр пропустил, потому что это не голое число, и роман заканчивался произнесённым вслух годом. Пять предложений рвались пополам там, где абзац обрывался на многоточии и продолжался в следующем.
Отдельная история — сборка, которая отказалась собирать. У формата читалки есть контракт: слова предложения, склеенные обратно через одиночный пробел, обязаны давать исходный текст предложения байт в байт. Сборщик проверяет это для каждого предложения и при нарушении ничего не пишет. В седьмой главе он отказался: в файле книги внутри одного предложения стоял двойной пробел. Со звуком всё было в порядке, на экране тоже ничего не было бы видно, но читалка, которая рисует текст по словам, молча потеряла бы этот пробел. Чинили в источнике: извлечение теперь схлопывает пробелы, и седьмую главу переозвучили с исправленного текста. Это был второй раз, когда программа, отказавшаяся работать, нашла то, чего никакое прослушивание не нашло бы.
Когда прибор врёт: четвёртая глава
Каждую главу проверяли отдельно, и одна выглядела плохо: CER четвёртой главы 8,28 %, вчетверо выше медианы по книге. Автор пошёл слушать, и глава оказалась нормальной. Всю ошибку дала одна реплика из двух слов, «– dep tüşündi.»: проверяющая распознавалка зациклилась и записала её двадцать пять раз подряд, CER одного этого клипа 30,7, то есть больше трёх тысяч процентов. Без него у главы около 2 %, как у всех. Та же реплика подвела проверку и во второй главе (4,44 % → 2,50 %), и ещё один такой сбой был в тринадцатой.
Ошиблась не читающая машина, а проверяющая, и как раз на очень коротком клипе. Поэтому по книге автор публикует распределение по главам, а не одно среднее. Без зацикленных клипов: медиана 2,15 %, лучшая глава 1,51 % (третья), худшая 2,70 % (четырнадцатая), разброс меньше чем в два раза. Ни к концу книги, ни с длиной главы качество не плывёт. Самая длинная, вторая глава, звучит девятнадцать с половиной минут и читается с CER 2,50 %.
Это ограничение метода, а не свойство модели: обратная вычитка сама является моделью, и на коротком входе она может сорваться. Автор прямо пишет, что слепые пятна прибора известны заранее, и что часть находок пришлось закрывать ухом.
Что осталось в самой модели
Свести все проблемы к обвязке было бы неправильно, и автор этого не делает. Он отдельно описывает ударение. Имя «Риза» машина иногда читает как «Рыза»: проверка на восьми разных предложениях для каждого имени подтвердила, что «Риза» уходит в заднюю гласную в 4 предложениях из 8, «Азиз» — в 5 из 8, в контрольных предложениях ни разу из 16 (точный тест Фишера, p = 0,0066 и 0,0013). У «Сабри» и «Дилявера» дефекта нет совсем.
Нашлась починка: писать на входе «ий» вместо «и». Задняя гласная после этого пропадала полностью, ни одного случая из 16 на каждое имя, а CER самого имени падал: у «Ризы» с 0,125 до 0,103, у «Азиза» с 0,300 до 0,169. Приборы были довольны. Автор послушал вслепую и не принял: счёт вышел 4 : 3 в пользу того, что было, то есть монетка, а в заметке к слепой странице он написал, что если слышит И, то ударение неверное. Починка возвращала правильную гласную и при этом утаскивала ударение на первый слог, а в языке оно на последнем. Обе версии были неправильными, каждая по-своему.
Дальше он стал мерить само ударение, а не гласную. В языке последний слог слова обычно немного тянется, причём у живых дикторов одни слова тянутся сильно, а другие почти никак. Чтобы сравнение было честным, модель читала те же предложения из учебных записей, что и дикторы, так что у каждого слова есть человеческая пара с тем же текстом. В среднем модель тянет последний слог столько же, сколько люди: 1,143 против 1,156 по 125 парам, p = 0,33. На этом можно было остановиться с выводом «всё в порядке», и это был бы неверный вывод. Регрессия растяжения у модели на растяжение у людей по 22 ячейкам «слово × позиция во фразе» (в логарифмах) даёт наклон 0,556 ± 0,115. Модель воспроизводит только около шести десятых человеческого размаха: недотягивает как раз те слова, которые дикторы тянут сильнее всего, и перетягивает плоские. Дефект не в среднем, а в сжатии.
Автор по очереди исключил подозреваемых. Образец голоса меняет только общий темп, на растяжение не влияет. В учебных данных зависимость есть: внутри записей люди следуют норме слова с наклоном 0,938, то есть учиться было у кого. Настройки декодирования — две ручки, гасящие разброс, — крутились в обе стороны: наклон в пределах шума, зависимости от дозы нет, контроль совпал с релизом байт в байт, 375 из 375 рендеров. Исходная модель без адаптера так же ровная, то есть адаптер этого не создал и не исправил. Остался следующий подозреваемый: то, как модель заранее отмеряет длину всей фразы. Для одного и того же текста общая длина рендера от сида к сиду меняется всего на 0,46 %. Худшей ячейке не хватает примерно 69 мс на последнем гласном, это около 1,4 % пятисекундной фразы, втрое больше всей свободы, которую оставляет такой бюджет. Если длина задана наперёд, удлинить последний слог можно только за счёт соседних. Автор называет это гипотезой и пишет, что проверять её — уже работа с самой моделью, а не с текстом на входе.
Вдохи тоже остаются проблемой. Чистка вдохов ни разу ничего не ухудшила: на слепой странице 8 ничьих, 2 в пользу очищенного варианта, 0 против. Но короткие вдохи по 60–120 мс чистка достаёт плохо, 42 % из них остаются. Больше всего вдохов у голоса самого автора: в одном замере 15,5 % звучания против 1,0 % у голоса Sevil. Обрезка тишины в образце сама по себе сократила долю вдохов больше чем вдвое, с 12,1 % до 5,1 %, но не до нуля.
Паузы на эмоциональных репликах оказались не связаны с эмоциональностью: проверка на 27 предложениях в трёх корзинах, уравненных по длине и числу знаков препинания, по 6 сидов на каждое, дала ρ = +0,076, p = 0,70. Паузы следуют за длиной предложения (ρ = +0,886) и числом знаков препинания внутри него (ρ = +0,658), а эмоциональные фразы в прозе просто чаще длиннее и богаче запятыми. Двадцать семь предложений исключают сильный эффект; чтобы поймать слабый, понадобилось бы около 85. Автор оговаривается, что померить удалось только общую длину пауз, а не то, где они стоят, а пауза не на месте в восклицании режет слух сильнее, чем та же пауза у запятой.
Диалоги и числа тоже остаются открытыми. Тире перед репликой модель видит, но смену говорящего читает как новое предложение, а не как новый голос; разницу пока несёт только чуть более длинная пауза. Числа заранее превращаются в слова, но проверить их прочтение обратной вычиткой нельзя: распознавалка записывает услышанное цифрами, и «1924» возвращается как «19124». Числа пока проверяет только ухо.
Что из этого следует для читателя
Главный методический вывод автора простой: проверочный набор годится для сравнения версий, но решение, что катить, он теперь принимает на целой главе. Причина не в том, что фразы плохие, а в том, что они не нагружают слои, где живёт большинство ошибок длинного текста: нарезку на предложения, склейку коротких фраз, обрезку вдохов, извлечение текста из файла книги и разметку времени.
Второй вывод — про защиты, которые умеют отказаться работать. Двойной пробел в седьмой главе не нашло бы никакое прослушивание: на слух и на экране всё было в порядке. Нашла проверка целостности текста для читалки. Похожая логика стоит за контролем разметки: сборка сравнивает конец последнего предложения с длиной звукового файла и отказывается работать, если они расходятся больше чем на полсекунды. Эта защита появилась после истории, в которой разметка к концу главы разъехалась на 44 секунды, причём со звуком всё было в порядке — один и тот же таймлайн независимо считали два куска кода, и один из них учитывал собственную тишину клипов дважды.
Третий вывод касается того, как вообще оценивать такие системы. CER по обратной вычитке насыщается рано: в предыдущей статье серии автор показал, что разборчивость перестаёт улучшаться примерно на шести часах данных, тогда как просодия продолжает расти, а слепое прослушивание каждый раз выбирает более новый голос. Метрика останавливается ровно там, где начинается остаток качества. Человек, который посмотрел бы на ту таблицу и прекратил сбор данных на шести часах, сообщил бы чистую правду и принял неправильное решение.
И последнее, что стоит держать в голове при чтении любых подобных отчётов. Это авторский разбор одного романа с ровной повествовательной прозой, одного голоса и одного конвейера. Он не устанавливает, насколько выводы обобщаются на другие жанры, голоса и языки. Названия моделей, источники данных и внутренние скрипты не раскрыты, поэтому независимо повторить замеры по публикации нельзя. Проверка на утечку по 6-граммам подтверждает отсутствие найденных совпадений по указанной процедуре, но сама по себе не является независимым аудитом обучающих данных. И между деталями связанных публикаций есть различия в округлении: длительность первой главы приводится как 12,3 минуты в одной версии и как 12 минут 21 секунда в другой. Это совместимые значения с разной точностью, а не содержательное расхождение, но и не два независимых подтверждения одной цифры.
Сам автор заканчивает тем, что голос оказался самой надёжной частью всей цепочки, а почти всё, что ломалось, сидело в подготовке текста и звука вокруг модели. Часть этого нашли приборы, и ухо не нашло бы её никогда. Часть нашло ухо, и прибор не умел её даже оценить. А книгу целиком не заменили бы ни 14 фраз, ни одна глава. Если вам интересно, как в подобных работах вообще формулируют границы вывода и отделяют результат от интерпретации, об этом есть отдельный разбор о том, как писать критический анализ научной статьи.