


Содержание статьи
Полезные материалы
18.10.2026
18.10.2026
8
мин
Шесть виртуальных процессоров в тарифе хостинга звучат как хороший запас. Но в тесте русскоязычного распознавания этого ресурса хватило лишь на четыре-пять аудиодорожек. Результат зависел и от способа распараллеливания модели. На другом сервере тот же чанк обрабатывался в несколько раз быстрее. Этот пример показывает, почему число vCPU само по себе не говорит, подойдёт ли сервер для живых субтитров.
Инженер под псевдонимом Denizen24 опубликовал на Хабре собственный бенчмарк открытых моделей T-one, GigaAM-v3 и Vosk, а также сравнил их с облачным Deepgram. Это не рецензированное исследование, а технический разбор с открытым кодом и описанием стенда. Его стоит читать не как рейтинг распознавателей, а как проверку конкретной задачи: смогут ли две дорожки русской речи обрабатываться на CPU с задержкой, приемлемой для разговора?
Как автор проверял нагрузку
Автор рассматривал узкий практический сценарий: звонок один на один, в котором у каждого участника свой микрофонный канал. Он хотел, чтобы готовая фраза появлялась не позднее чем через две секунды после произнесения, а аудио оставалось на сервере в России. T-one проверяли как потоковую модель с чанками по 300 мс. GigaAM-v3 использовали в пакетном режиме, Vosk взяли для сравнения, а Deepgram стал облачным ориентиром.
Замеры провели на двух CPU-серверах, но по разным схемам. На машине A с Xeon и AVX2 измеряли только акустическую модель, без разделителя и декодера. На машине B, Xeon E5-2680 v2 без AVX2, проверяли полный тракт: акустическую модель, разделение по паузам и декодирование. Поэтому число дорожек, которое выдержала каждая машина, нельзя считать прямым сравнением производительности готового сервиса.
На машине B автор сопоставил пакетную обработку нескольких дорожек одним вызовом с режимом, где каждой дорожке выделяли отдельный рабочий поток. Каждую нагрузку измеряли минуту после шести секунд прогрева. Сервер считался выдержавшим её, если 95-й процентиль времени тика оставался меньше 300 мс, а накопленное к концу минуты отставание не превышало секунды. Этот критерий проверяет устойчивость потока, а не только среднюю скорость обработки одного чанка.
Код зонда, стенда и оценки качества опубликован в репозитории stt-lab. В описании оценки качества автор различает вручную вычитанный эталон и псевдоэталон, то есть текст другого распознавателя. Это важное различие: от него зависит, что именно означают проценты ошибок.
Процессор важнее цифры в тарифе
На Xeon с AVX2 один чанк занимал 44 мс при одном потоке ONNX Runtime. На Xeon E5-2680 v2 без AVX2 тот же замер дал 109–117 мс. Разница сохранилась и при нескольких потоках: 12 мс на машине A с восемью потоками против 60 мс на машине B с тремя. Это результаты двух конкретных систем, а не универсальная оценка влияния AVX2 на любые модели и серверы.
На старом процессоре увеличение числа потоков не ускорило обработку. Шесть потоков ONNX Runtime оказались медленнее трёх: 64 мс против 60 мс на чанк. Автор предположил, что виртуальные процессоры могли соответствовать трём физическим ядрам с гиперпоточностью, а ограничение могло быть связано с общей кэш-памятью. Замер показывает разницу во времени, но не устанавливает её причину.
Заметно влияла и схема распараллеливания. В пакетном режиме машина B выдержала две дорожки. Отдельные рабочие потоки позволили обработать пять, но нагрузка в шесть дорожек уже не прошла по критерию задержки. С KenLM, языковой моделью для декодирования, предел составил четыре дорожки. В этом опыте настройка потоков влияла на практическую ёмкость не меньше, чем число виртуальных процессоров.
При двух дорожках потоковый сервис на T-one показал 95-й процентиль времени тика 272 мс. Готовые фразы появлялись примерно через 1,08–1,2 секунды. По критерию автора это укладывается в предел двух секунд. Но модель выдавала фразы после пауз, без промежуточных гипотез для каждого слова. Тест поэтому не подтверждает, что такой режим подойдёт интерфейсу, которому нужен текст по мере произнесения.
Скорость и качество отвечают на разные вопросы
На 29-минутной записи диалога автор сравнил модели с расшифровкой Deepgram nova-3. Для клиентской дорожки расхождение составило 8,1% у GigaAM-v3 и 10,6% у T-one с KenLM. Для дорожки ведущей показатели составили 19,1% и 24,5%. Их нельзя считать строгой долей ошибок относительно текста, проверенного человеком: эталоном служил вывод Deepgram, а его нулевой показатель задан самим способом сравнения.
Автор описал несколько причин, по которым оценки могли сместиться. На дорожку ведущей попадал голос клиента из динамиков, из-за чего распознаватели добавляли лишние фрагменты. В некоторых местах T-one и GigaAM расходились с Deepgram одинаково, так что ошибаться мог и облачный движок. Автор подготовил список спорных мест для прослушивания, но подчёркивает: без полной проверки записи точность оценок остаётся ограниченной.
Режимы работы важны и для сравнения скорости. В этом опыте GigaAM-v3 обрабатывала запись пакетами: короткую не успевала распознать в реальном времени, а длинную обрабатывала медленнее, чем она звучала. На проверенном сервере модель могла подойти для расшифровки после встречи, но не для живых субтитров. T-one, напротив, тестировали в потоковом сервисе. Сравнивать модели так, будто обе работали в одинаковом онлайн-режиме, было бы неверно.
В разборе локального бенчмарка языковых моделей тоже рассматривается, почему результат теста зависит от аппаратной конфигурации и выбранной метрики. Здесь тот же общий принцип проявляется в другом месте: скорость чанка, задержка фразы и сходство с облачной расшифровкой описывают разные стороны системы, и ни одна цифра не заменяет остальные.
Что можно вынести из этого кейса
В этом сценарии локальный CPU-сервис показался автору рабочим вариантом при умеренной нагрузке, допустимой задержке около секунды и требовании не отправлять аудио за пределы сервера. Облачный API проще для небольшого числа часов и может быть удобнее, если важны пунктуация и готовый результат без самостоятельной эксплуатации. Однако финансовый расчёт в статье условный: автор не измерял характеристики процессоров в тарифах и не учитывал разработку, поддержку и резервирование.
Бенчмарк не доказывает, что локальная модель лучше облачной. Для такого вывода недостаточно одного сервера, нескольких тестовых записей и эталона, основанного на выводе Deepgram. Кейс показывает, что перед расчётом затрат или планированием числа одновременных звонков стоит проверить конкретный процессор, способ распараллеливания и полный тракт обработки на собственном аудио. Открытый код позволяет повторить проверку, но опубликованные файлы с результатами ещё не означают, что замеры кто-то независимо воспроизвёл.
Источники
- Denizen24. «Открытые модели против облака: T-one, GigaAM или Deepgram: что реально тянет обычный CPU для живых субтитров в звонке». Хабр, точная дата публикации в доступном тексте не указана. Полный текст.
- denizen24. Репозиторий stt-lab: код стенда, зонда и прототипа потокового сервиса. Включает описание оценки качества и файлы результатов и описание машины. Инженерные материалы, не рецензированная научная публикация.
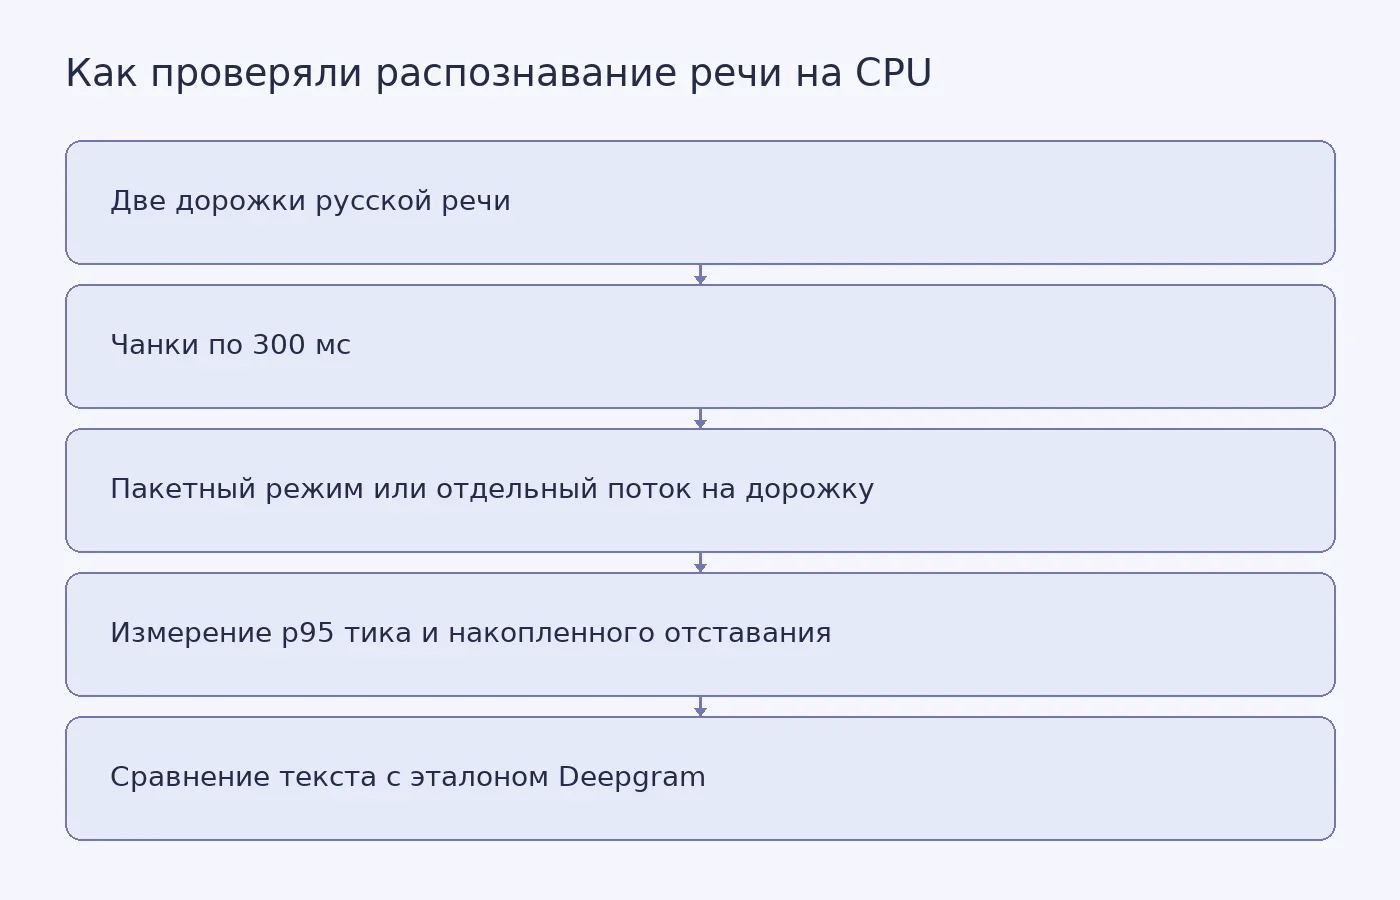
Фото: RDNE Stock project / Pexels


Похожие статьи
 Полезные материалы
18
мин
01.10.2026
Что на самом деле измеряют бенчмарки ИИ: конвергентная и дискриминантная валидность против посторонних навыков
Вопрос о том, измеряет ли бенчмарк предвзятость и безопасность модели или посторонний навык вроде понимания текста, в 2026 году перестал быть риторическим. Две работы переносят в оценку ИИ аппарат психометрики — науки об измерении человеческих способностей, — и показывают, что часть популярных тесто
 Полезные материалы
25
мин
11.10.2026
Синтез речи на длинной дистанции: что ломается при чтении целого романа
Четырнадцать фраз, нарочно набитых самыми трудными звуками крымскотатарского — къ, гъ, нъ, дж, — выглядят как честный экзамен для синтезатора речи. На них удобно сравнивать версии модели между собой. Но между этим экзаменом и чтением романа вслух лежит пропасть, и автор проекта «Ана юрт» показал её
 Полезные материалы
10
мин
12.10.2026
Что такое «сексспан» и почему он не доказывает, что секс продлевает жизнь
В популярных текстах слово «сексспан» иногда ставят рядом с продолжительностью жизни и здоровым долголетием. Обычно так называют период, в течение которого человек сохраняет удовлетворяющую сексуальную жизнь. Но между наблюдением «люди в лучшем состоянии здоровья чаще остаются сексуально активными»
 Полезные материалы
12
мин
04.10.2026
Курс Understanding Dementia: от изменений мозга к уходу и жизни в сообществе
Человек снова задаёт один и тот же вопрос, теряется в знакомом месте или перестаёт участвовать в привычном занятии. Для семьи это важное наблюдение, но ещё не диагноз. Между первыми изменениями поведения, медицинским обследованием и повседневной помощью возникает множество вопросов: что происходит с
 Полезные материалы
15
мин
03.10.2026
Почему подбор кодов помещений упирается в разногласия проектов, а не в метрику сходства строк
В жилом доме сотни помещений, и в модели они называются так, как привыкла мастерская: «С/у», «Кладовка», «ПУИ/Мусороудаление (К1)», «Элетрощитовая жилой части». С 2026 года архитектурно-градостроительное решение в Москве сдаётся вместе с цифровой информационной моделью в IFC, и у каждого помещения д
 Полезные материалы
13
мин
13.10.2026
Почему научному ИИ мало находить закономерности: ему нужно проверять гипотезы
Представим два научных запроса. В первом модель получает последовательность белка и предсказывает его форму, опираясь на большой архив экспериментально определённых структур. Во втором исследователь спрашивает: какую гипотезу проверить дальше, какие объяснения уже предложены и какой опыт позволит ра
Последние новости и статьи
 Полезные материалы
7
мин
18.10.2026
Как конденсатор заменяет резистор: вскрываем фильтр Harris HF-10
На кристалле старого фильтра Harris HF-10 видна сетка из 72 одинаковых квадратных конденсаторов. Зачем аналоговой микросхеме столько маленьких ёмкостей, если ток обычно задают резисторы? На кристалле резисторы занимают много места, а их параметры трудно точно контролировать. В MF10 и совместимом с н
 Полезные материалы
12
мин
18.10.2026
Фукоидан из бурых водорослей: что исследования говорят о защите тканей
В новостном пересказе фукоидан уже почти готов стать медицинским материалом: вещество из бурых водорослей будто бы защищает печень, почки, кишечник и кожу, а затем может попасть даже в повязки для заживления ран. Между такой перспективой и доказанным лечением, однако, есть несколько промежуточных ст
 Полезные материалы
7
мин
18.10.2026
Манхэттен за восемь минут: что показывает и скрывает трёхмерная история острова
Восемь минут длятся достаточно долго, чтобы один и тот же остров успел предстать в нескольких исторических образах. В редакционном описании Aeon Манхэттен проходит путь от родины народа Ленапе к небольшой голландской колонии, затем к месту боевых действий Американской революции, индустриальному горо
 Наука
4
мин
17.10.2026
Почему авиационные планы не укладываются в экологические пределы
Исследователи во главе с Бастьеном Паи проверили, укладываются ли планы по сокращению выбросов мировой гражданской авиации в планетарные границы. В статье, опубликованной 13 октября 2026 года в журнале Nature Communications, они сравнили сценарии развития отрасли до 2050 года. Ни один из них не собл
 Наука
3
мин
17.10.2026
Роборука EmArm чувствует прикосновения по всей длине и меняет маршрут
Исследователи Гонконгского университета науки и технологий представили роборуку EmArm с мягкой тактильной кожей на верхней и нижней частях руки. В статье, опубликованной в журнале Nature Sensors 20 июля 2026 года, они описали, как робот определяет место и силу прикосновения, выдерживает нагрузку и м
 Наука
2
мин
17.10.2026
Как стрессовый сигнал от бурого жира может вызвать обострение артрита
Исследователи Университета Тиба и двух японских больниц изучили, как стресс может сопровождаться возвращением воспаления суставов. Результаты опубликовали 16 октября 2026 года в журнале Science Advances. Механизм проверяли на мышах, а у людей с ревматоидным артритом исследовали связь воспринимаемого